还有一些错误,懒得修复了,工程太大了,内容基本全部涵盖了,就是排版的问题
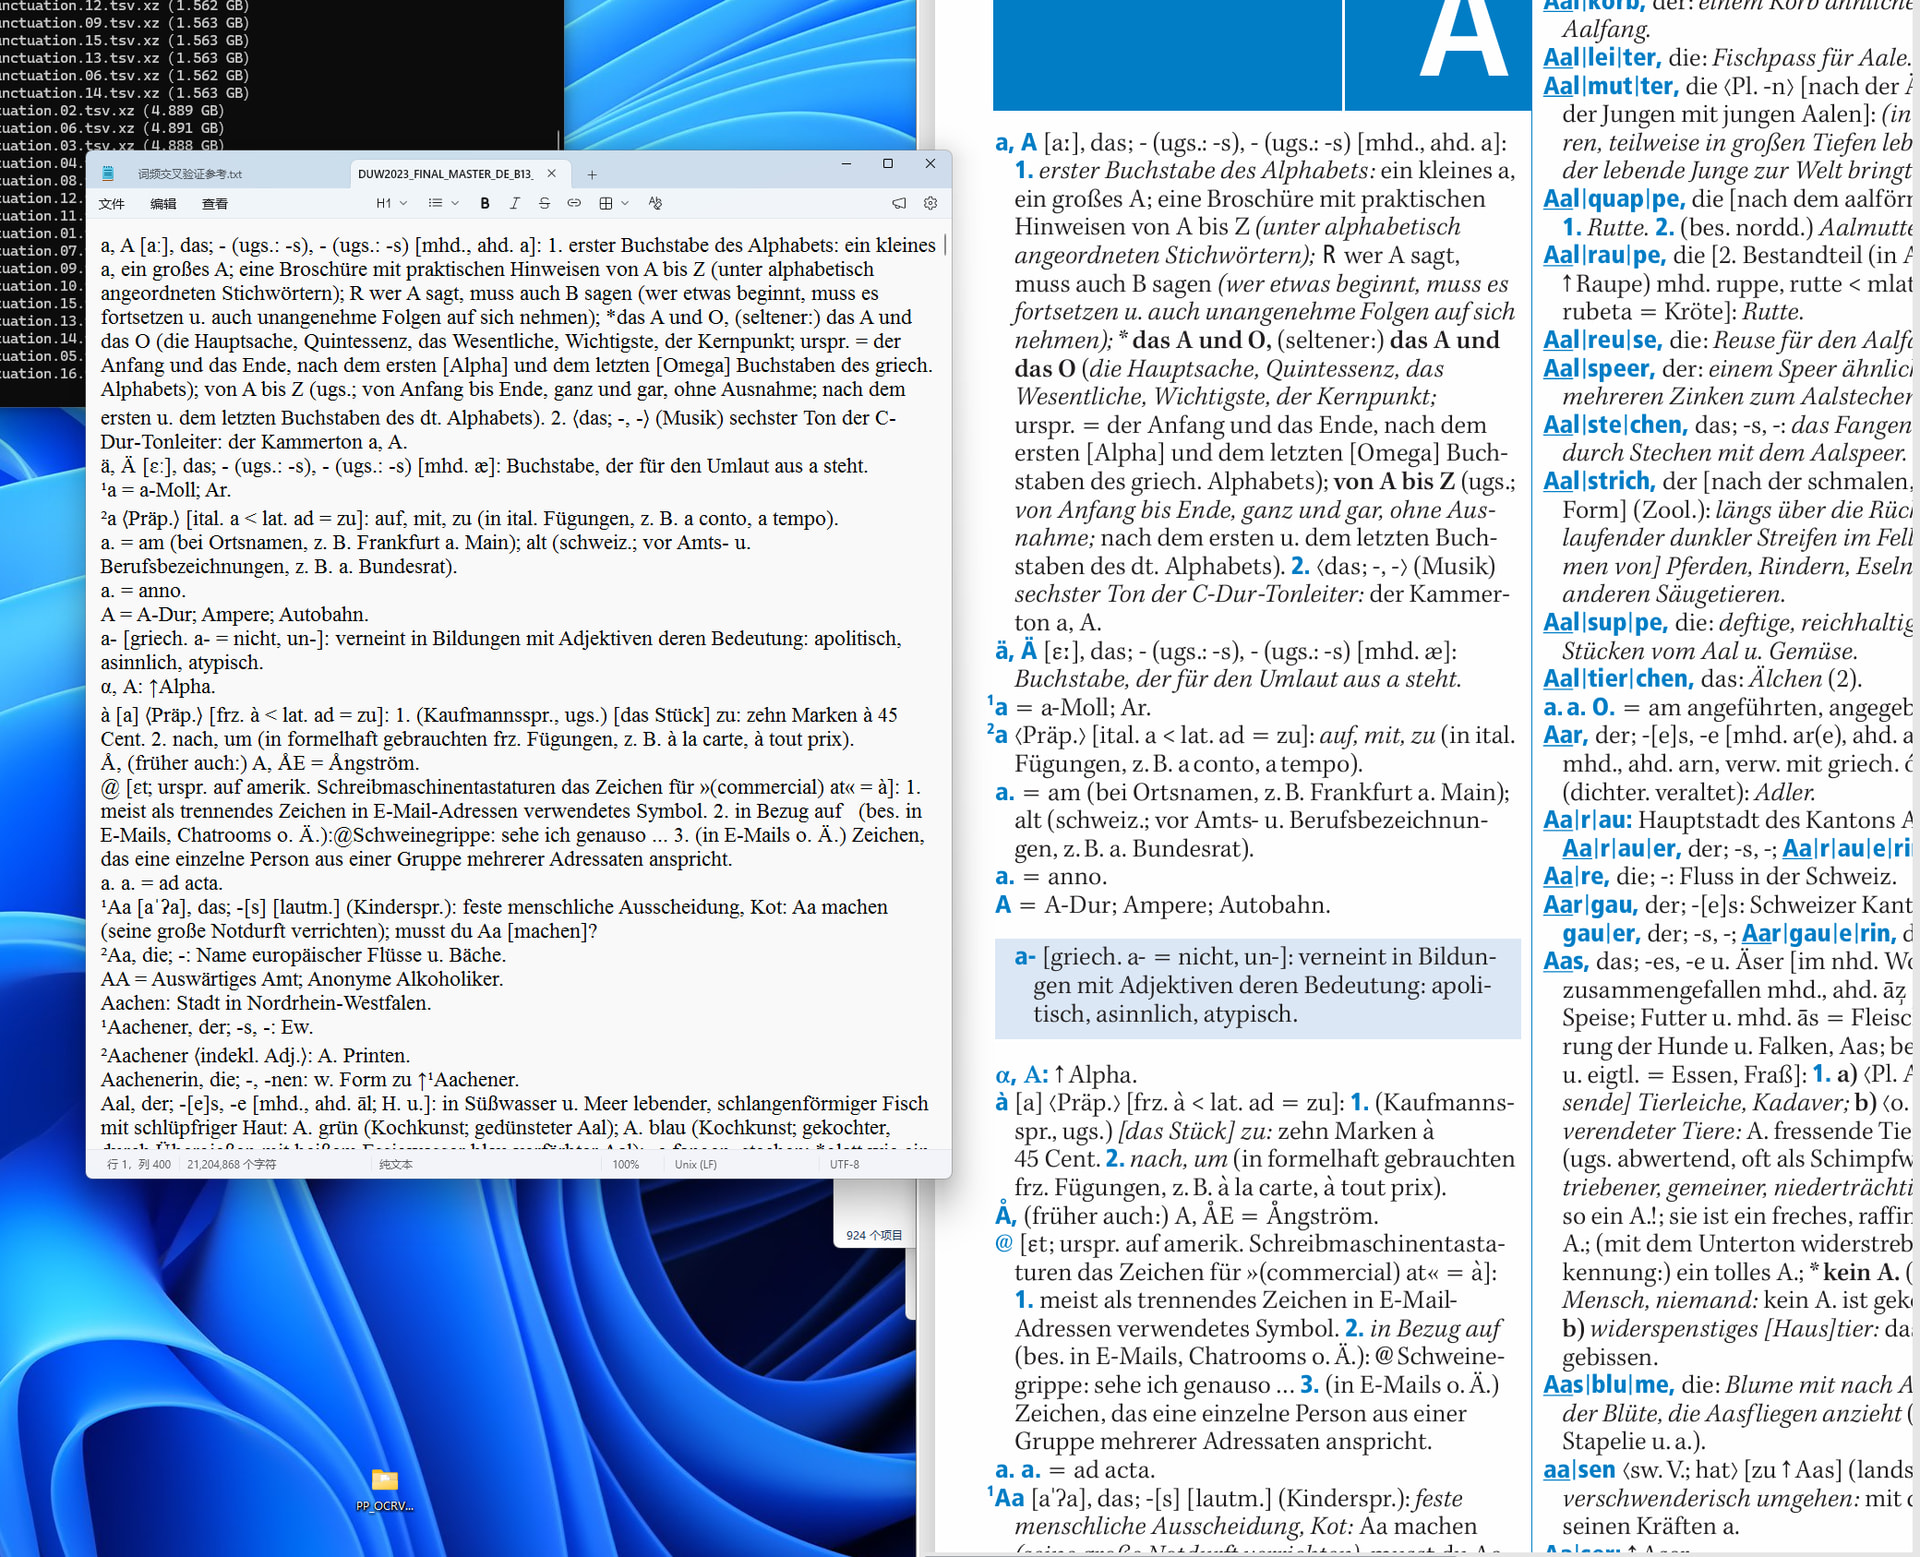
还有一些错误, 懒得修复了, 工程太大了, 文本内容基本全部涵盖了, 高度可用, 词条基本涵盖了,有一些断行还没有修复,错别字,音标,字符什么的
用PP-OCRv6 Small, PP-OCRv6 Medium TensorRT FP32, Tesseract Best/deu三个模型校对的
原版pdf太垃跨了,谁能提供超高清的词典图片,理论上我可以100%所有细节都可以复刻,包括斜体,粗体
duden 2023词典最新版也基本已经完成txt文本转换,这个比新德汉词典情况好太多
新德汉词典TXT.zip (5.8 MB)
新德汉词典HTML.7z (14.9 MB)