下载:
汉语成语源流大辞典.zip (11.0 MB)
谢谢制作。
边使用、边反馈使用中发现的问题
太牛了兄弟。能不能搞个文字图片综合版啊?这个《成语源流大词典》收词太牛叉了。
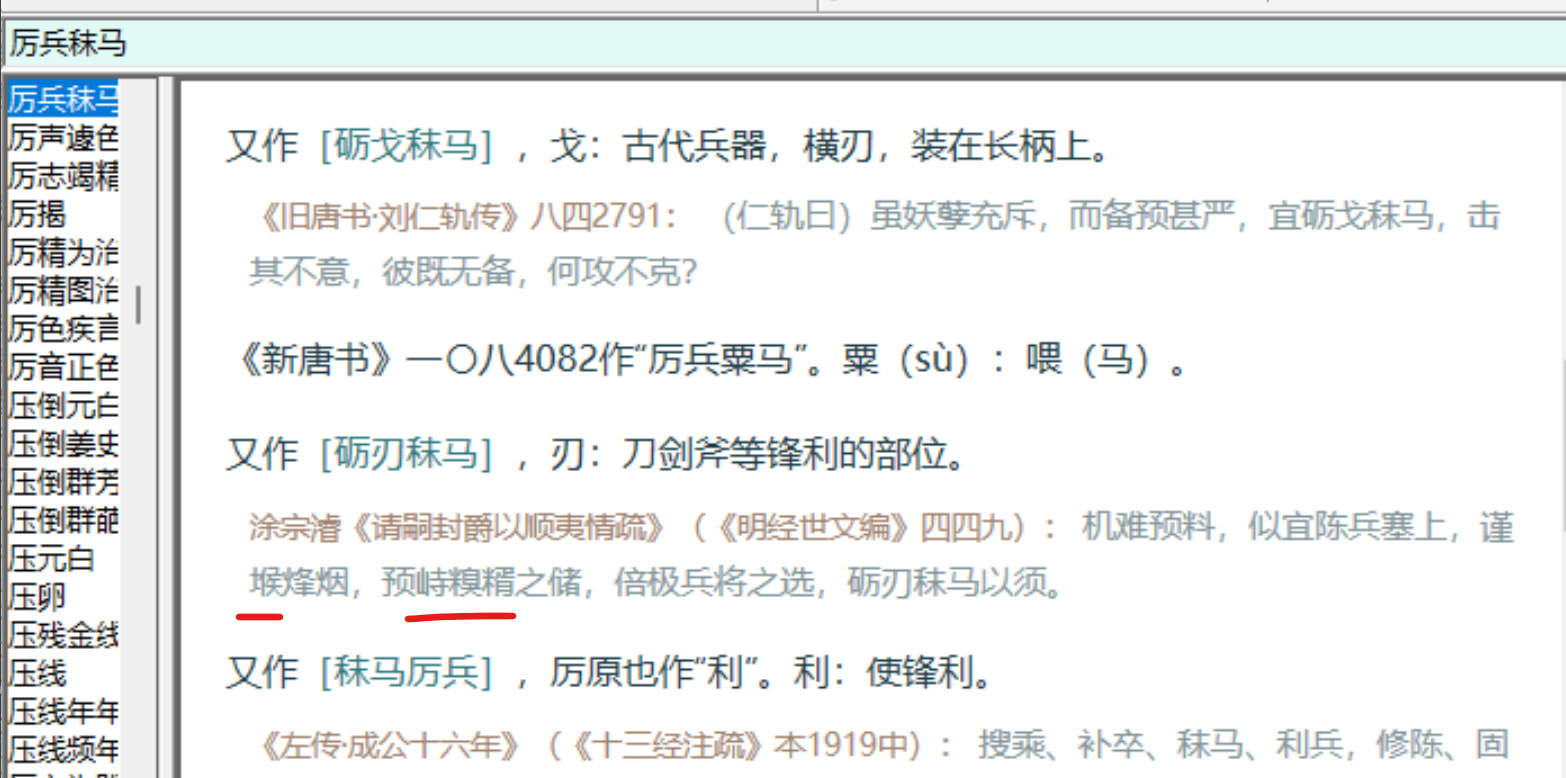
生僻字也是ai核对的吗,我之前试现代汉日辞海,发现ai生僻字会认错,容易把对的改错。
gpt 6 astra校改生僻字很专业,除了查看原始图片,还会生成很多近似字来比对,但额度消耗太厉害了,我现在通常用gpt 6.1 sol。
这是原来OCR的版本,又用AI校核的?
我没有用别人的版本,从零开始让AI自己做的。
@endnote 这是我做生僻字识别的skill,欢迎使用,无版权限制,可以自由上传GitHub。
rare-hanzi-source-proofreading.zip (11.0 KB)
麻烦请教阁下用的是什么模型,如果是sol还好,astra就受不了了
拆包看起来,有些词汇是没有收录的(飞走斝),有错误( 冬温夏清),有些有但是没成为词头(卬首信眉)。可以让AI收录下帖主的校对
制定方案用astra,执行用sol,子agent用luna。目前AI核对是做不到完全正确的,等明年AGI实现了估计就能接近完美了。
astra我一般只用来写代码或者生成一些复杂的排版格式,校对几百万字的文本太费额度了,sol日常校对没问题
和我用的方法不同,我之前是让ai把SimSun-ExtG全部rasterize成图片,然后和原书对比,找到相似度最高的,实际很多情况下正确的字排不到第一位,还需要人工核对一遍。另外我不是从头让ai处理的,而是用带每个词bbox的chrome lens ocr文本为基础让ai在这个和另一个文本的基础上校对的。
这种大部头,人工校对基本不可能,而且错误也未必一定能校出来。AI校对是必行之路。
人工校对只能Wiki分包+专家把关+版本留查。我还是相信人机协作,纯AI难以对付庞大的汉字生僻字异体字
是人工只校对疑难字,其他给ai校对,我现在处理其他词典普通ocr无法解决的问题都是先标注一部分数据,然后让ai训练专用模型处理的
从体量上来说,汉字本身就是非常小的,就算用新字海的收字量来看也才30万左右,AI处理起来非常轻松的,只是没有人专门去训练这一块而已。