有人可以帮忙整理按照原始顺序排列的索引表吗?
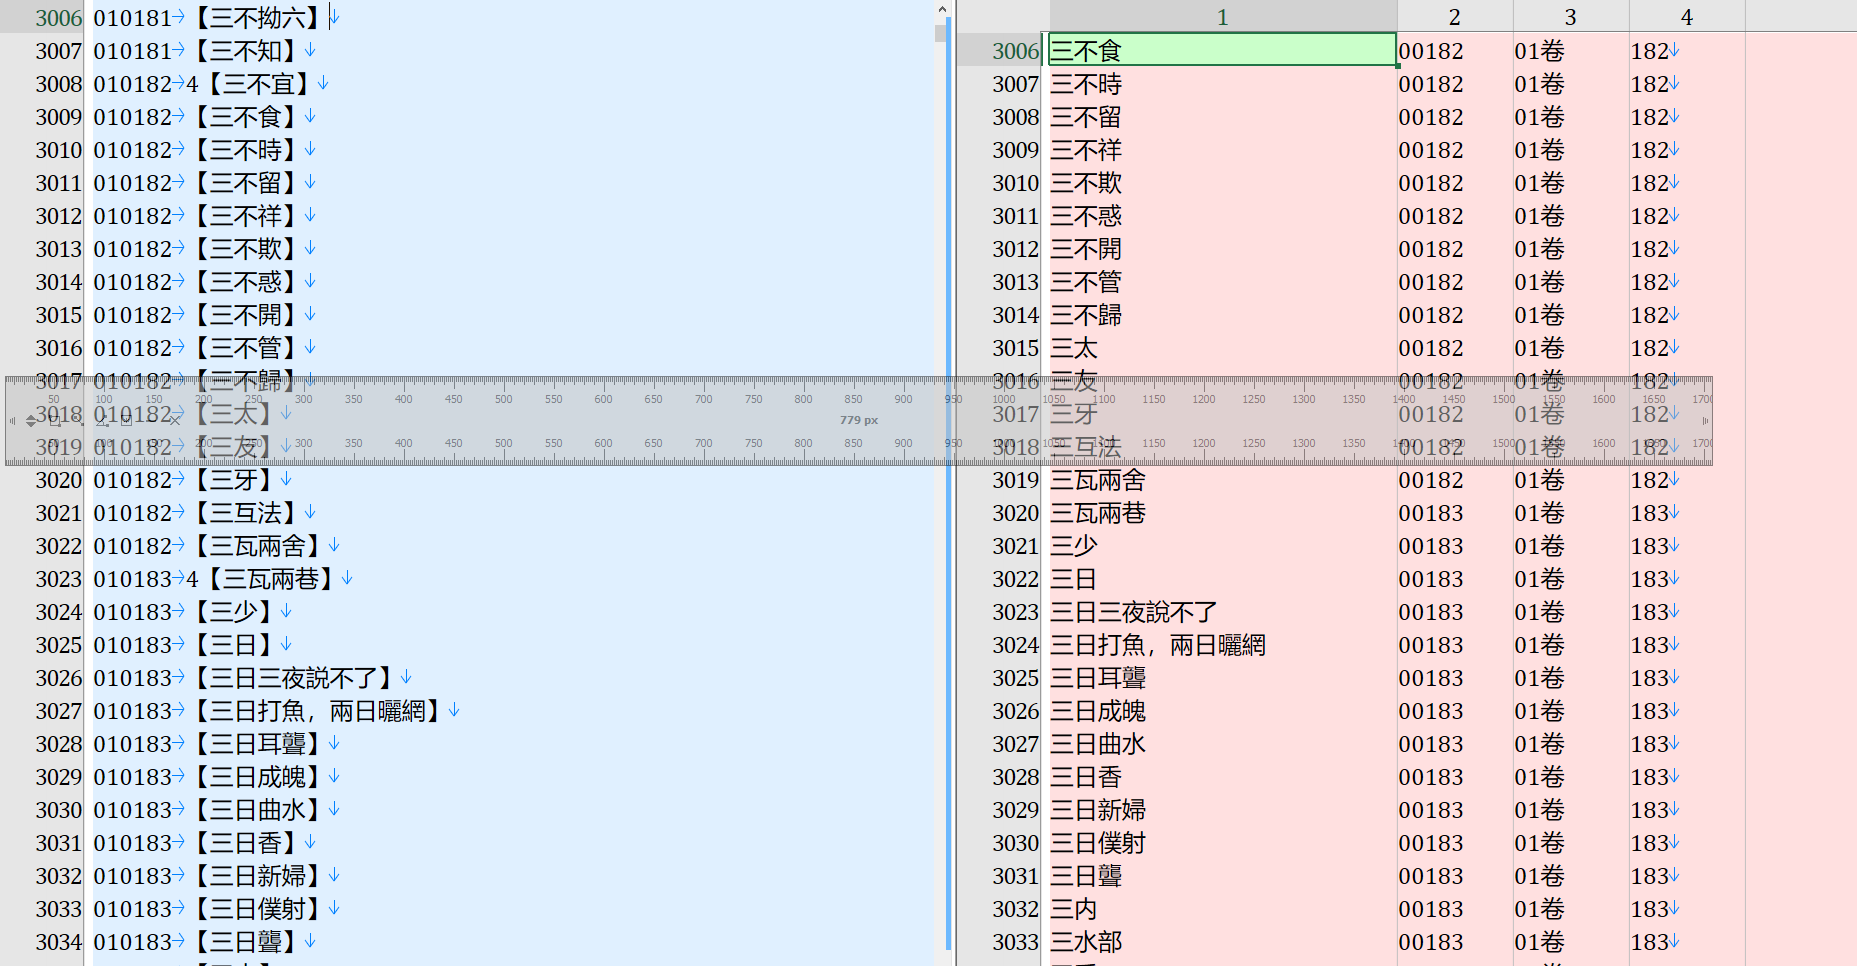
格式很简单,用制表符\t分隔
前2位数字为卷号,后四位为页码号
010001\tXXX
010001\tXXX
…
011744\tZZZ
020001\tAAA
…
…
这个实际上就是校对步骤了。这样的大部头,依靠单个人去包揽不太现实和放心,需要群策群力。
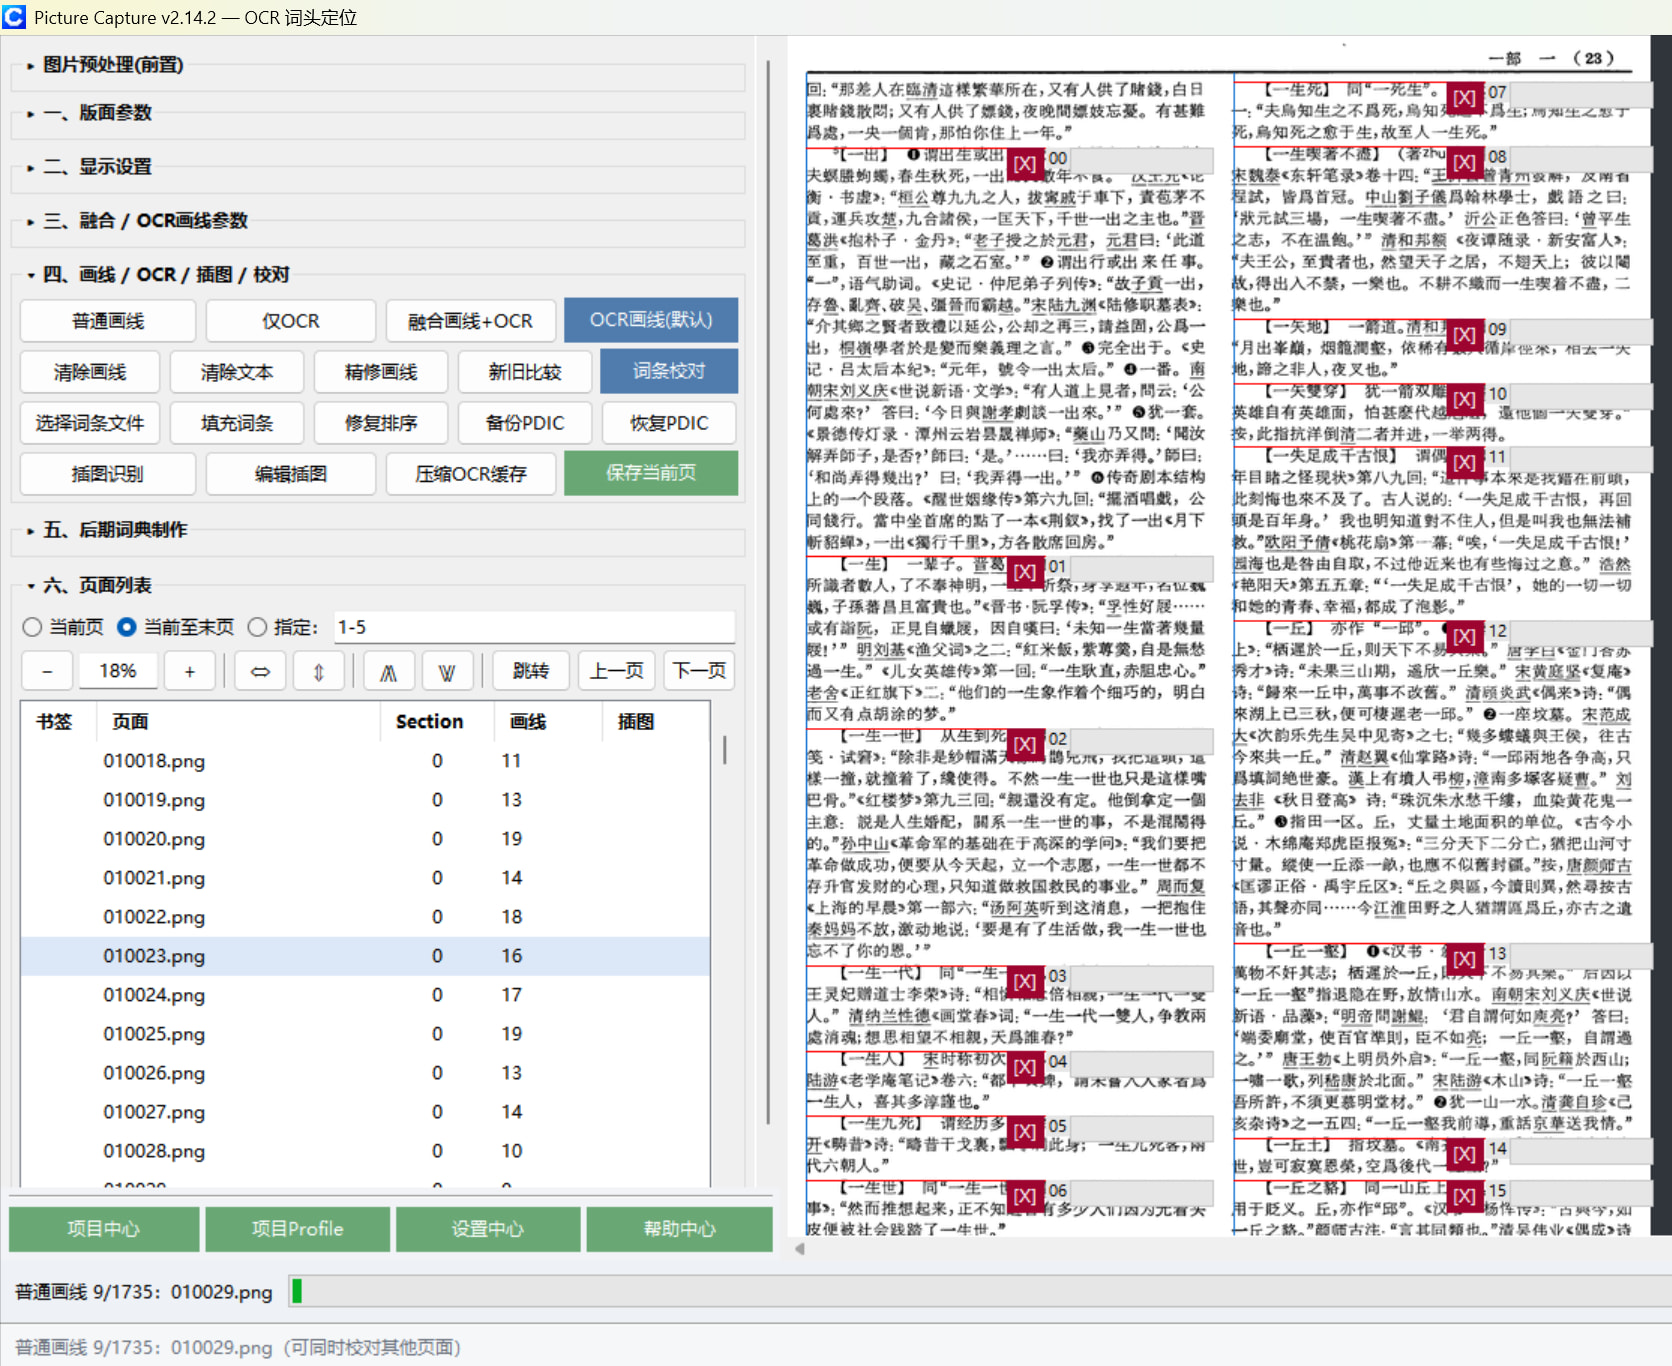
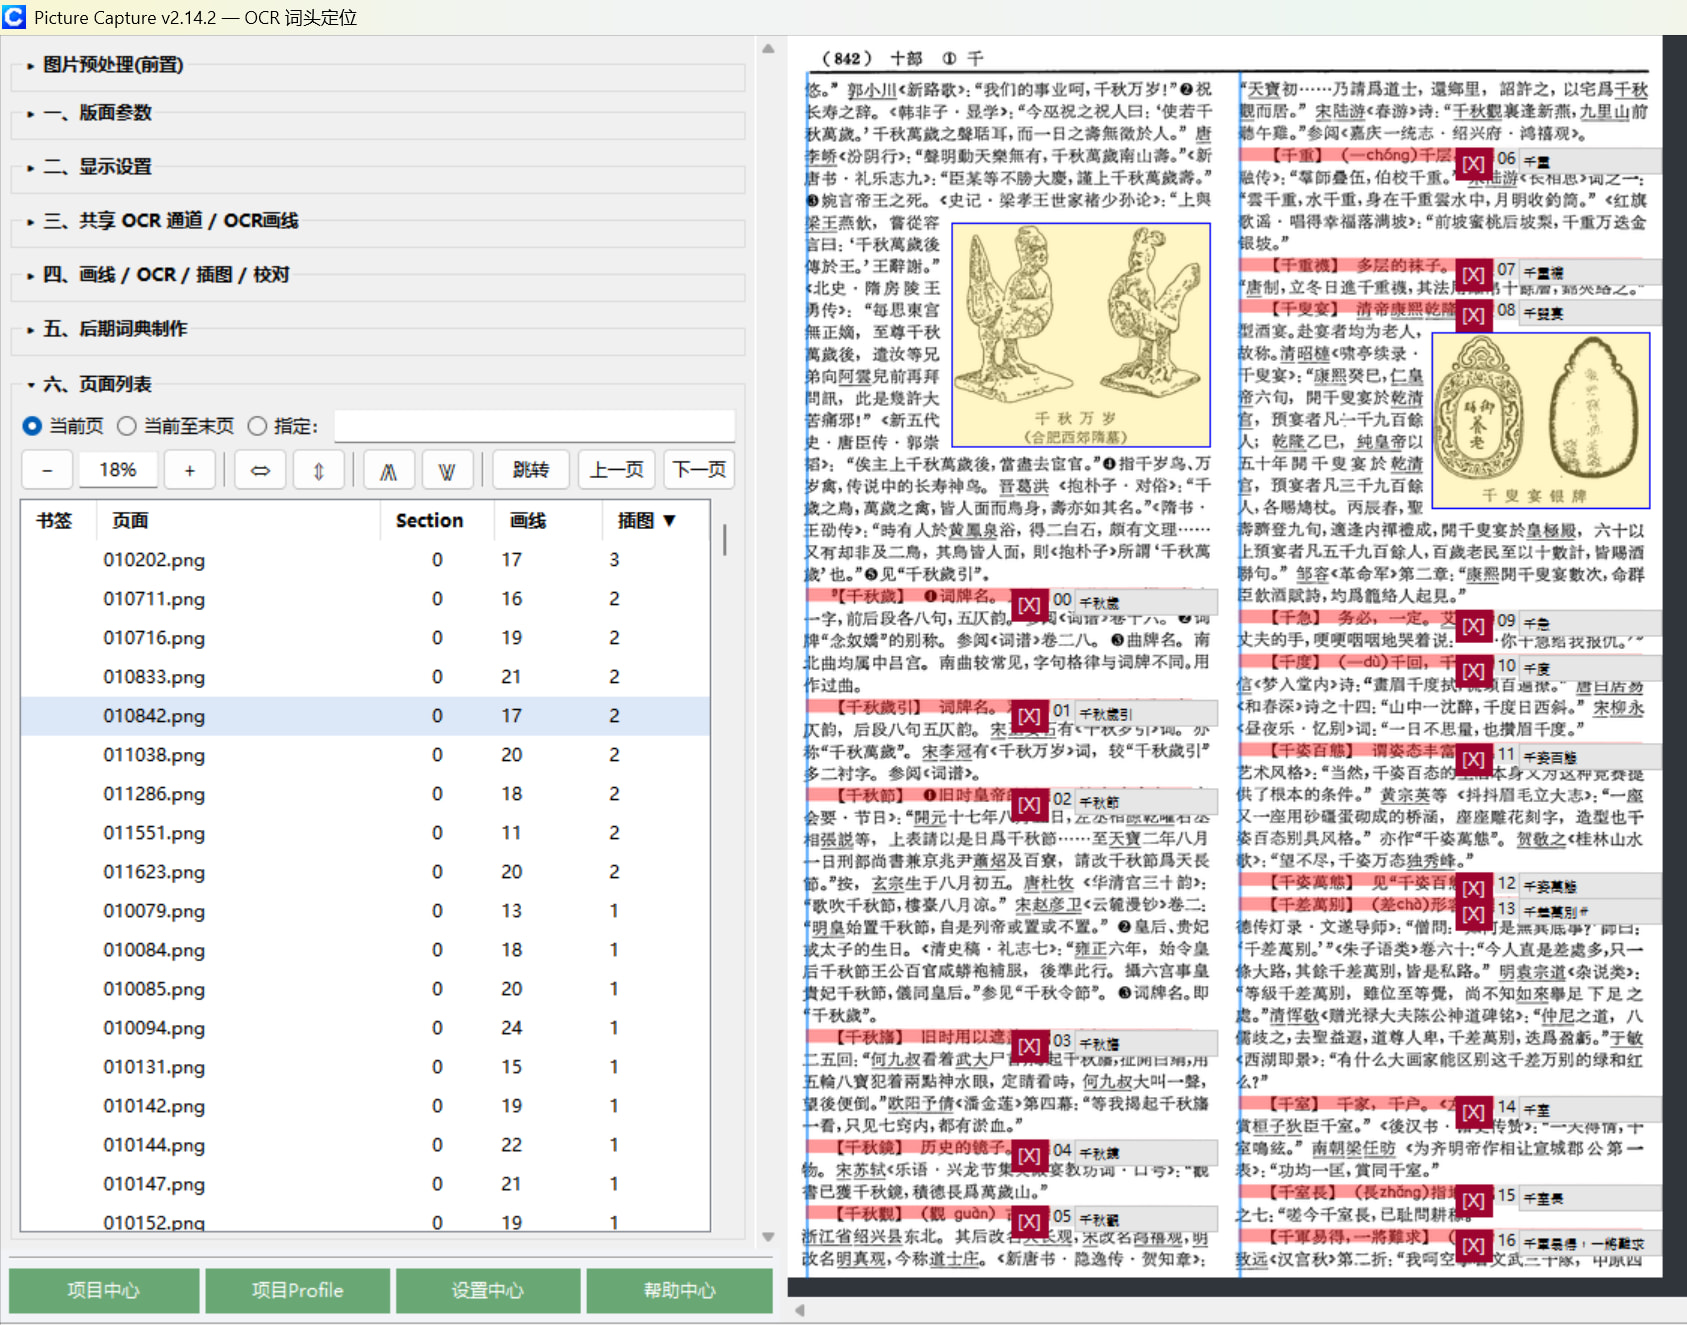
我的想法:像TIO那样,把“切边后的TIF + Picture Capture 初步画线数据 + 用文字版初步填充的词头” 放在云端部署,由论坛网友认领或随机去校对,可以反馈提交词头问题或画线问题或其他。好处是:
- 不需要下载庞大的PDF,校对哪一页就只加载那一页的tif,尽量降低参与者的负担、从而吸引更多志愿参与者。
- 可以多人协作,重复校对也没有关系,因为最终裁定者能平行看到差异、比较方便;需要考虑后端如何存储、查看、输出这些数据(比如 010001\tXXX)。
- 作为长期反馈问题的渠道,不是期望一次性就能做到尽善尽美。
- 慢慢打磨,也是为以后其他大部头的协作先行先试。
总之,大部头需要热情,也需要细水长流。
电子版没有词条的顺序号吗?或者页码总是有的吧?
我的意思只是整理一个基于电子版提供的信息的这样的索引而已啦
你提出的协作校对,“也许”以后可以加一个模块;)
你说的是原来的图像版《汉语大词典》的索引吗?这个索引与你的需求还有不小的差距,抛开准确性不说,主要是词条只有卷与页,一页之内的词条并没有按原书顺序。对于这一点,我曾按笔画对同一页的词条排过序,凑合着能用。如果需要,我找找传上来。
嗯嗯,好啊,谢谢!
页面内排序应该能找到一个比较好的办法~
汉大条目页码排序.txt (8.6 MB)
应该就是这个。其中词条后加#的是文字版没有图片版有的,没有进一步整理。
W2K
10
没那么夸张。
看到论坛里各种ocr和什么再比对啥的越看越不靠谱,我自己弄的。
ocr后批处理
只要左右栏行数没错,无脑回填就没错过。
把非带有【的行正则干掉就出来要的了。单字头加个自己认识的符号同样处理。
要的大表就出来了。
我记得当时带弄不弄的200—300頁很快就弄完了。
再说这回切词软件更新后ocr的词头正确率很高了,人手够一人2、3本词头弄出来没问题。
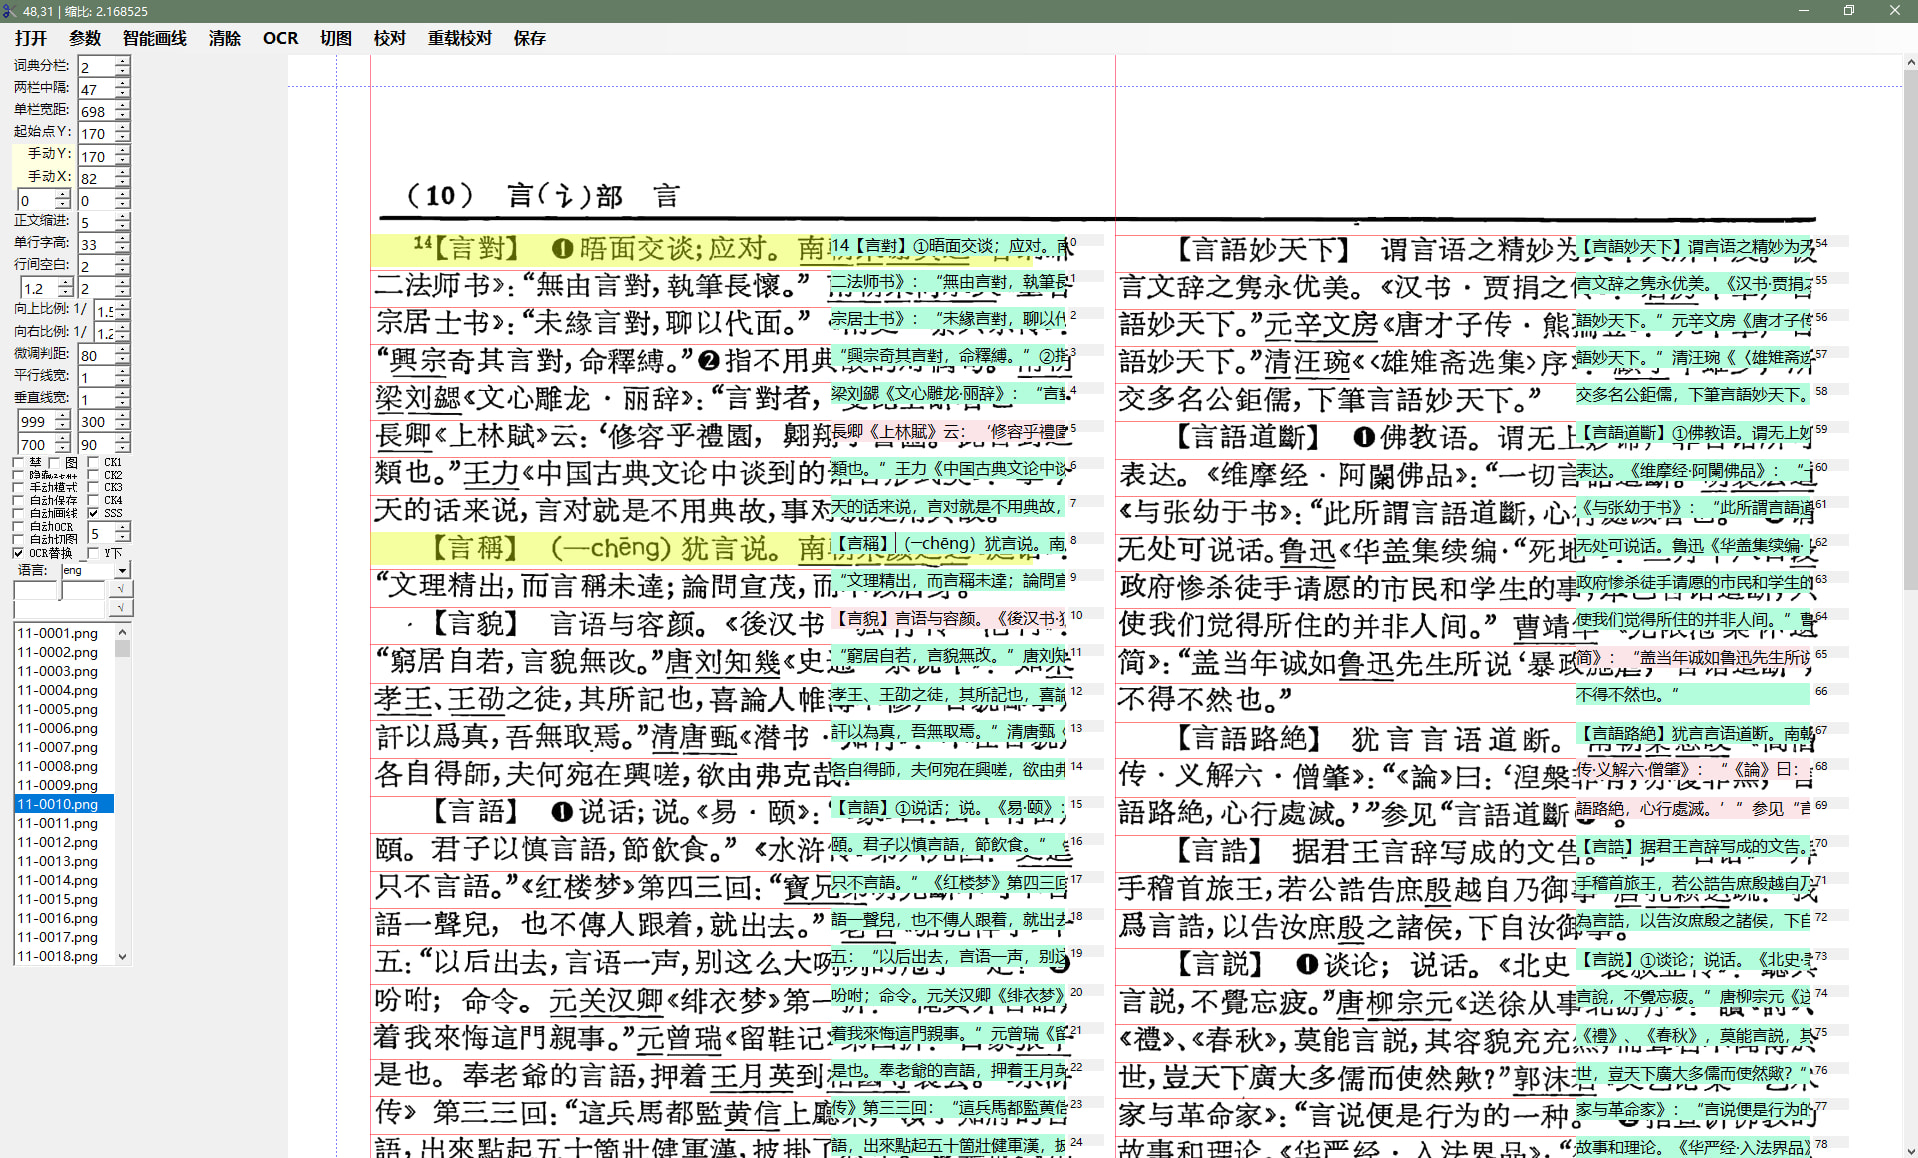
我用新的版面测算,然后【普通画线模式】画的,几乎100%正确。
W2K
12
图现在的质量越来越好,规范起来很方便。
画线你这块弄的很完善了,见你又升级了画线模块
下一步就差词头大的顺序表了,ocr的质量一直在提高。可信度也很高,拿来用没问题(就是再差至少词头数量也就是画线数和顺序这块是没问题的)。
中文类的非基本区外的只能手敲现在还无解(百度可以识别出来一些基本区外的但也很局限,个别地方还是缺词丢字)。
利用好减少人力肉搏就得到大词表也是个方向,保证准确的前提减少劳动量。把精力用到校对和纠错上。
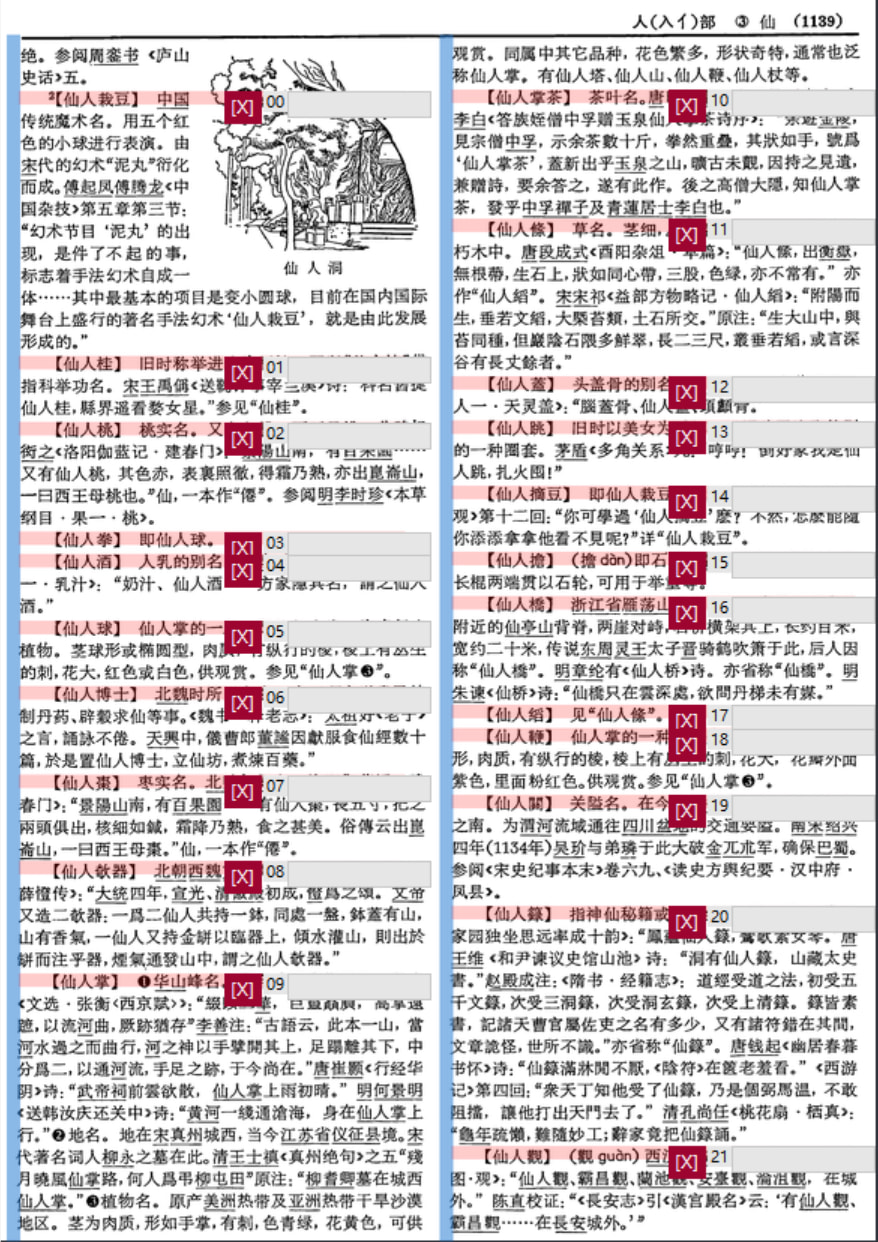
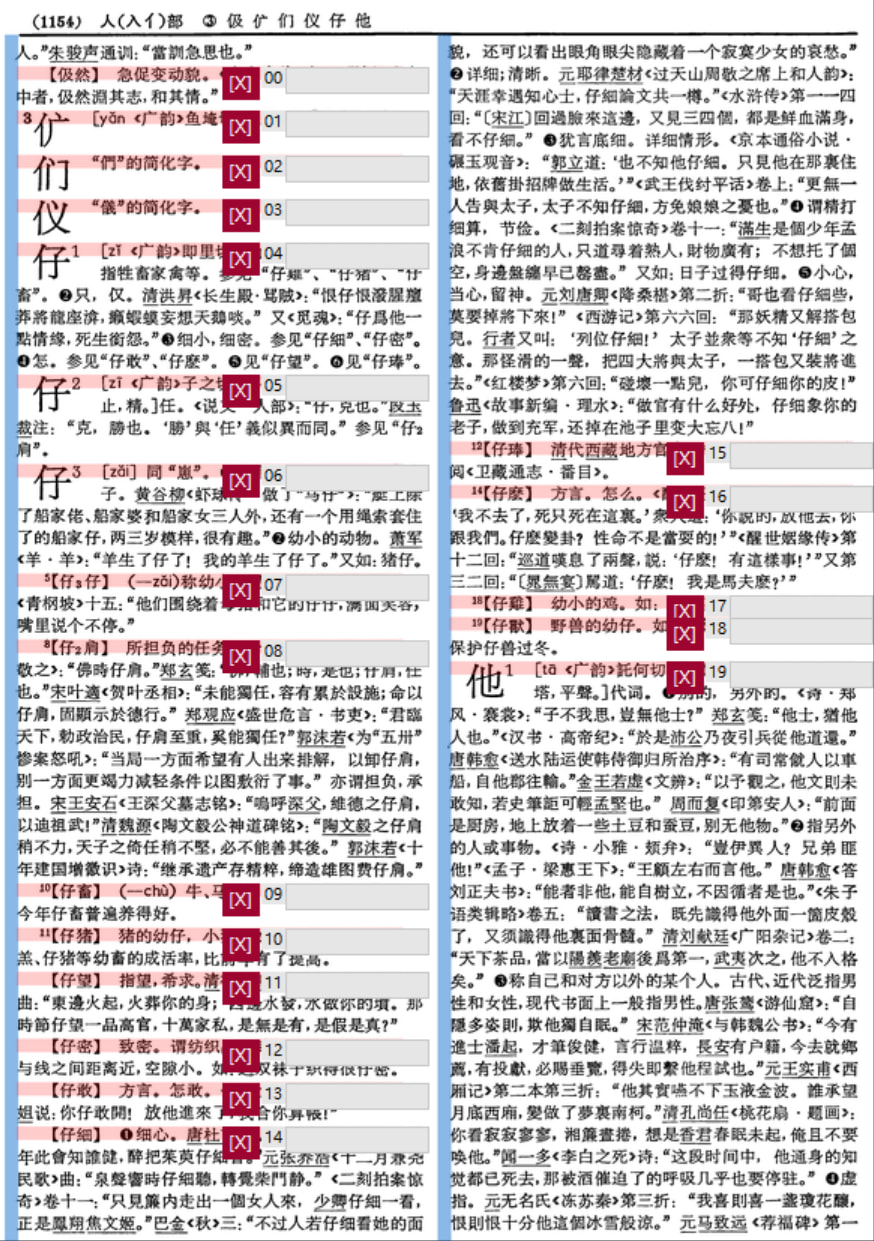
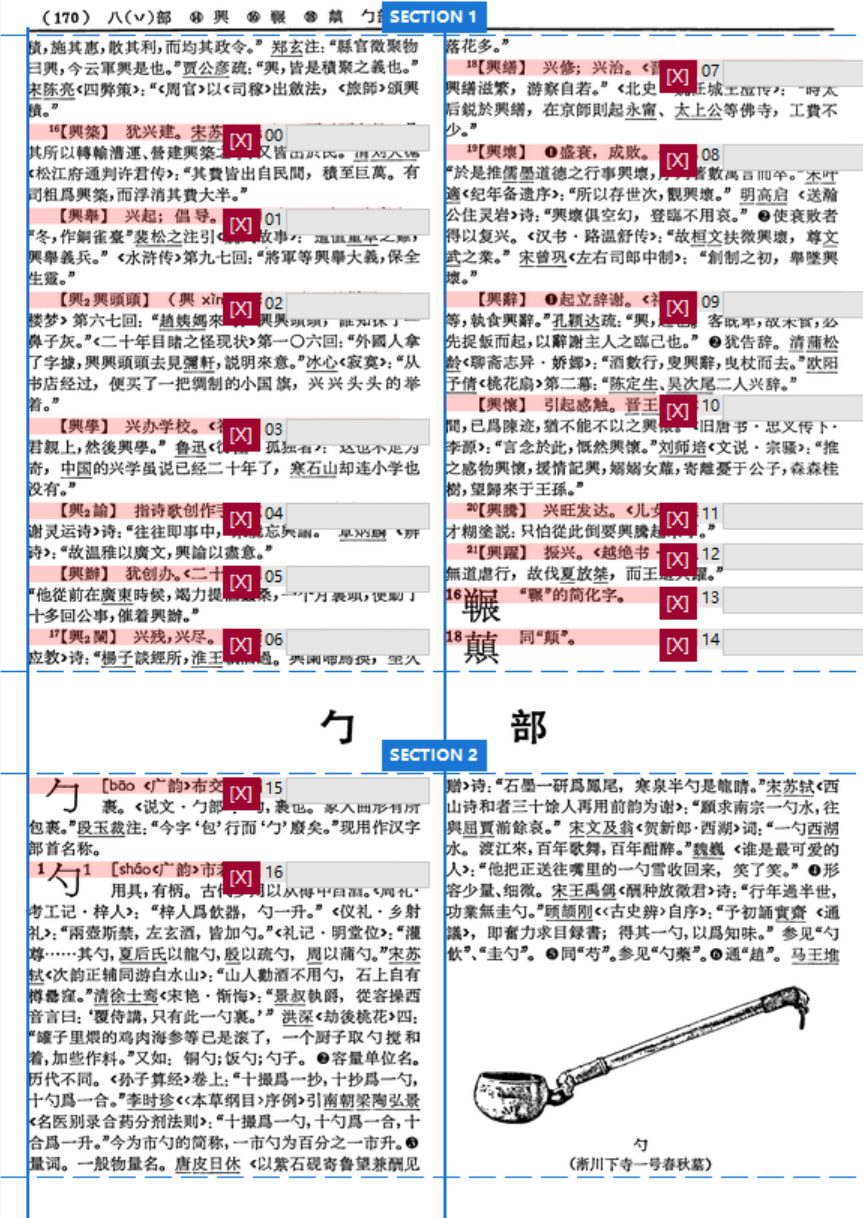
填充前需要给类似这样的部首起始页设置section,词条顺序就对啦
haoshu
14
W2K
15
卷一
个别特殊頁高:253、254、255、256
010001-010300.txt (115.6 KB)
2010-汉语大词典订补.pdf (224mb版 / 817mb版)
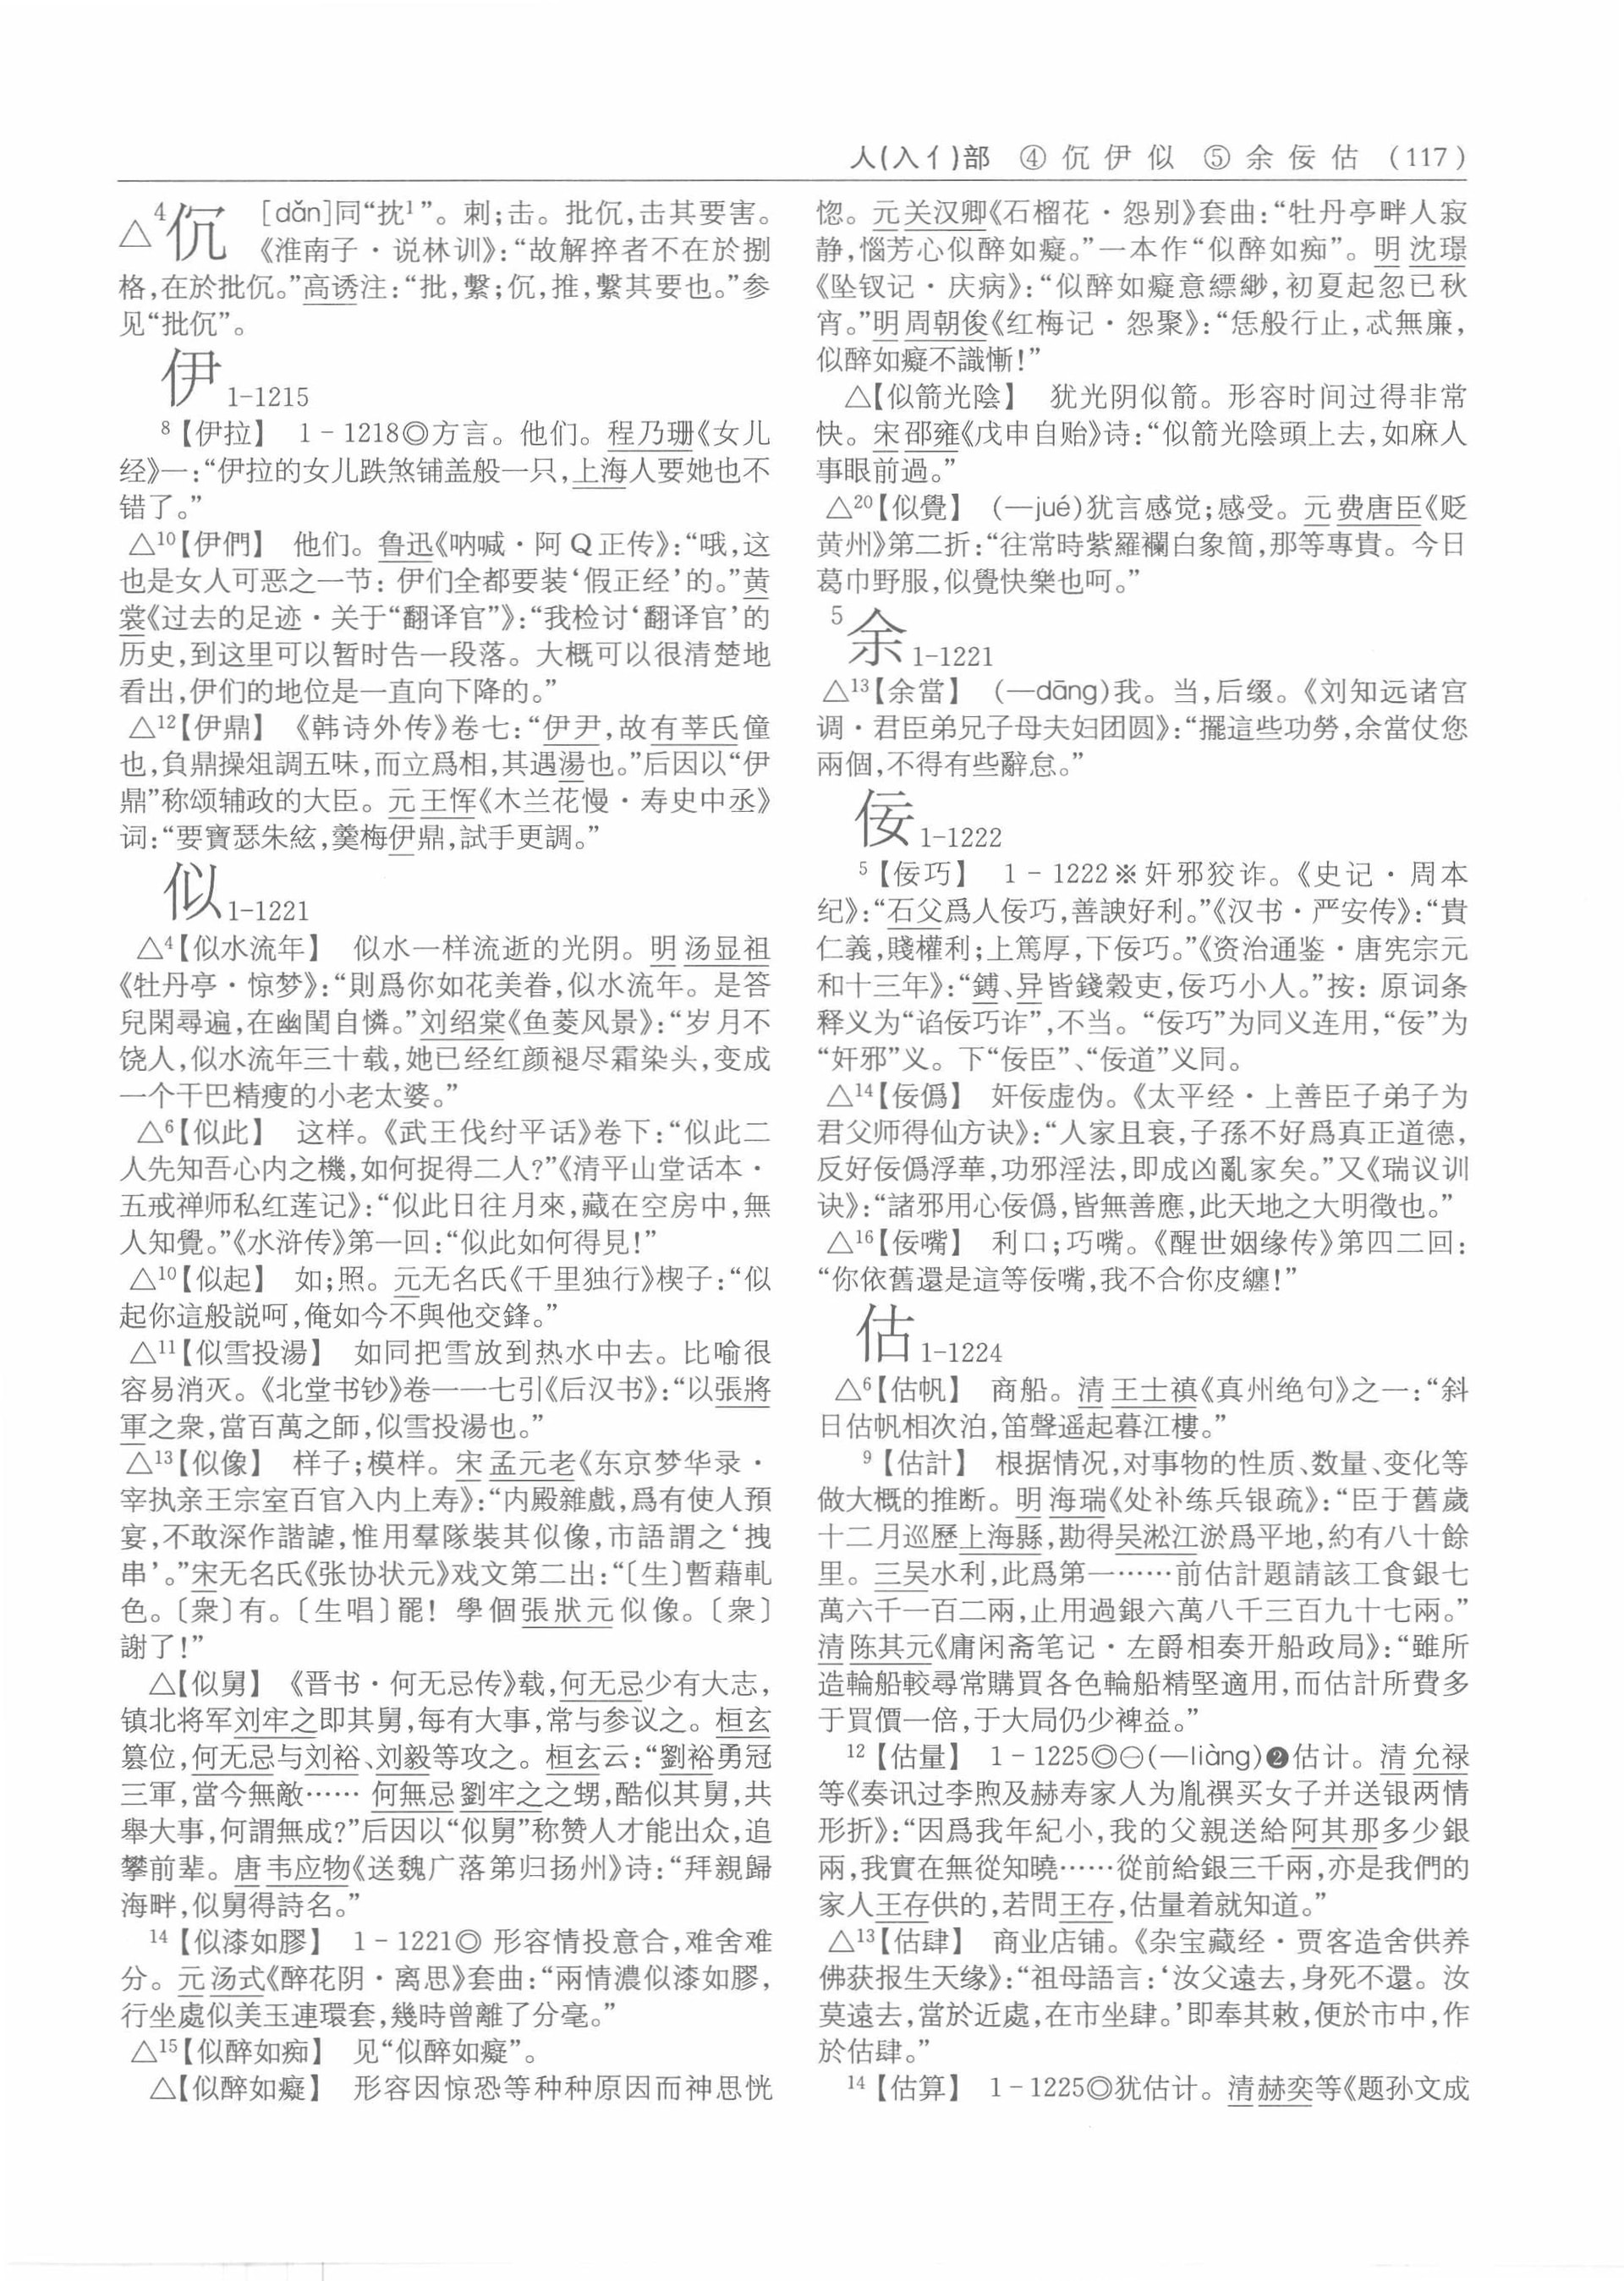
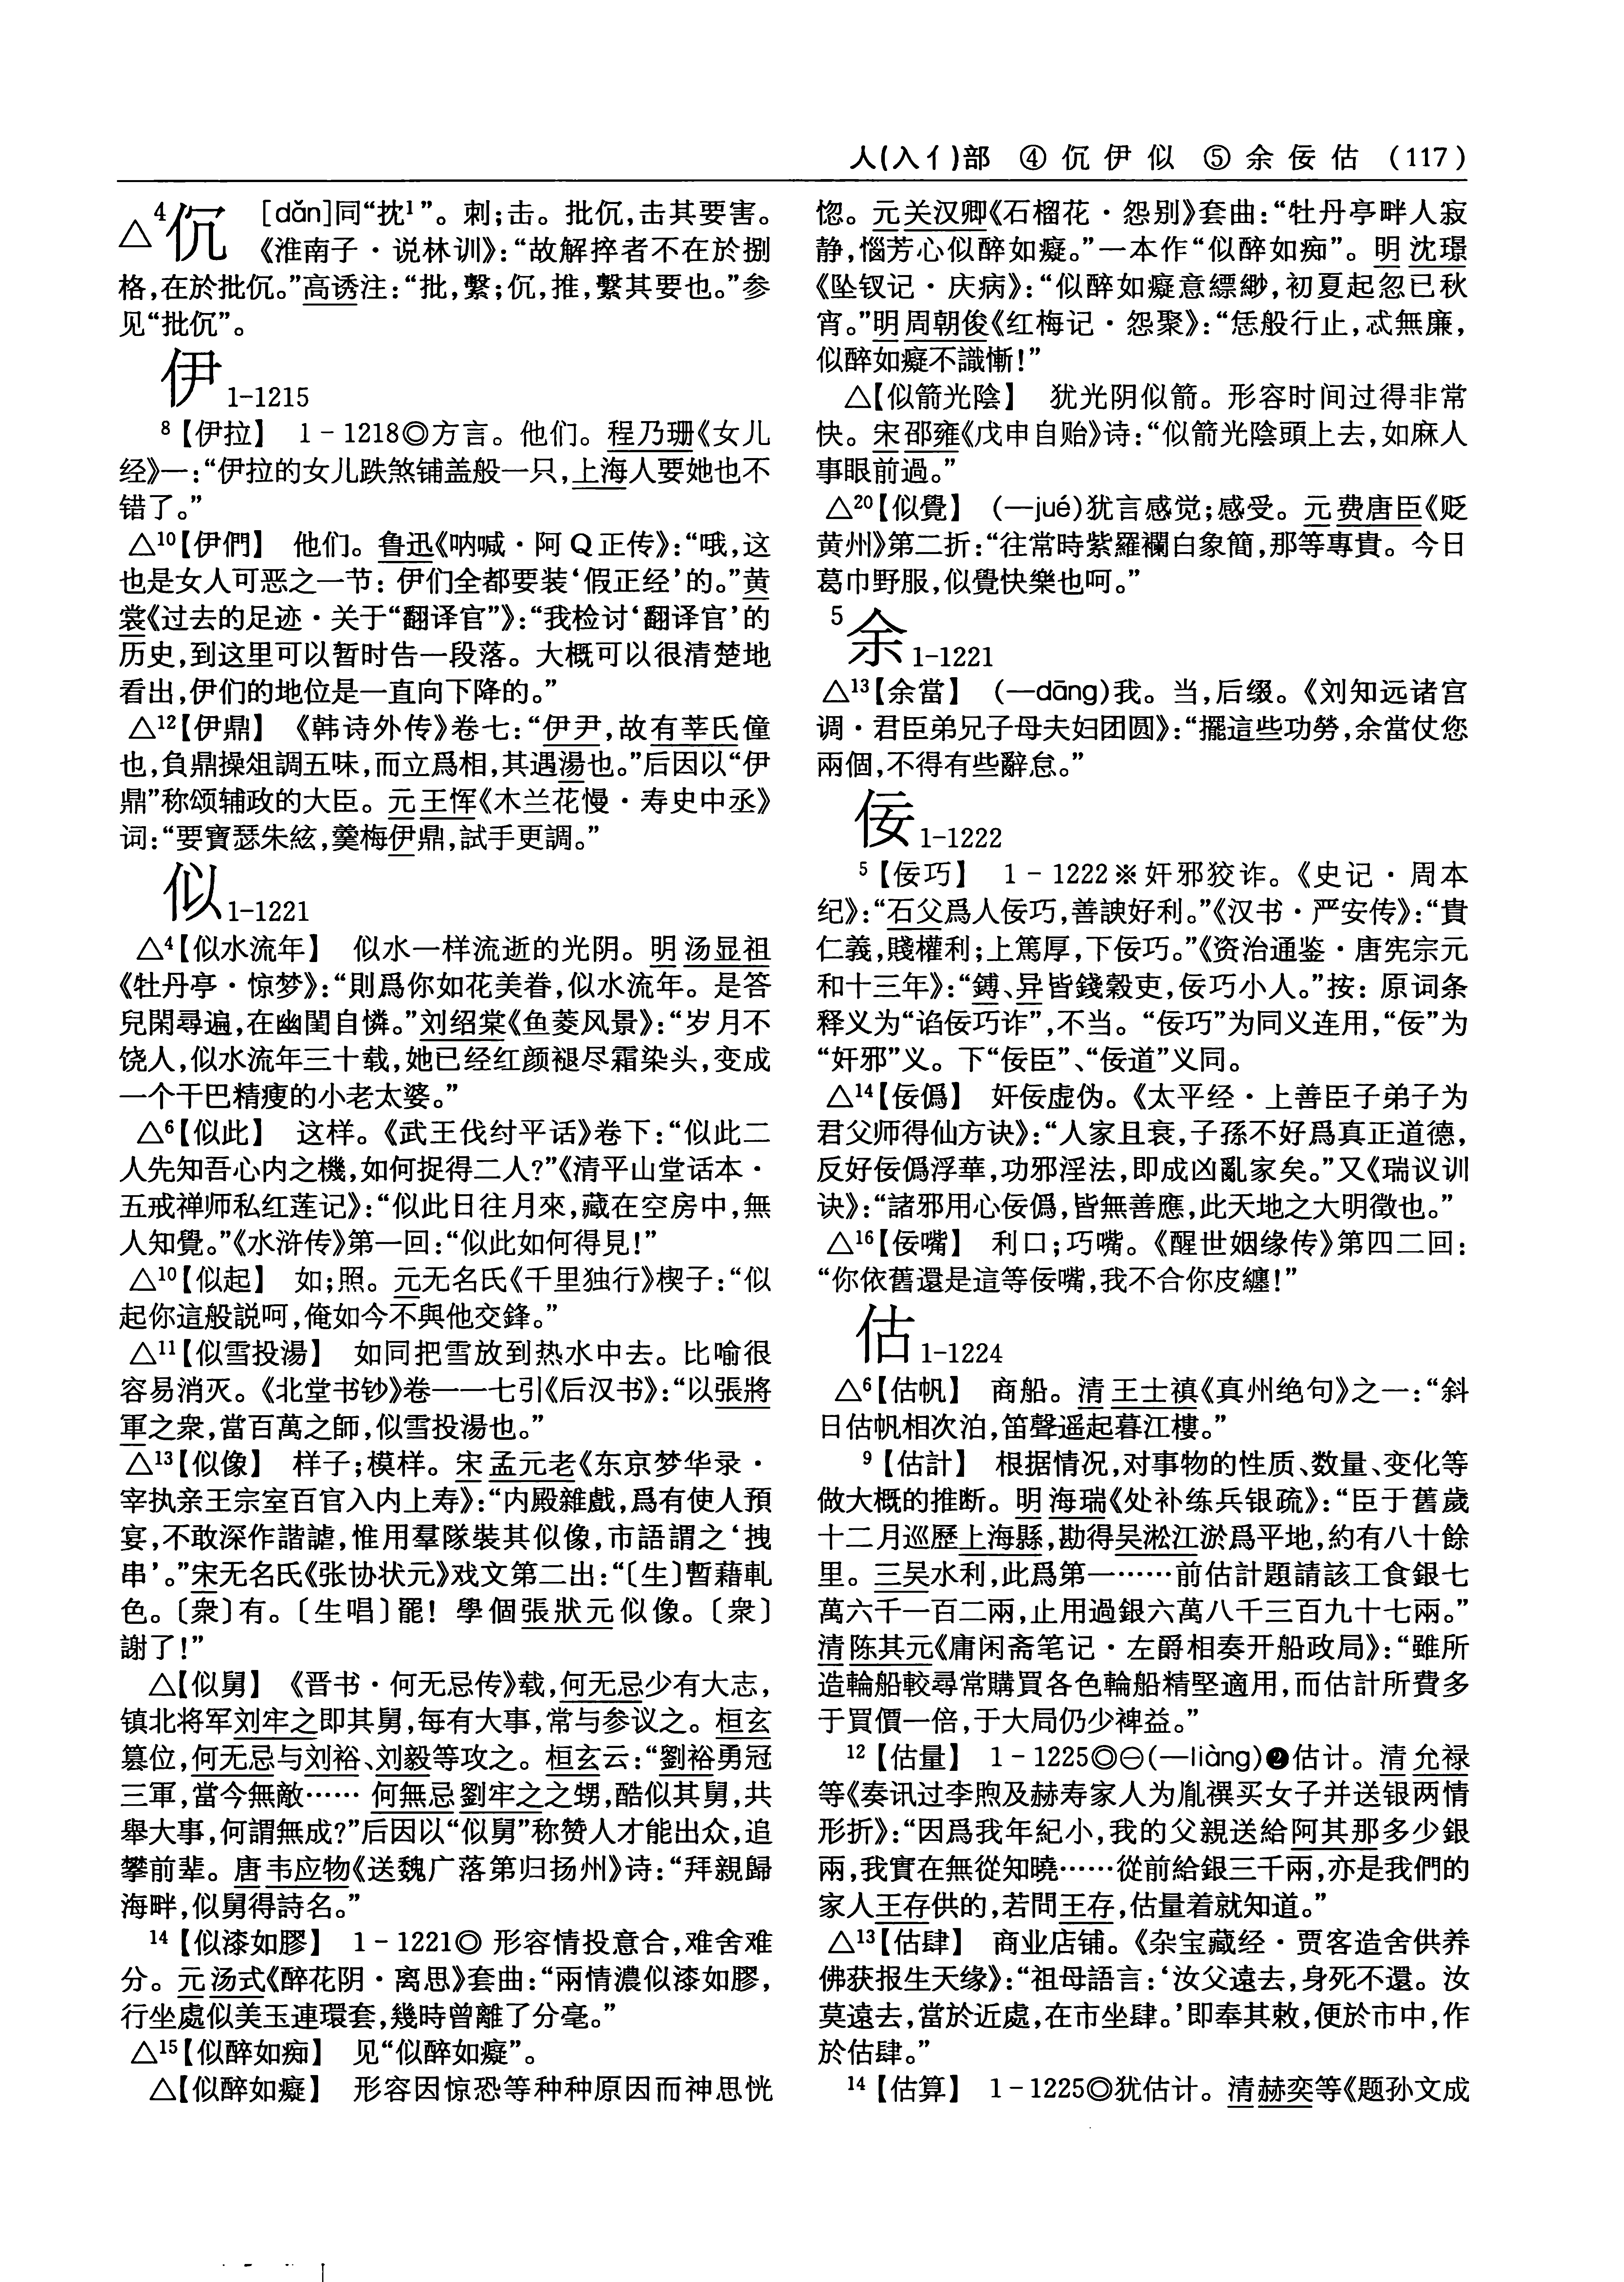
正文第117页缺少一半内容