Fince
1
看到坛友在 [征集]目前还有哪些词典值得制作 - #88,来自 slgns 中的许愿而做的词典,历经两周校对,已分别制作出图片版和文字版。感谢 @wynick27 提供的OCR数据,感谢 @chigre3 的切图和部分校正。
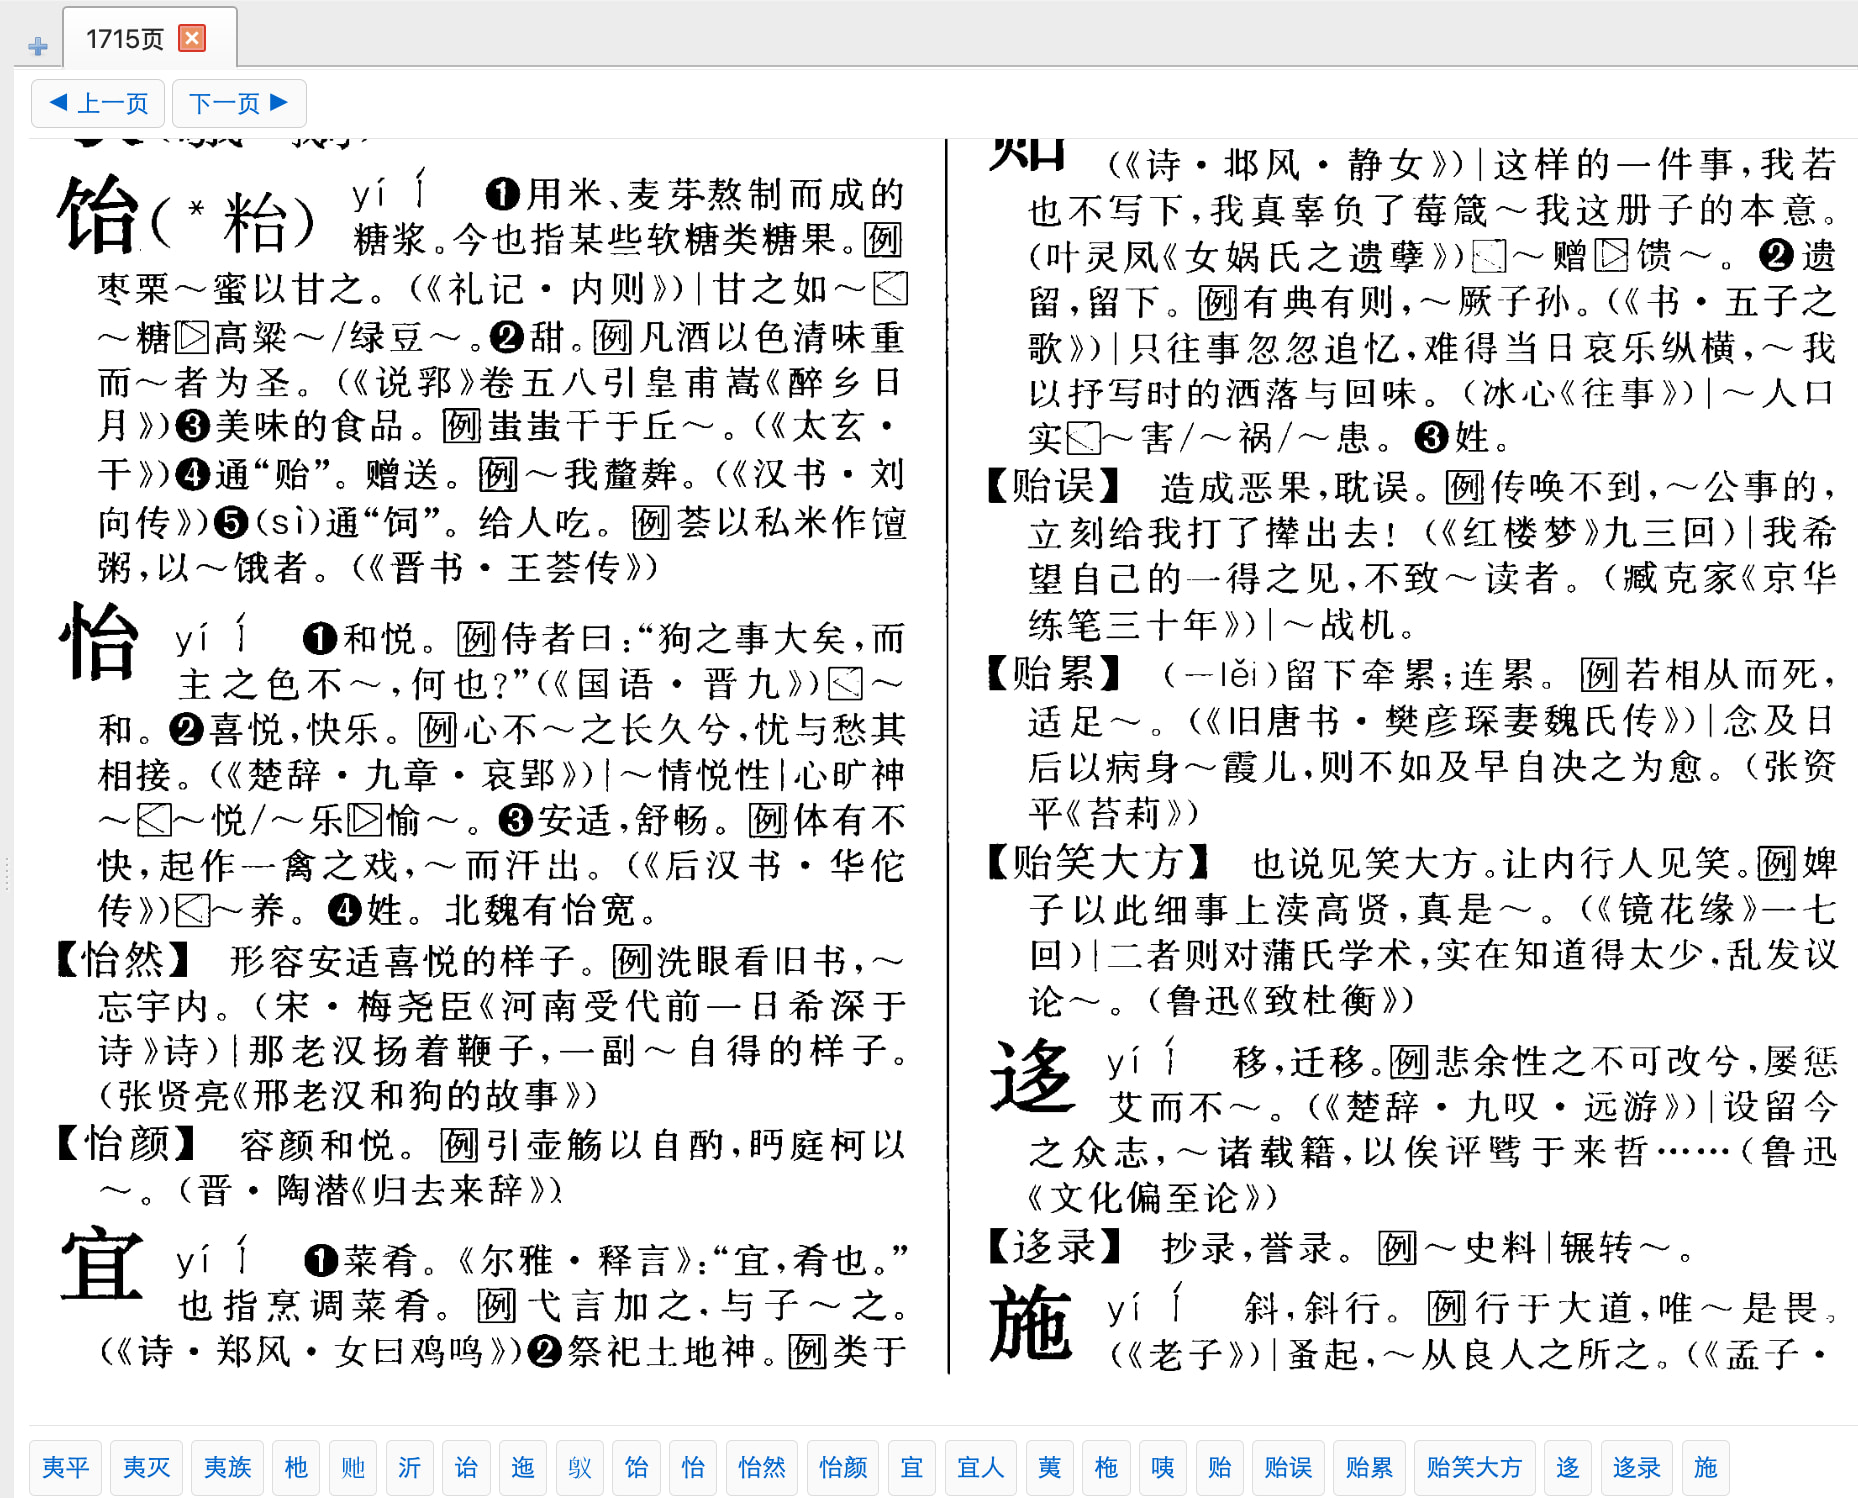
之前下载过旧版的切图版的,请重新下载新版图片版,新版同时提供了整页查看和切图查看功能,且能选择查看上/下一词条或上/下一页。新版使用了 chigre3 提供的处理后的高清透明底PNG,并在尽量保证文字清晰的前提下压缩了图片大小,且相较于上一版又校正了数百处词头错漏。不过,文字版尽管也进行了一系列校对,但也难免还是会存在一些错误,欢迎大家一起捉虫。(其实也有一些已知的小问题,后续攒够一批问题后会更新一版)
下载链接:
应 chigre3 的要求,提供一份词条索引表:
古今汉语词典_词条索引.txt (495.9 KB)
这本词典如坛友所说,质量还是很高的,有一些甚至其他大型辞典都没有的东西。校对这段时间,除了偶尔有些少标点符号之类的小问题,几乎没有什么明显的错漏,真正想写但是漏了词或字的地方,恐怕不到十处。而且编排上有其特色,古今兼收,很多内容和汉大、现汉都有差异,可以形成互补。
校对过程中还发现,词典的编纂人员似乎对特定著作有特定的喜好,例如,近现代著作中,例句引用最多的是茅盾的《子夜》,其次是《穆斯林的葬礼》和《铁道游击队》,这三个都引用了四百多次;古代作品里引用超过一千次的则有《史记》《诗经》《汉书》《左传》《红楼梦》《后汉书》《礼记》,其中尤其体现出对红楼梦的偏好,四大名著里引用红楼梦的次数比引用另外三个加起来还多。不过这并不意味着其例句来源单一,即使排除其大量引用的没有注明名称的报刊选文,有明确标明出处的就有将近两万个不同来源。
Fince
3
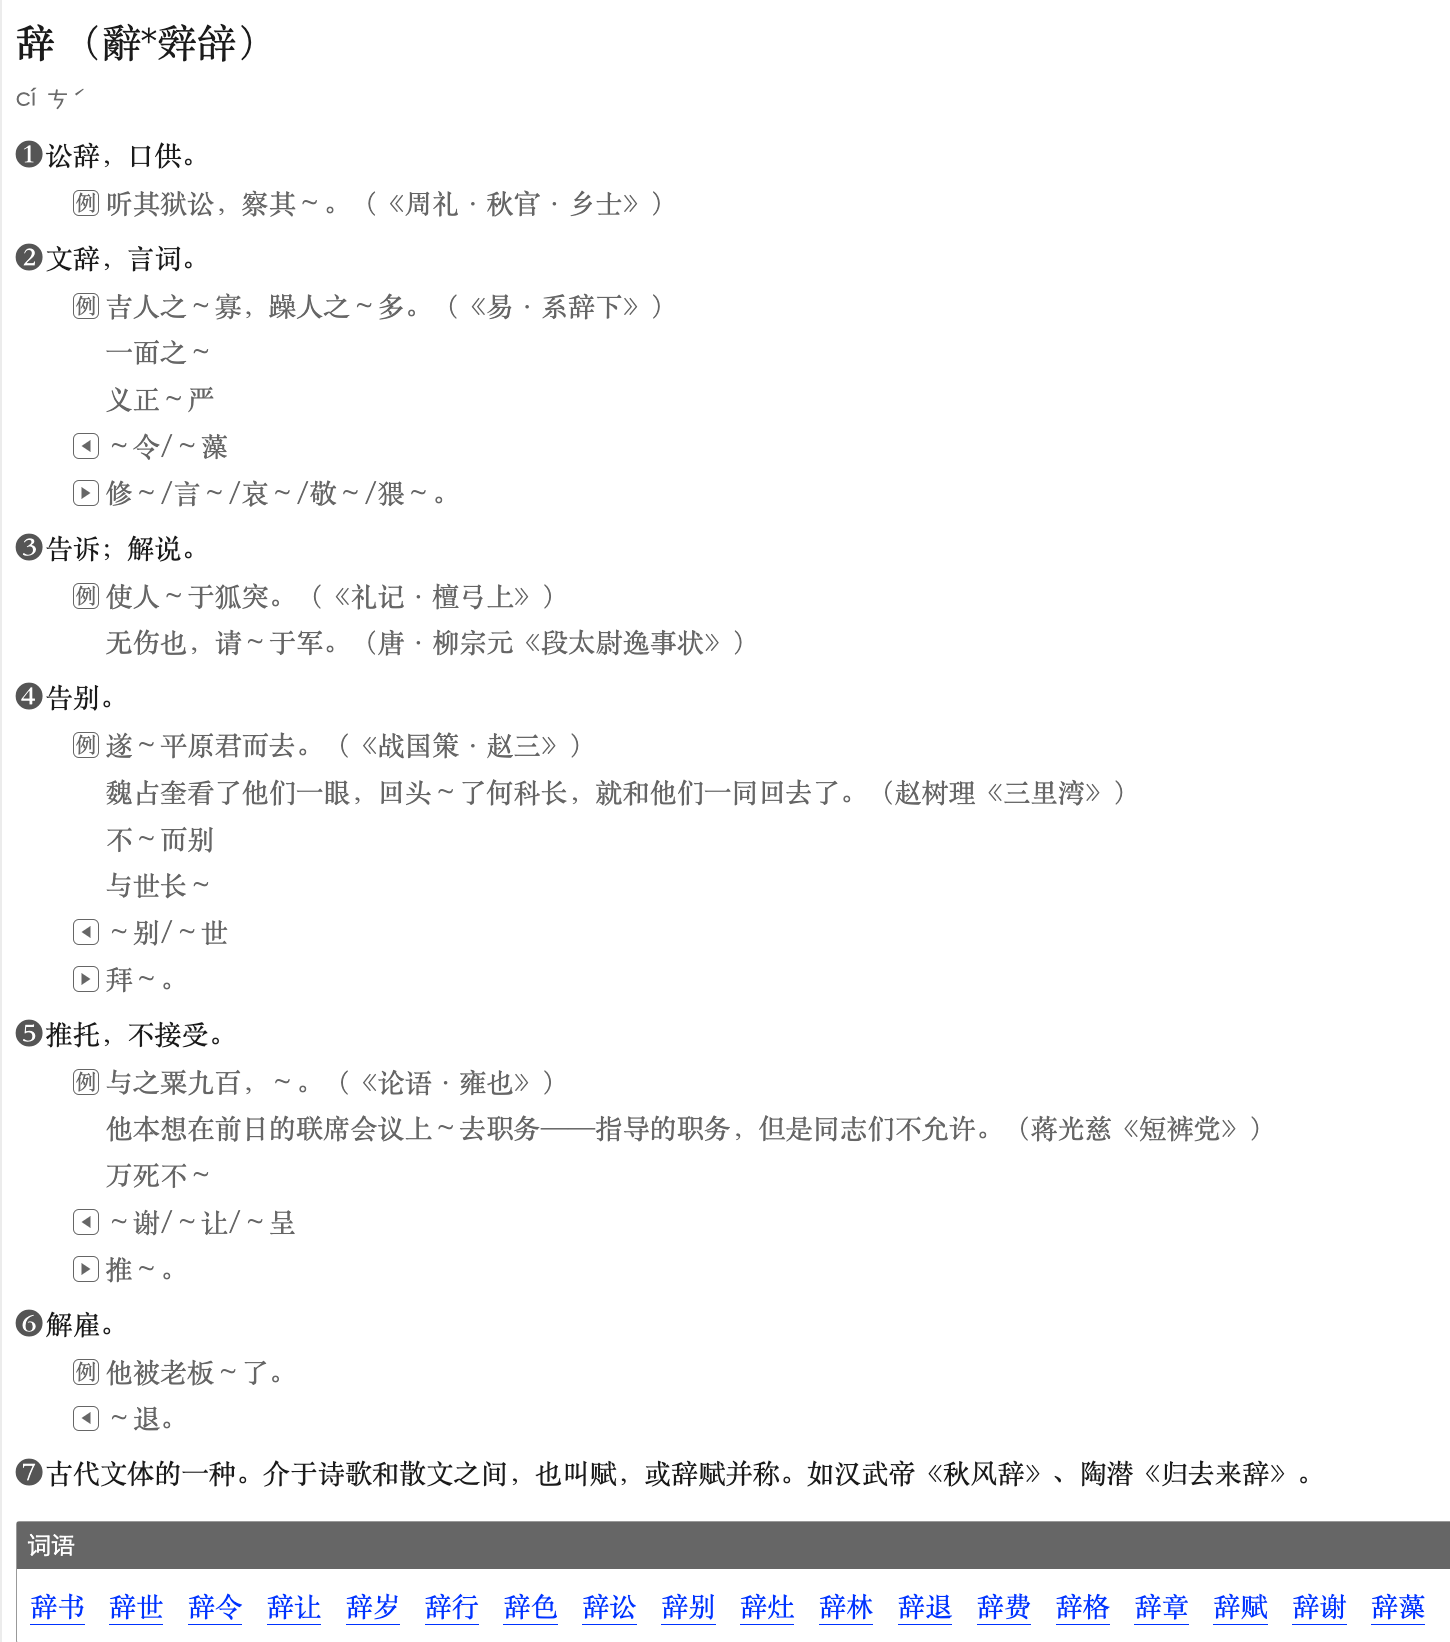
词典中的极少数异体字,由于本身是同码位字形差异,需要使用CJK兼容区的Unicode,例如示例图中的奔的异体形式。书中默认对贝、车、齿、风、见、钅、马、麦、门、鸟、饣、纟、讠、页、鱼这十五个类推简化偏旁的对应繁体字不单独列出,我在mdx中单独添加了其对应的类推繁体形式。另有一个类推简化字词头⿱𰀡手(掔)确实没有Unicode码位,未来可能需要用外字图片来处理。
slgns
4
感谢辛苦制作分享!这本词典看得出来当年是认真做的。近年来新出辞书的编校质量可以说是每况愈下,例如《辞源》第3版竟然搞出“南宫適”、“黨項”这种低级简繁转换错误,新出《现汉大》的编写水平也是一言难尽,可参见隔壁一些帖子。所以好的旧版辞书还是很有数字化的价值
Fince
5
愿意潜下心来按照体例查证考据编纂订正的人恐怕会越来越少了,毕竟这种工作从经济效益上显得越来越没有价值了。若是某些项目主要目的是拿到资金尽快搞出成果,赌没有多少人会在乎这一套词典并掀起舆论,那就更不会仔细打磨了。
虽然全世界的词典编纂行业都在不可避免地走向下坡路,但就算成熟完善的词典只是特定历史时期的产物,它也是在相当一段时间内值得后人继续加以利用的。说得有点像“考古式创新” 
感谢楼主分享大作,有一个不情之请,不知有没有整页版可以分享?感觉电脑上整页版更合适
Fince
8
正在做文字版,待文字版成型了一并做出整页版,因为做文字版的过程中又发现一百多处图片版的索引错误
太牛了。能不能录个视频呀?是怎么做这个切图的?很多文字都有说明,但是可能不录屏,不真正的操作一下,可能还是很难。
Fince
11
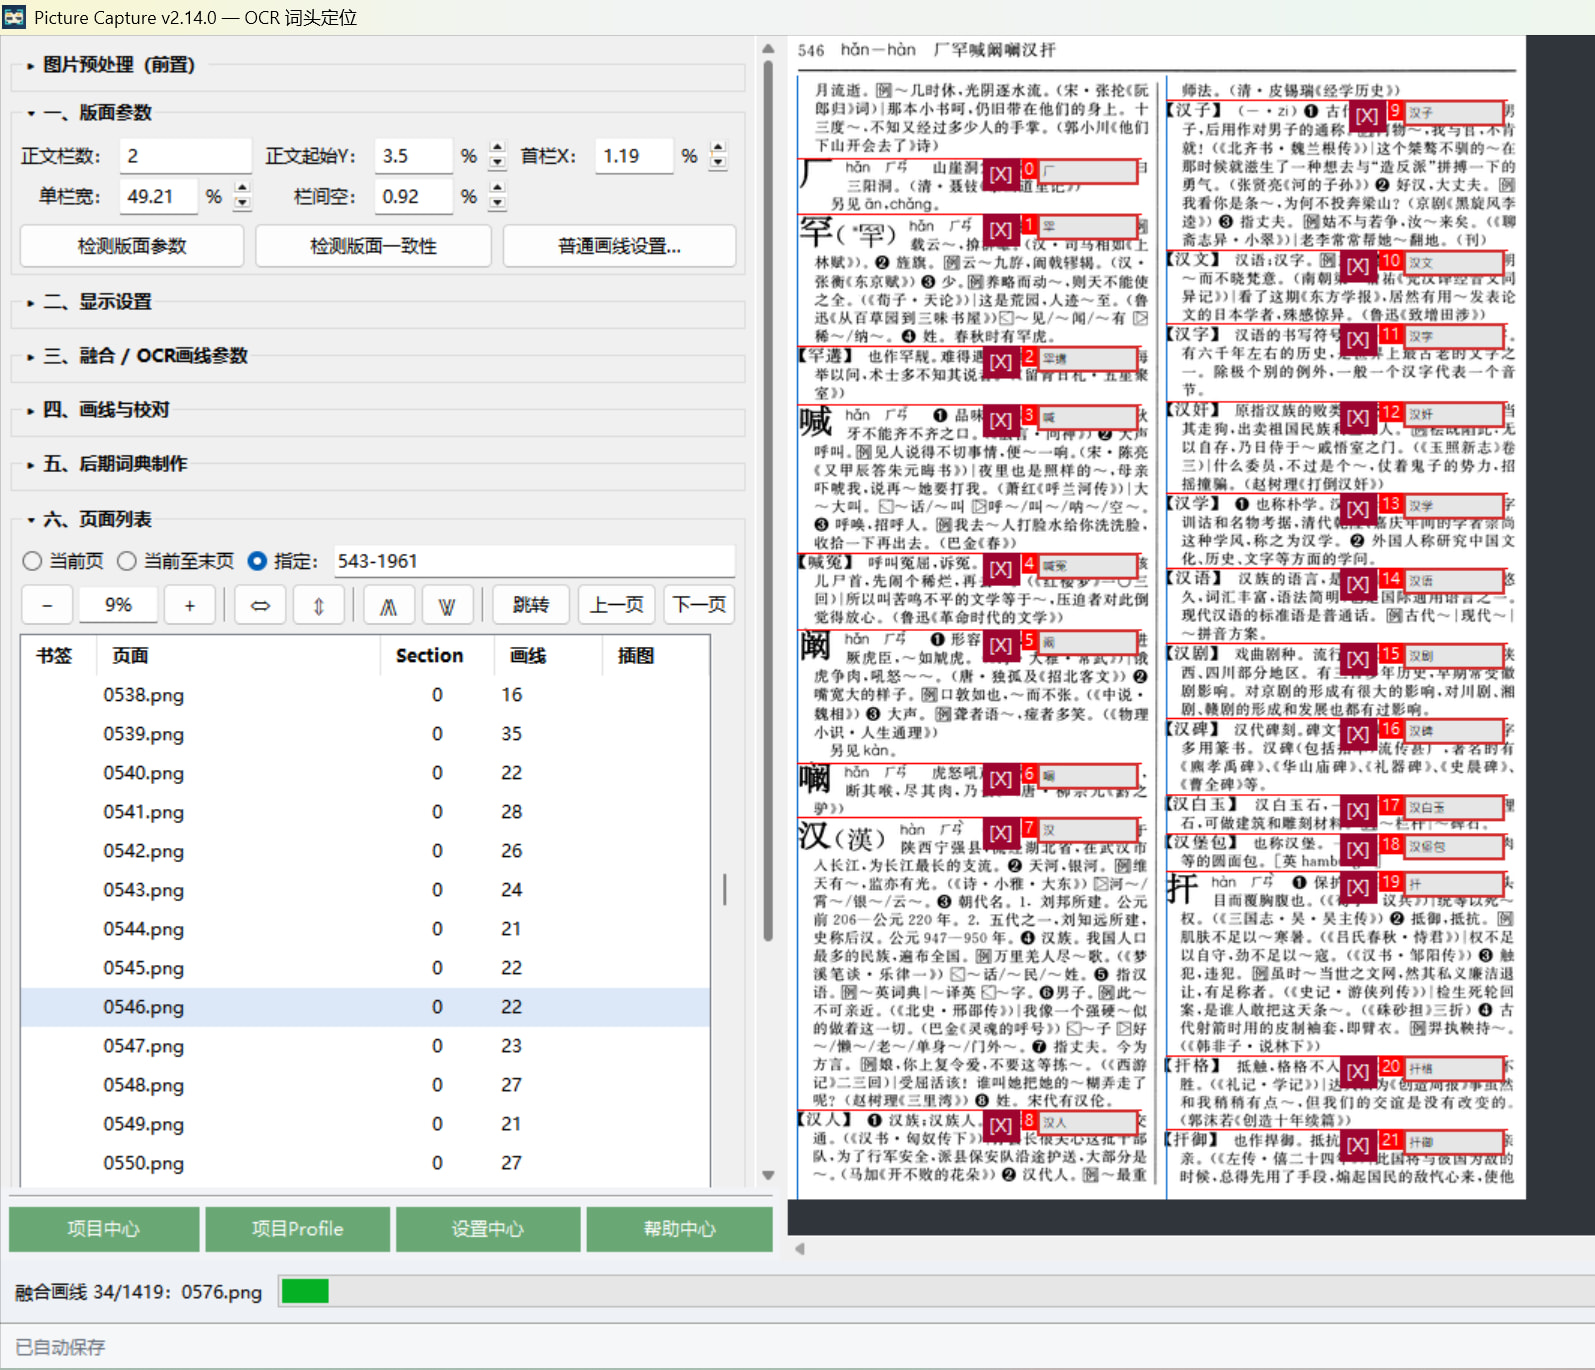
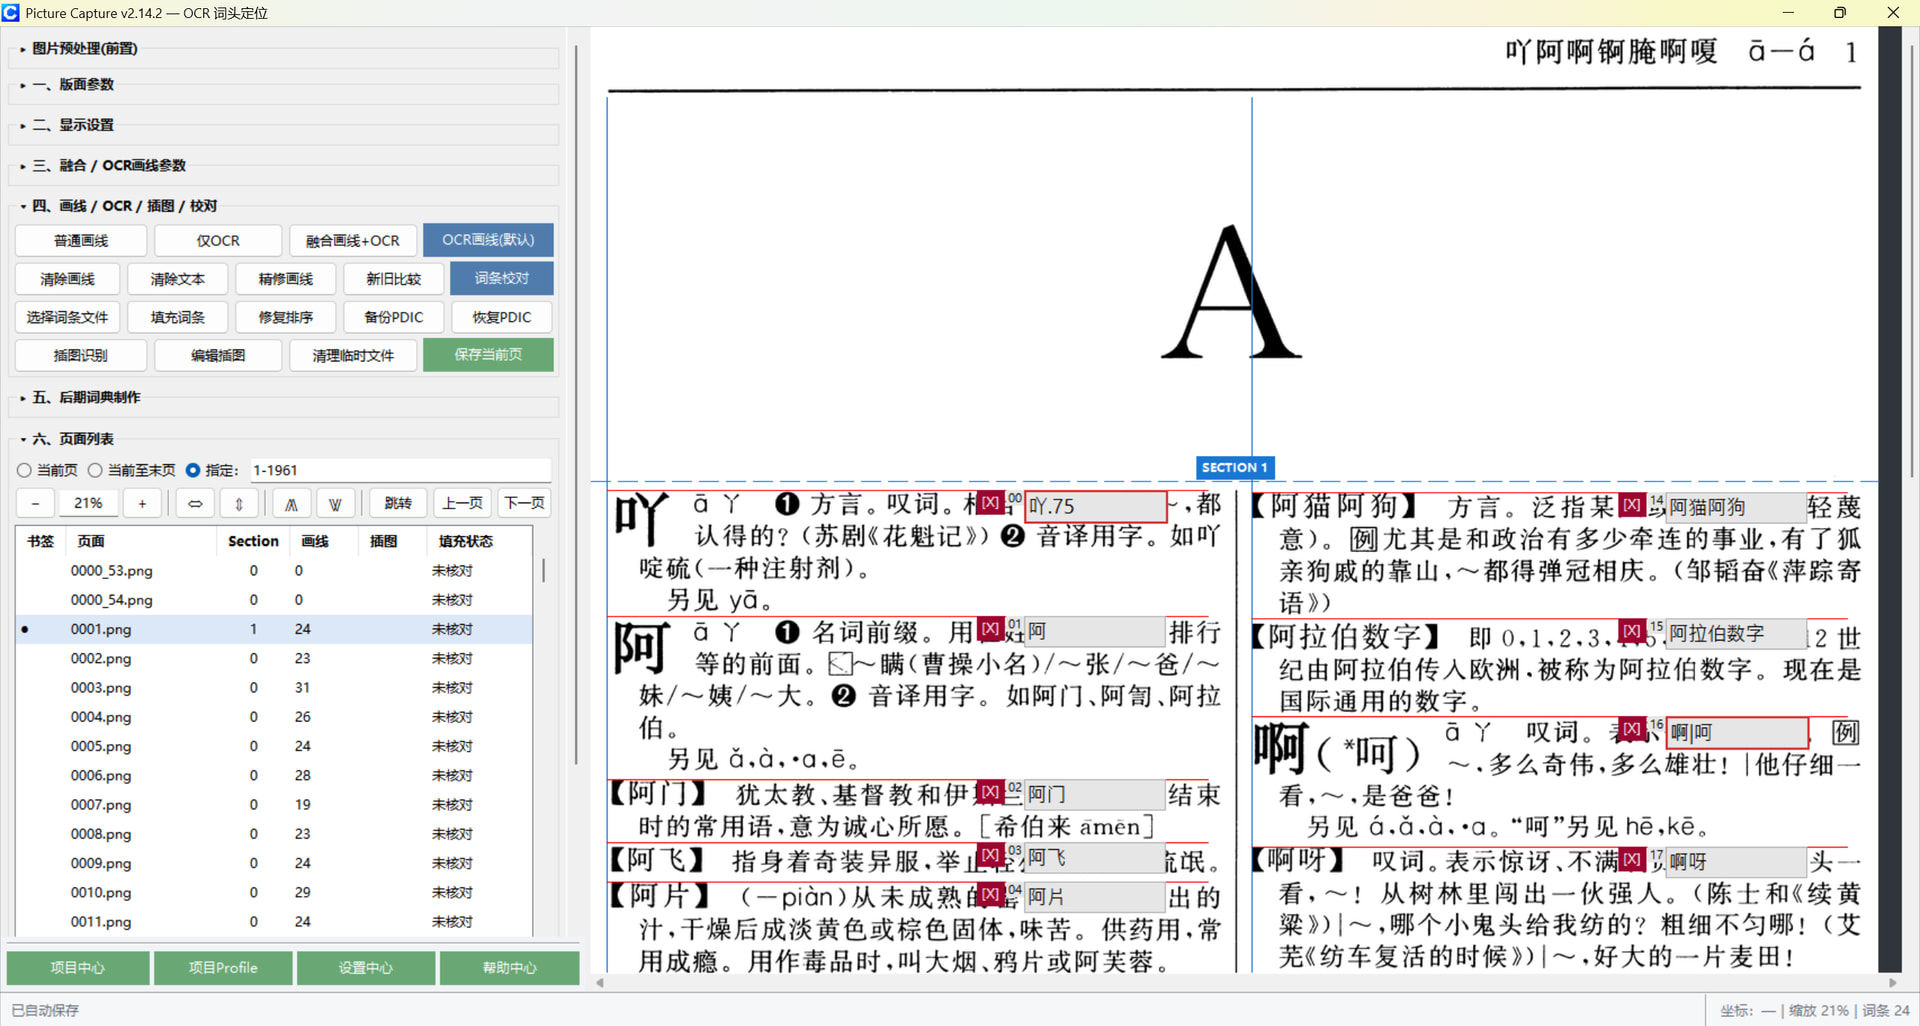
我直接让AI自己分析PDF样式然后自己编写脚本自动切的,然后有少数几个词条切的不对再个别改就行
用K大分享的PDF(2.0GB)
→ 导出图片(600dpi TIF)
→ Total Commander 批量重命名(序号补齐4位数 / 正文区0001开始 / 目录前0000_00_x / 目录后 0000_YY)
→ ComicsEnhancer Pro处理(放大/切边/黑白二值化+底色透明, 图片 5450*8600 300DPI, 1.4GB)
→ Picture Capture 画线/OCR
→ 检查画线
→ 校对词条
通过网盘分享的文件:古今汉语词典_Picture_Capture
链接: 百度网盘 请输入提取码 提取码: br35
文件包含处理后的高清PNG + Picture_Capture的文件夹,直接解压,用该软件【项目中心】中新建项目打开解压后的文件夹即可工作。
基于楼主的索引进行了双向的数量校正,然后填充,最后根据PaddleOCR结果进行了一定程度的校正,未一页页精细校对:正文页面范围 0001-1961,合计44713画线
Fince
16
你的数据很有帮助!我预计今天晚上就能发布一个难免还会有很多正文错漏的文字版初版。不知道你的软件有没有考虑同步开发mac/linux版。(可以用github action进行自动打包)
你可以看看,按理说应该是支持的。仓库里(或者最新发布包)包含了3个平台的安装文件,云端测试是ok的;但我没有在MAC/LINUX实际测试过。
Fince
18
我之前图片版修改之后还是比你少了两个词头,刚才看了一下我少了“随顺”和“奤”两个词头,因为我用的pdf版本和你的不一样,我的版本的随顺一词前面的左括号有缺损,导致没识别出来
看到你的PR了,需要等我这里一个大方向的核心内容修改为比较稳定以后再去merge