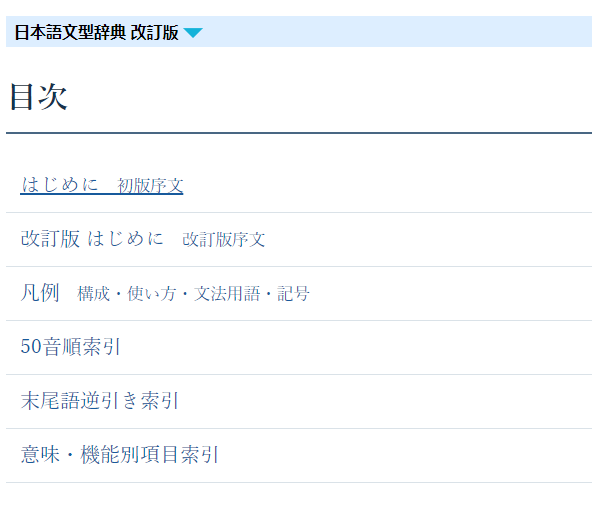
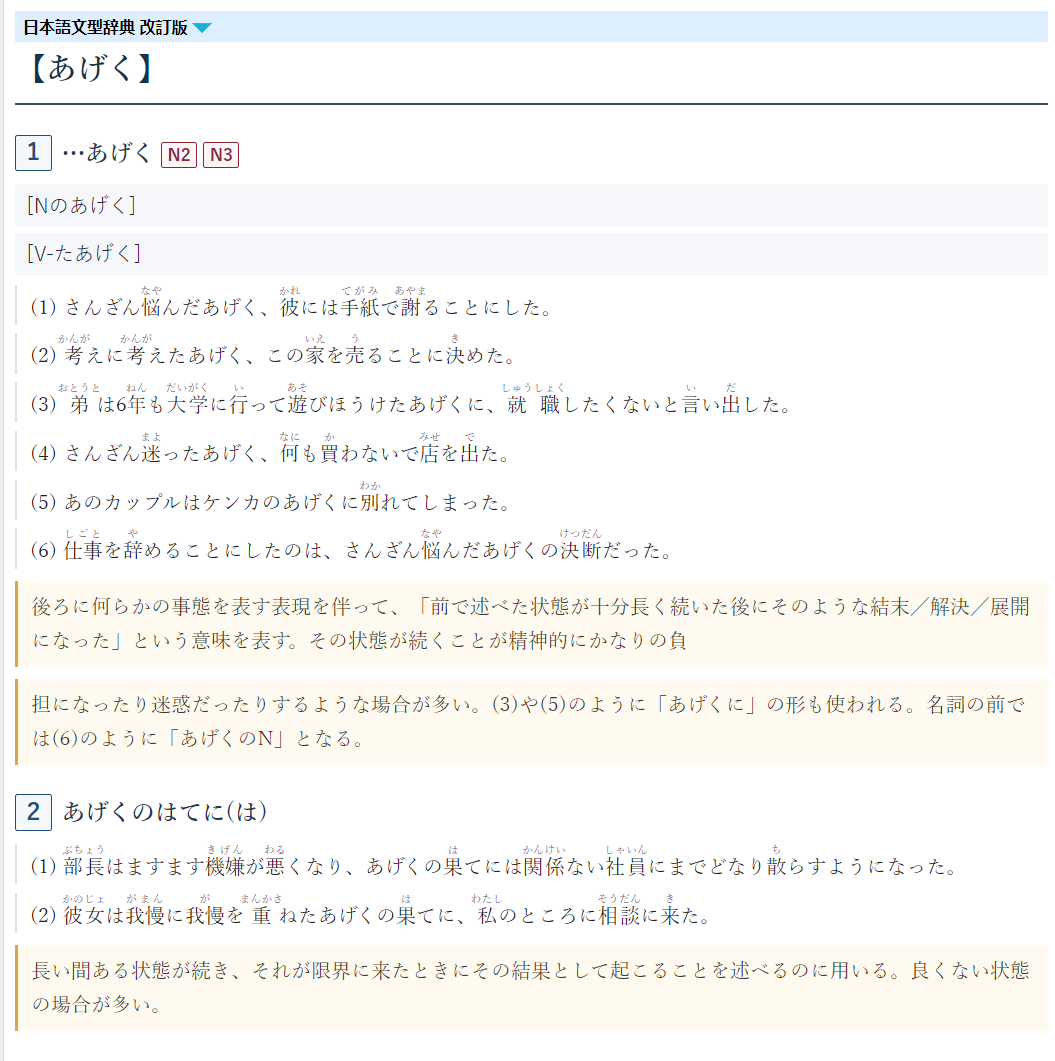
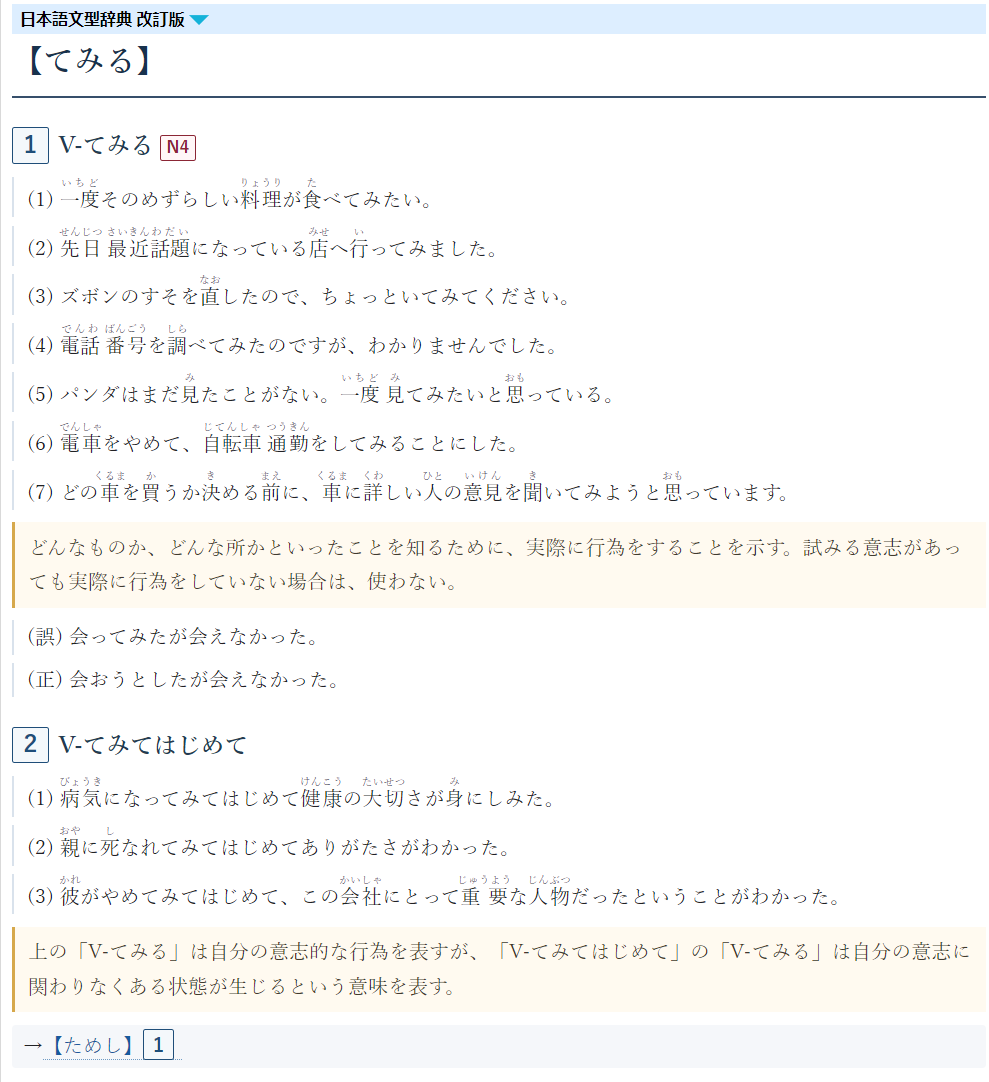
这个辞典页数不多,主要麻烦在ruby,直接加ruby容易出现多音字问题,这次我让ai用局部ocr方式加ruby,然后对照词典验证读音,然后我手动校对了1500处多音的ruby,以及粗略校对了文本,原书三种索引也完全还原了。
其实一开始是想测试qwen35-ocr-jp-2b-gguf这个模型来ocr的,结果发现这个模型虽然能直接输出带ruby的html,但输出的不是原书内容,有大量幻觉,最后只能改用找文本位置然后上移局部ocr的方案。
下载:
通过网盘分享的文件:日本語文型辞典 改訂版
链接: 百度网盘 请输入提取码 提取码: 1234
或
日本語文型辞典 改訂版 - FreeMdict Cloud
AI图标:
神农X
2
Fince
4
qwen的模型做OCR是容易有幻觉,包括阿里自己训练的ovisocr2,我实测8bit精度下特定情况会触发循环输出,优点是有些内容比paddle更容易识别准。
我其实是用mineru做主文本的,对比paddleocr以及chromelens定位还不错,mineru特别是层级结构保持很好,但缺点是有时会丢假名。
qwen我之前用的是一个特化模型测试,这个模型是特别针对日语微调的,可以直接输出html的ruby格式,漢字
Fince
6
你的mineru是用的本地版吗,我之前下了个mineru2.5-pro-2605-1.2b_Q8_0感觉效果不是太令我满意
Fince
8
我用在线版按每两百页一次识别,有时候会有识别失败的情况,不知道是不是触发违禁词或者什么了