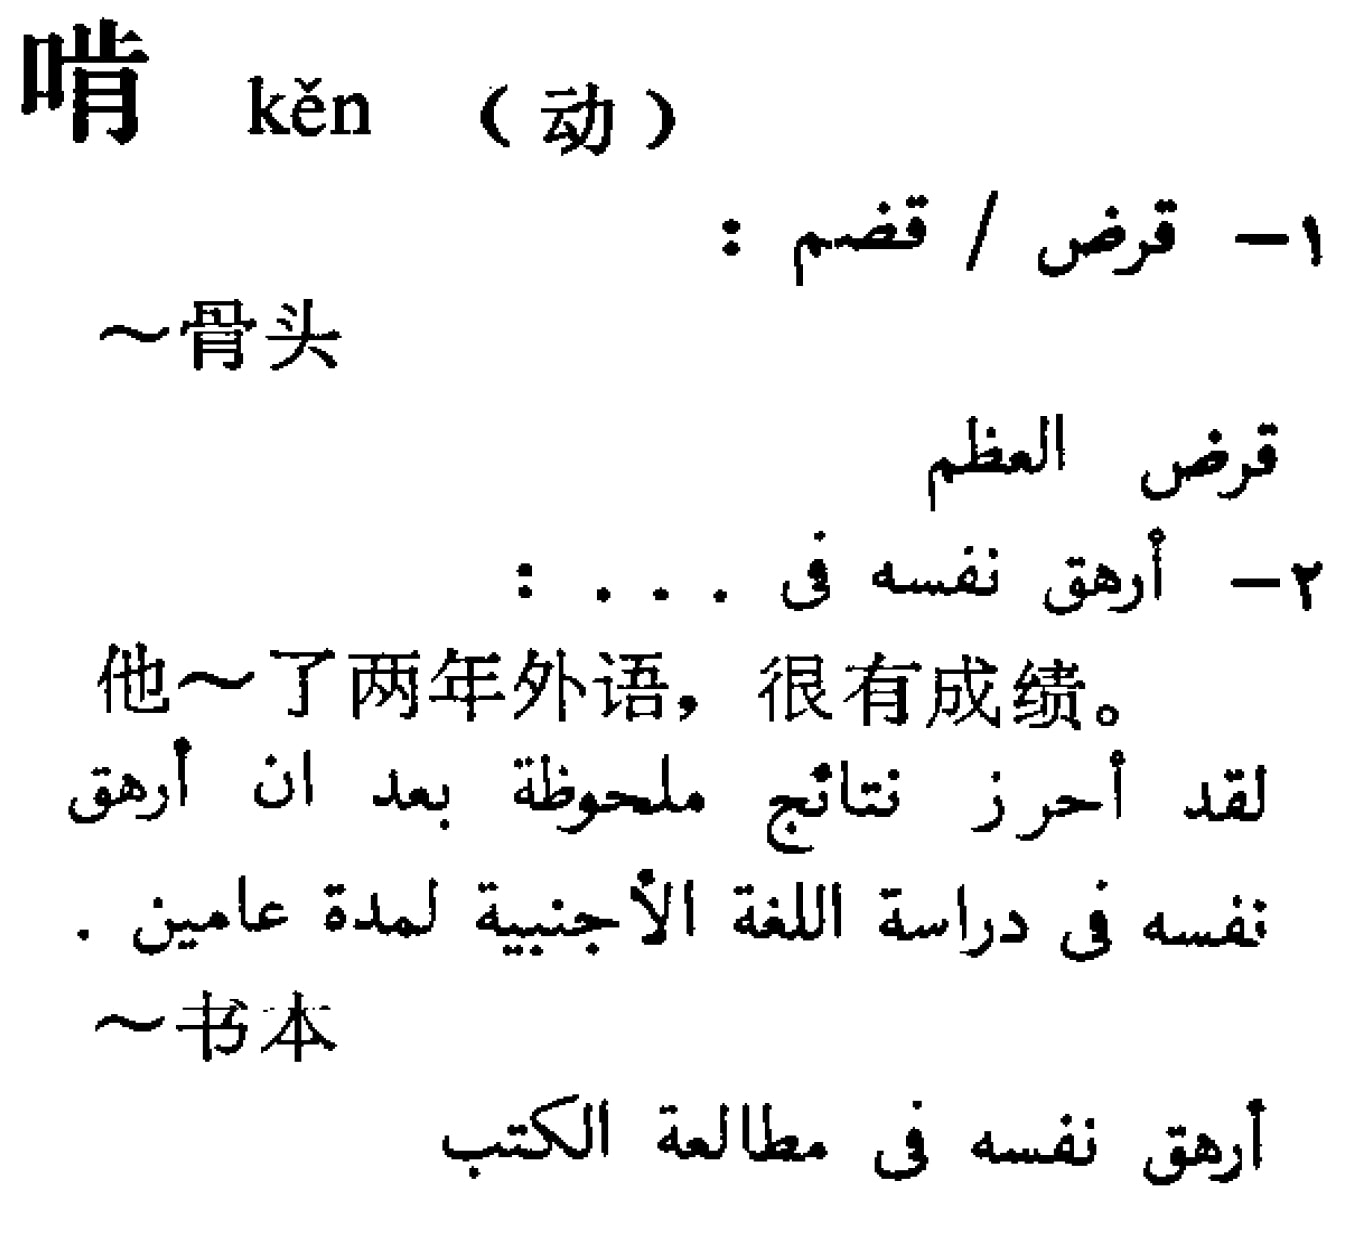
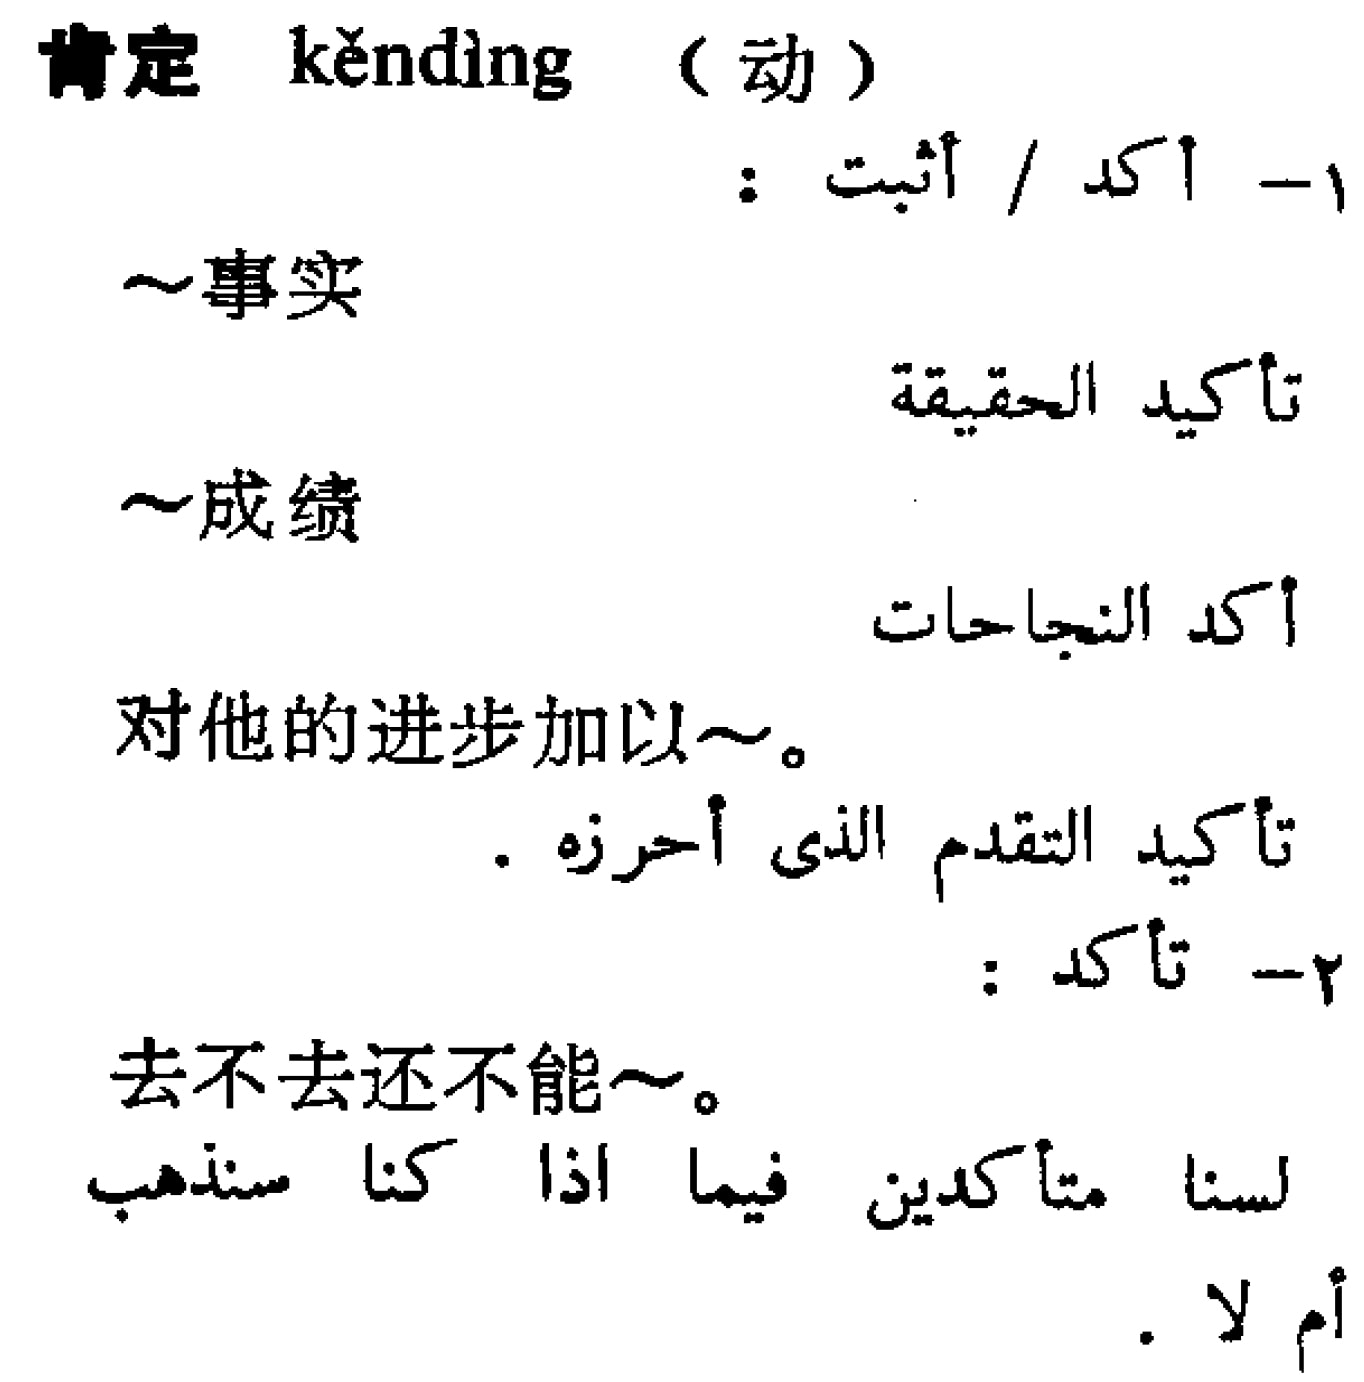
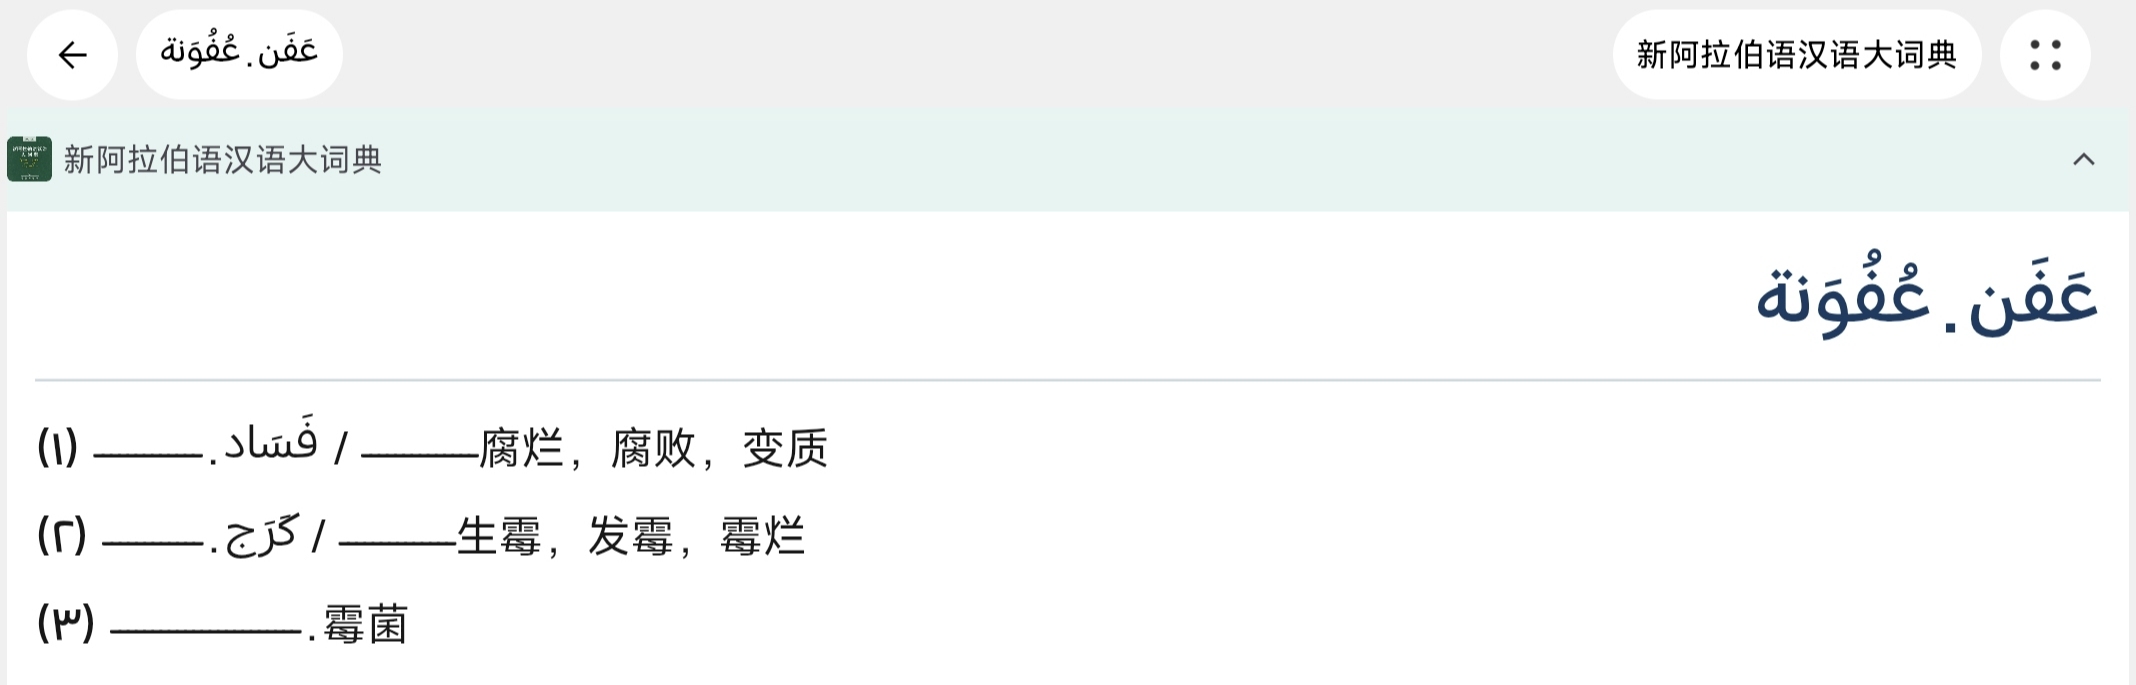
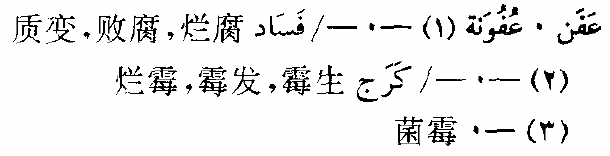
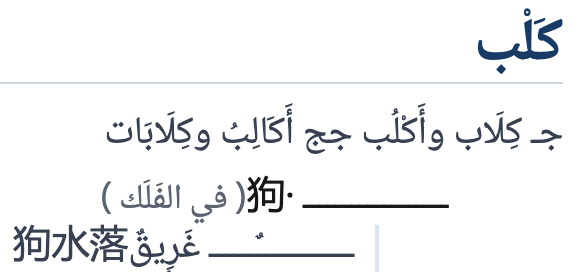
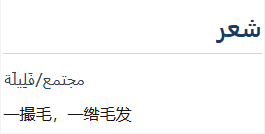
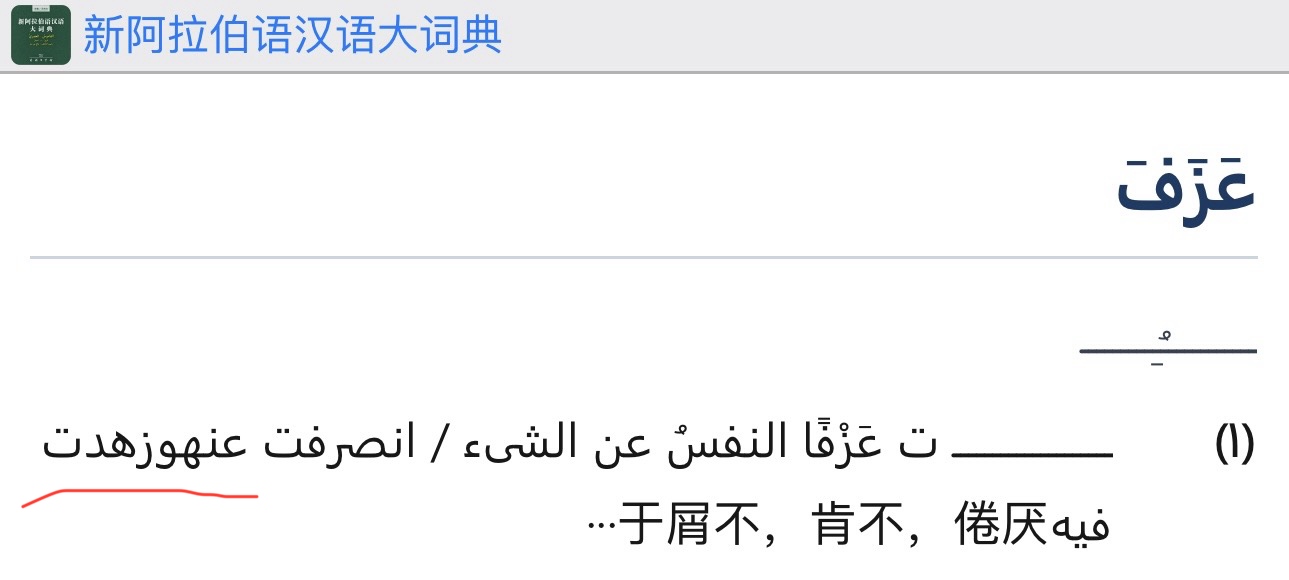
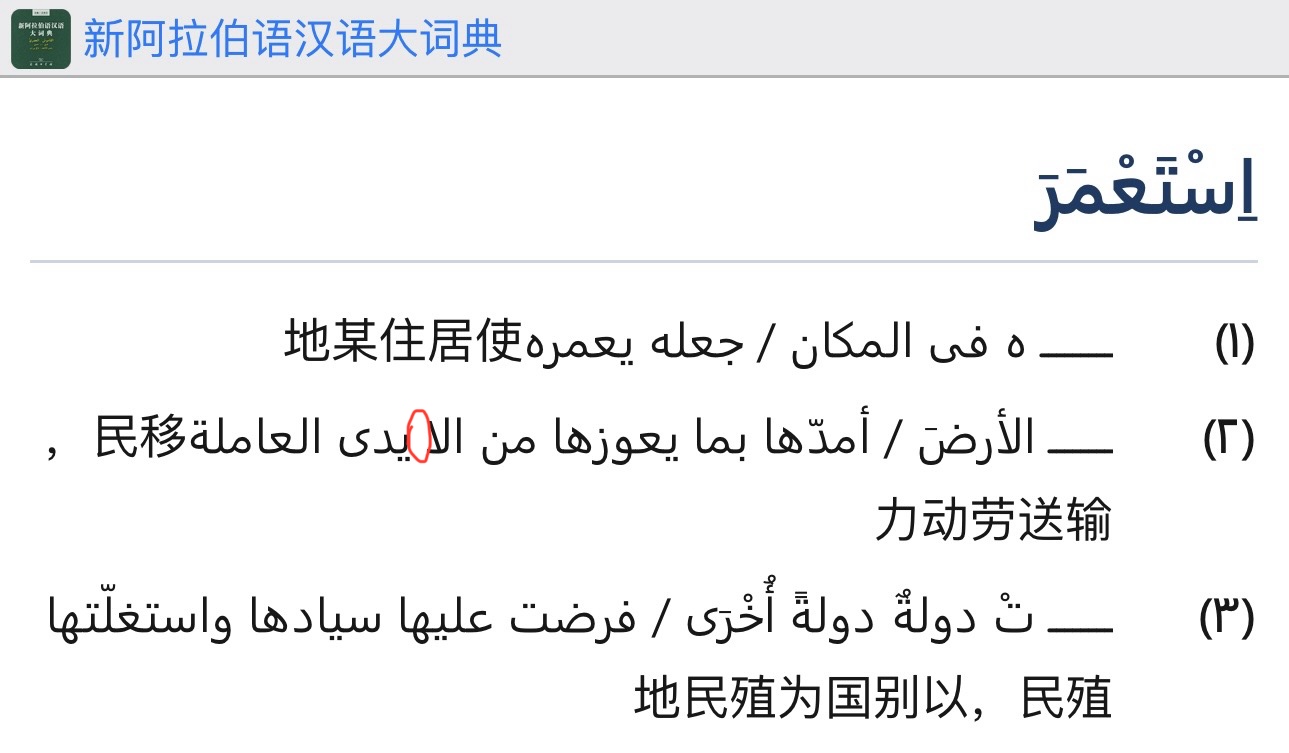
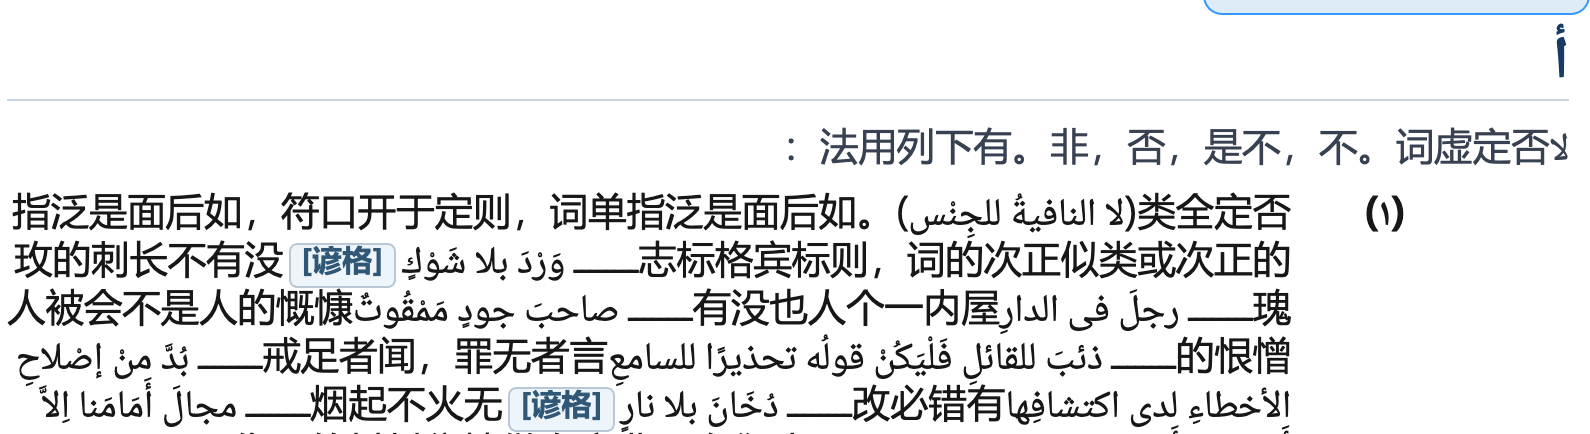
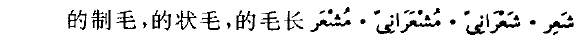特别感谢 @bud 之前提供了xml数据,我结合这个和原版pdf,修复了大量层级错误,rtl错误和部分私用字问题,终于制作完成了这本词典,这本应该是目前最大的阿汉词典)
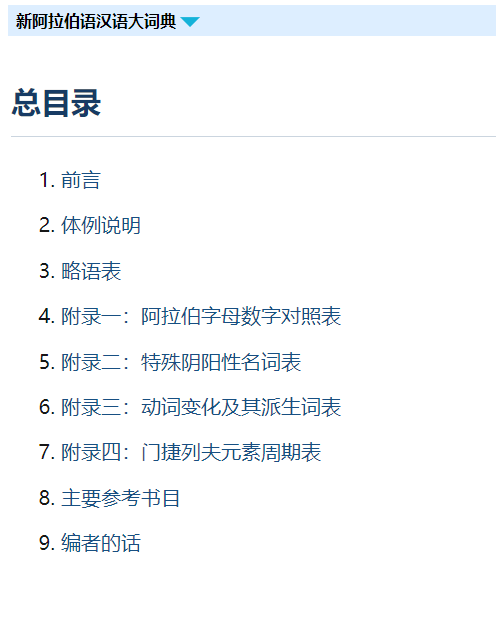
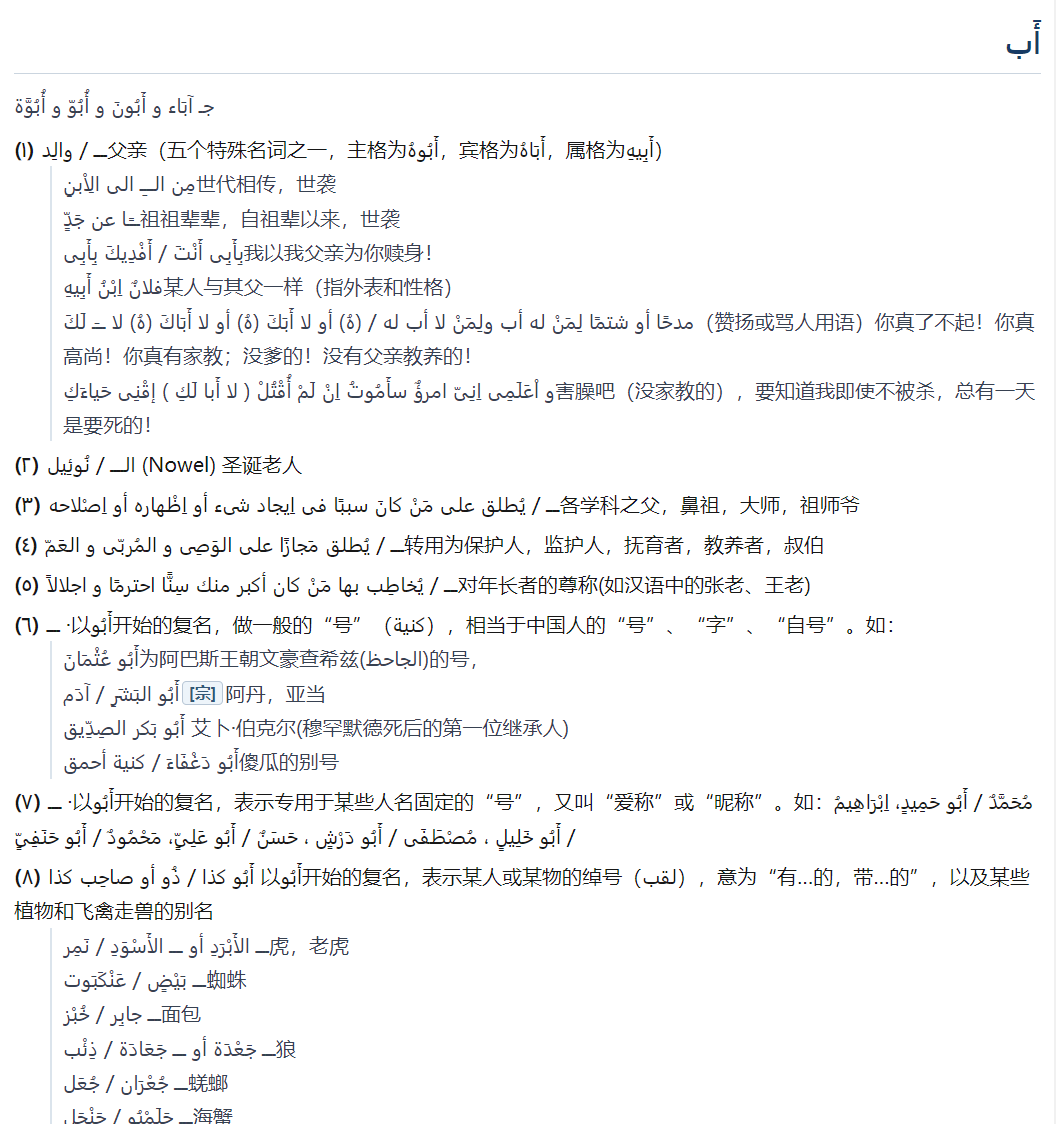
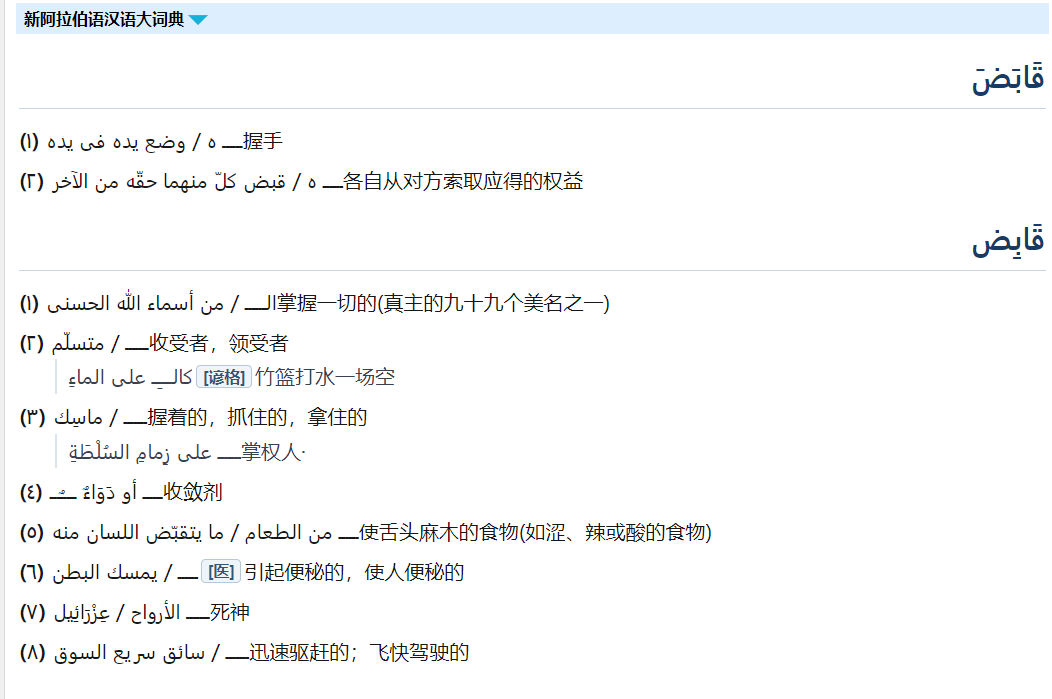
此外原版是全rtl的,这里提供了两版本css,直接改名为XAHDCD.css即可
ltr版式:

接近原版的rtl版式
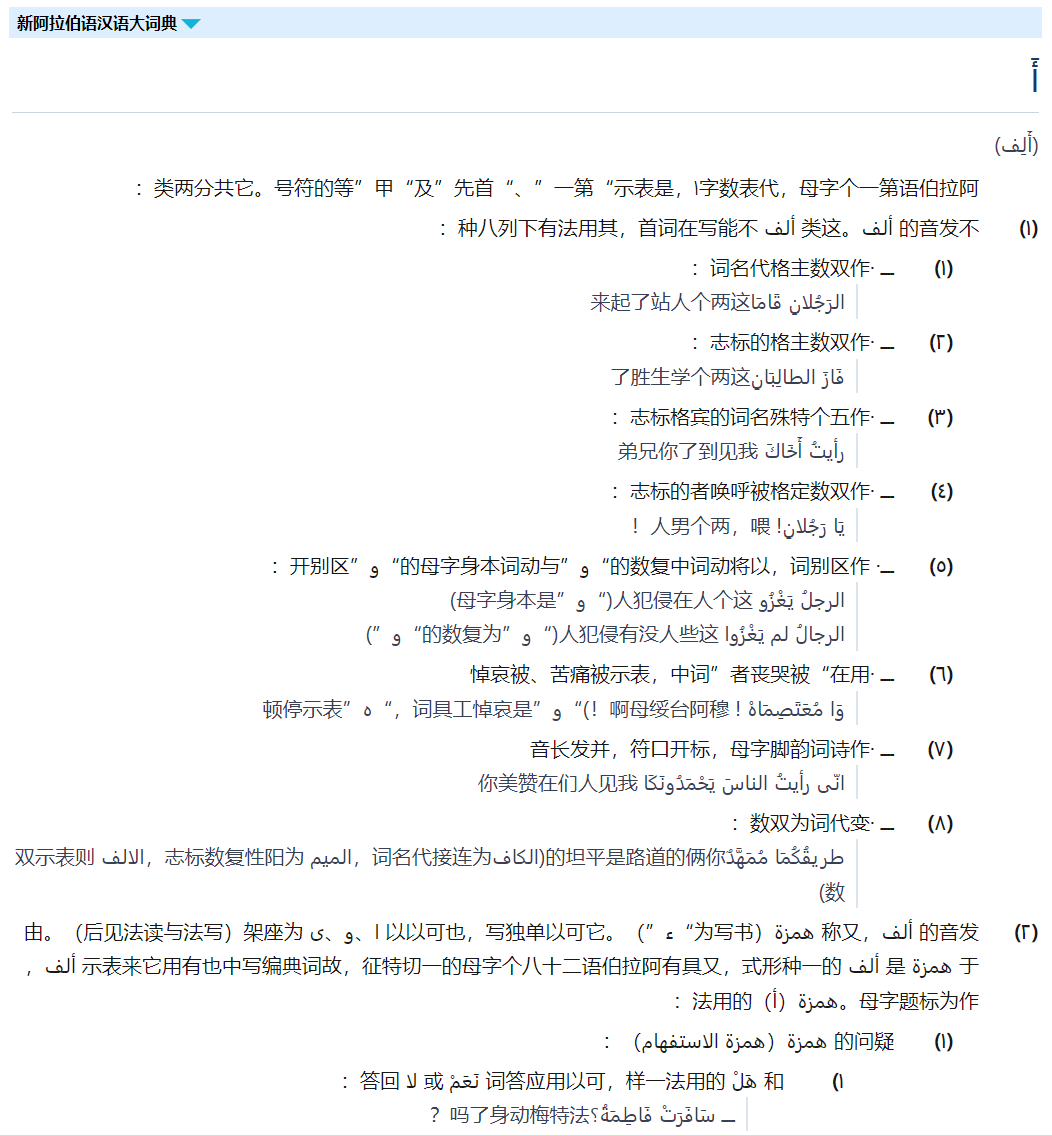
下载:
通过网盘分享的文件:新阿拉伯语汉语大词典
链接: 百度网盘 请输入提取码 提取码: 1234
或
新阿拉伯语汉语大词典 - FreeMdict Cloud
AI图标:
特别感谢 @bud 之前提供了xml数据,我结合这个和原版pdf,修复了大量层级错误,rtl错误和部分私用字问题,终于制作完成了这本词典,这本应该是目前最大的阿汉词典)
下载:
通过网盘分享的文件:新阿拉伯语汉语大词典
链接: 百度网盘 请输入提取码 提取码: 1234
或
新阿拉伯语汉语大词典 - FreeMdict Cloud
AI图标:
 是官網的數據吧 ;)
是的,不过原数据因为rtl问题版面都是乱的,然后前言附录是让ai直接格式化的
感谢制作,我早有这本没制作。
不过这部不是最大,王老师有一本叫“高级阿汉词典” 全书共收词70,000条。(67911词条)。
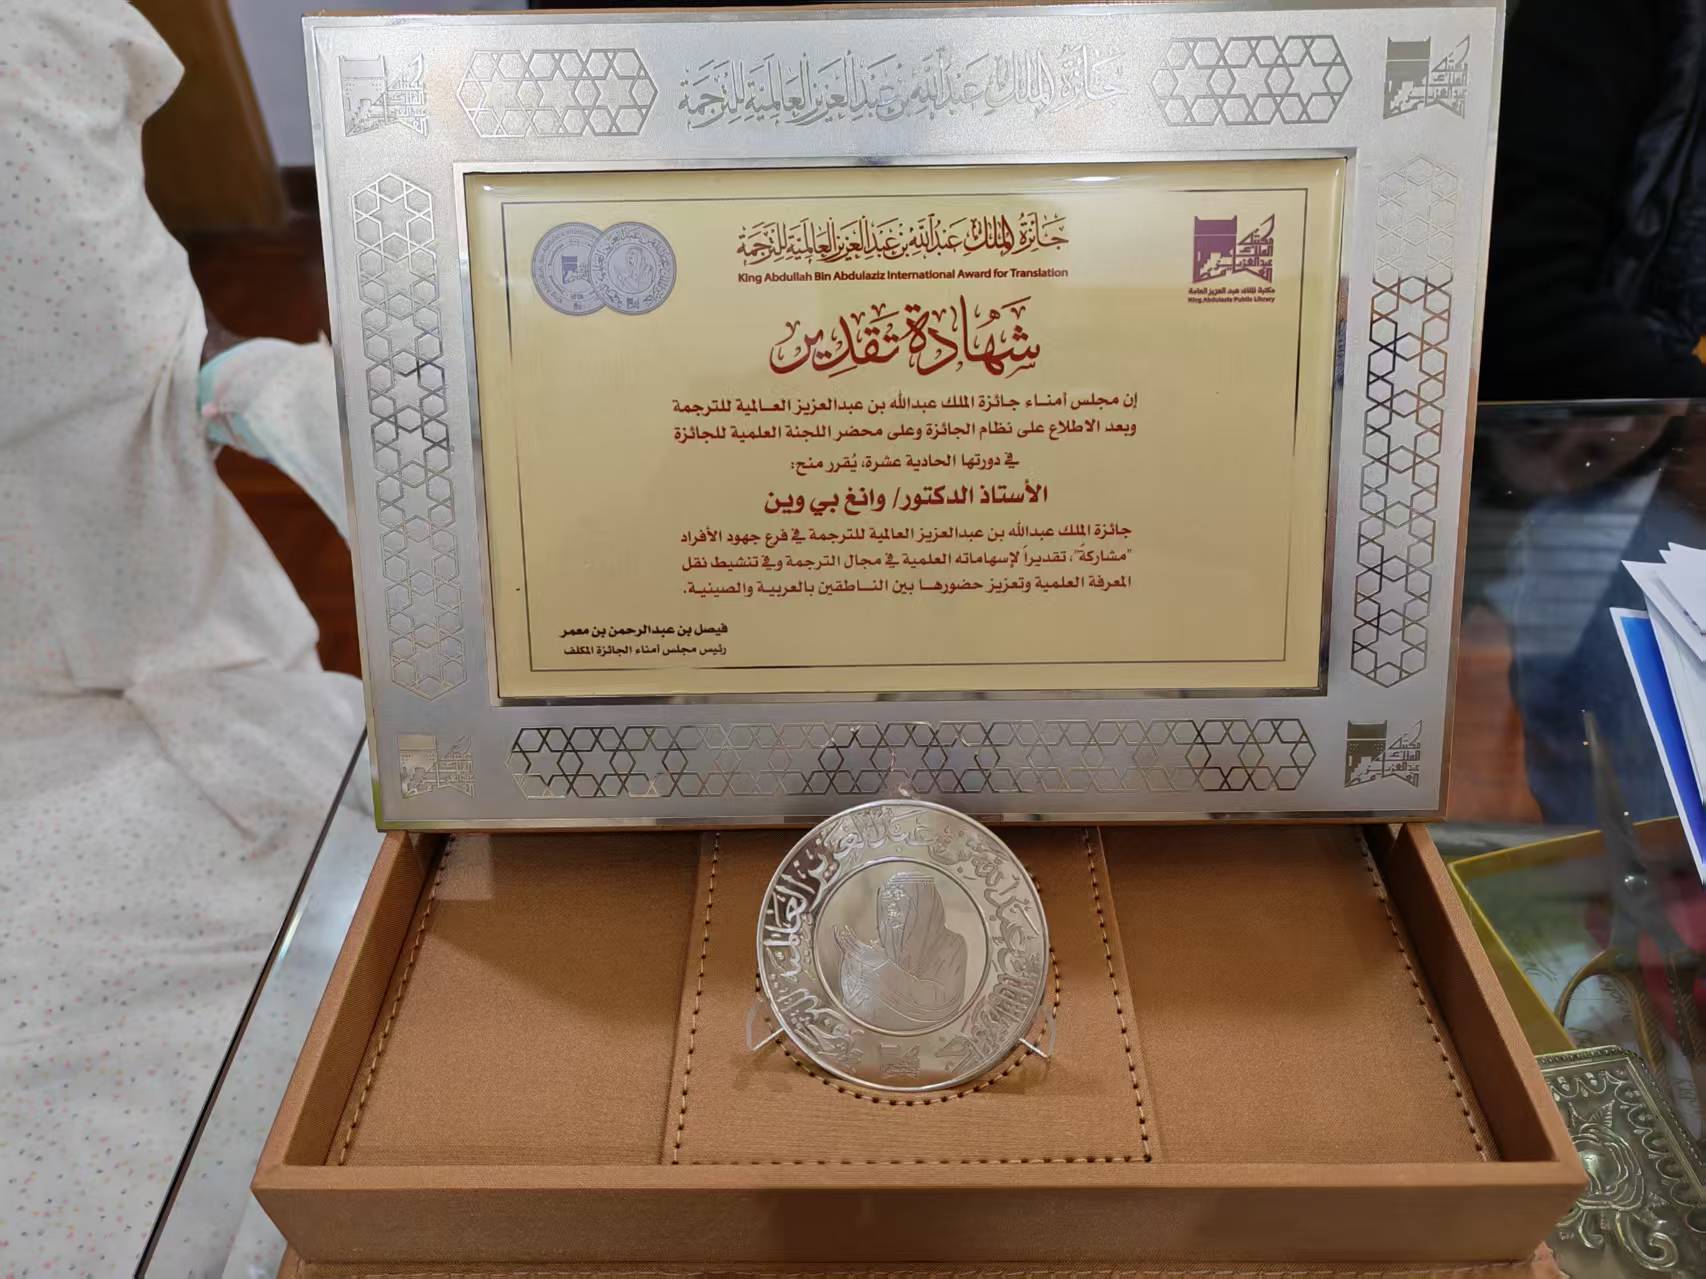
我分享王培文教授获得亇人阿卜杜拉国王奖亇人贡献奖喜讯。国内好多人不知道王老师获得第十一届阿卜杜拉国王全球翻译奖
自2014年朱威烈教授获此奖后,这十多年来中国学者再获此大奖,这不仅是王教授亇人的荣誉,而且也是中国的荣耀。
下面是第十一届阿卜杜拉国王全球翻译奖新的闻公报网址截图。
哦,我是看介绍这本写的是有8万词条得出这本最大的。《高级阿汉词典》写的7万词条,但这本8万词条有很大水分,因为我也没学阿语,所以没法做ocr校对,所以另外两本阿汉词典都没有制作
这个问题我晚点修复一下
那应该这是修订版,2003年的。其实,有两款app比官方早做了电子版 麦阿尼阿汉词典 及WPT Chinese-Arabic Dictionary 在线词典 ,他们不是OCR的,而是录入项目
《高级阿汉词典》只有切图版mdx
现在已经修复了rtl问题,然后让ai补了复数索引,中文强制换行不太好改
用ocr版本做了全文对比排查,发现有470个高置信疑似缺词,但可能是源数据结构问题,我看看能不能修复。
话说这数据是ocr的么,阿语,适配的OCR软件估计不多吧
不是,前面写了是之前vdict泄露的xml,中阿混排的gemini,mineru和chrome lens可以识别,其他的都不太行。
让ai检查了一轮,缺词和报告的其他问题都修复了
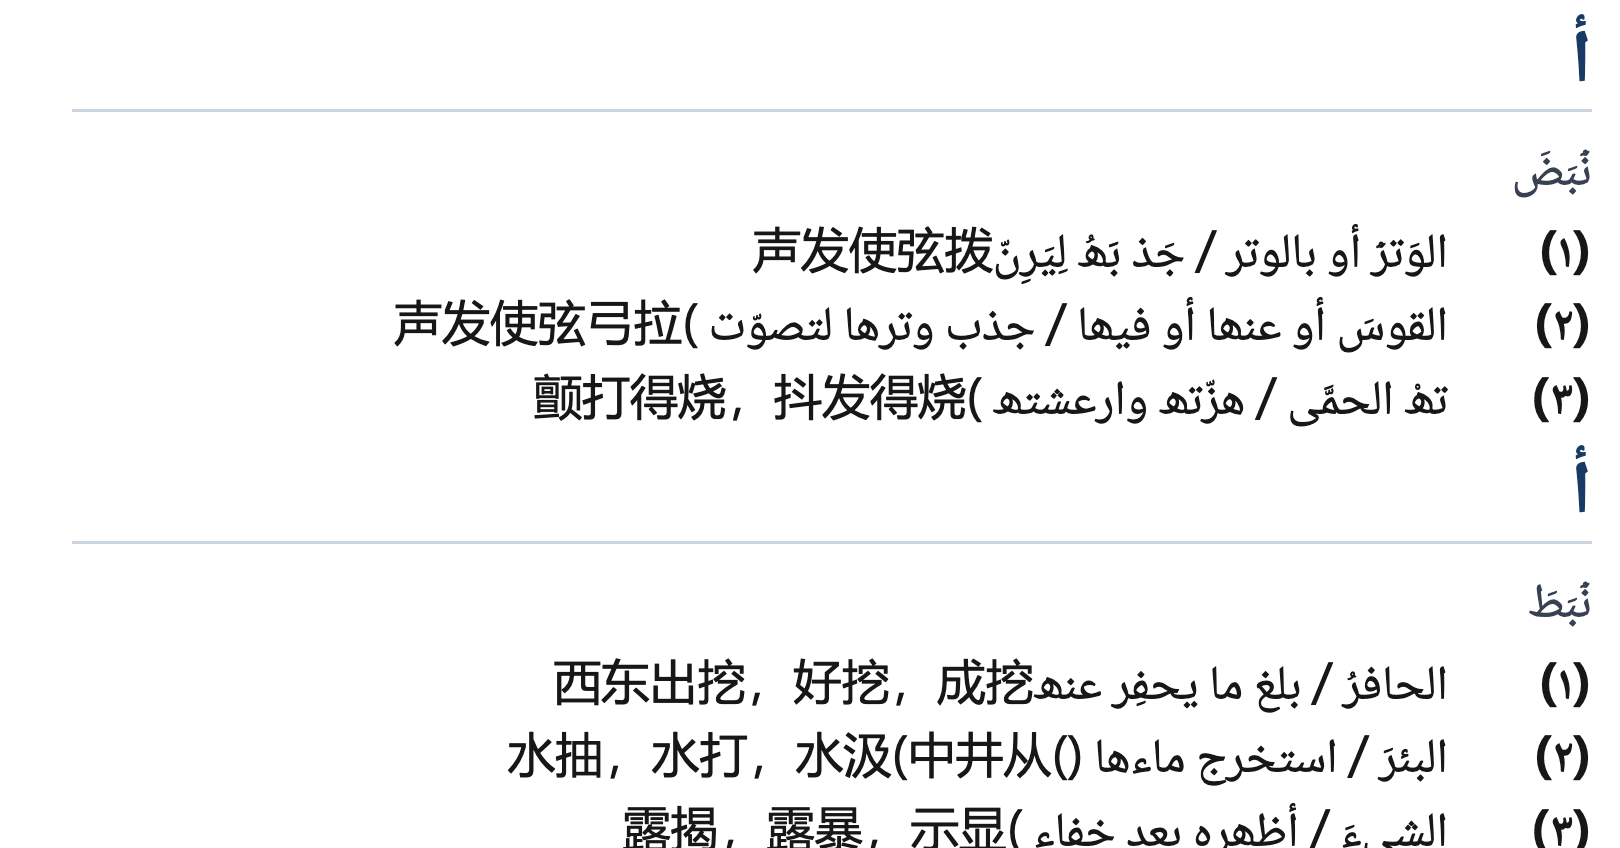
感谢持续更新。أنبض和أنبط正常了,但نبض和نبط没有了。另外常用词غرفة的查询结果也有问题,出来的只是一个词组条目غرفة منه。
在能正确查得的情况下,这个数据质量是很好的。
又修订了一下,这些问题解决了