昨天被受到群友启发准备看看mdx的文件占用还能不能压缩——因为我怀疑html这种格式是否真的对词典条目友好。然后就用夜间免费的鸡蛋做了个demo——GLM 5.3 Flash拉完了,搓了个壳到处是坑,最后修bug用的token比晚上省的多。


依赖: GitHub - lonelam/mdictlib · GitHub
AALookup: https://aalookup.com/
这个每天改完要导出保存吗?
对的,因为所有改动都放内存里了…… 
如果非要谈压缩率的话明显是mdx解包为txt mdd解包为文件夹 然后用7zip/winrar更高效…
这应该是没有用的,mdx和mdd本身在打包的时候就会要求zlib压缩一层,所以无论用什么算法都没办法往下再压缩很多了。
我自己试了一下oaldpex只能压到现在的70%,这是导出的时候根据资源类型进行有损压缩的结果。

但是你这样没办法发出去给用户用啊,除非有App能直接把zip包当词典解析,而且我非常怀疑rar/7z是否就比zip有更高压缩率。
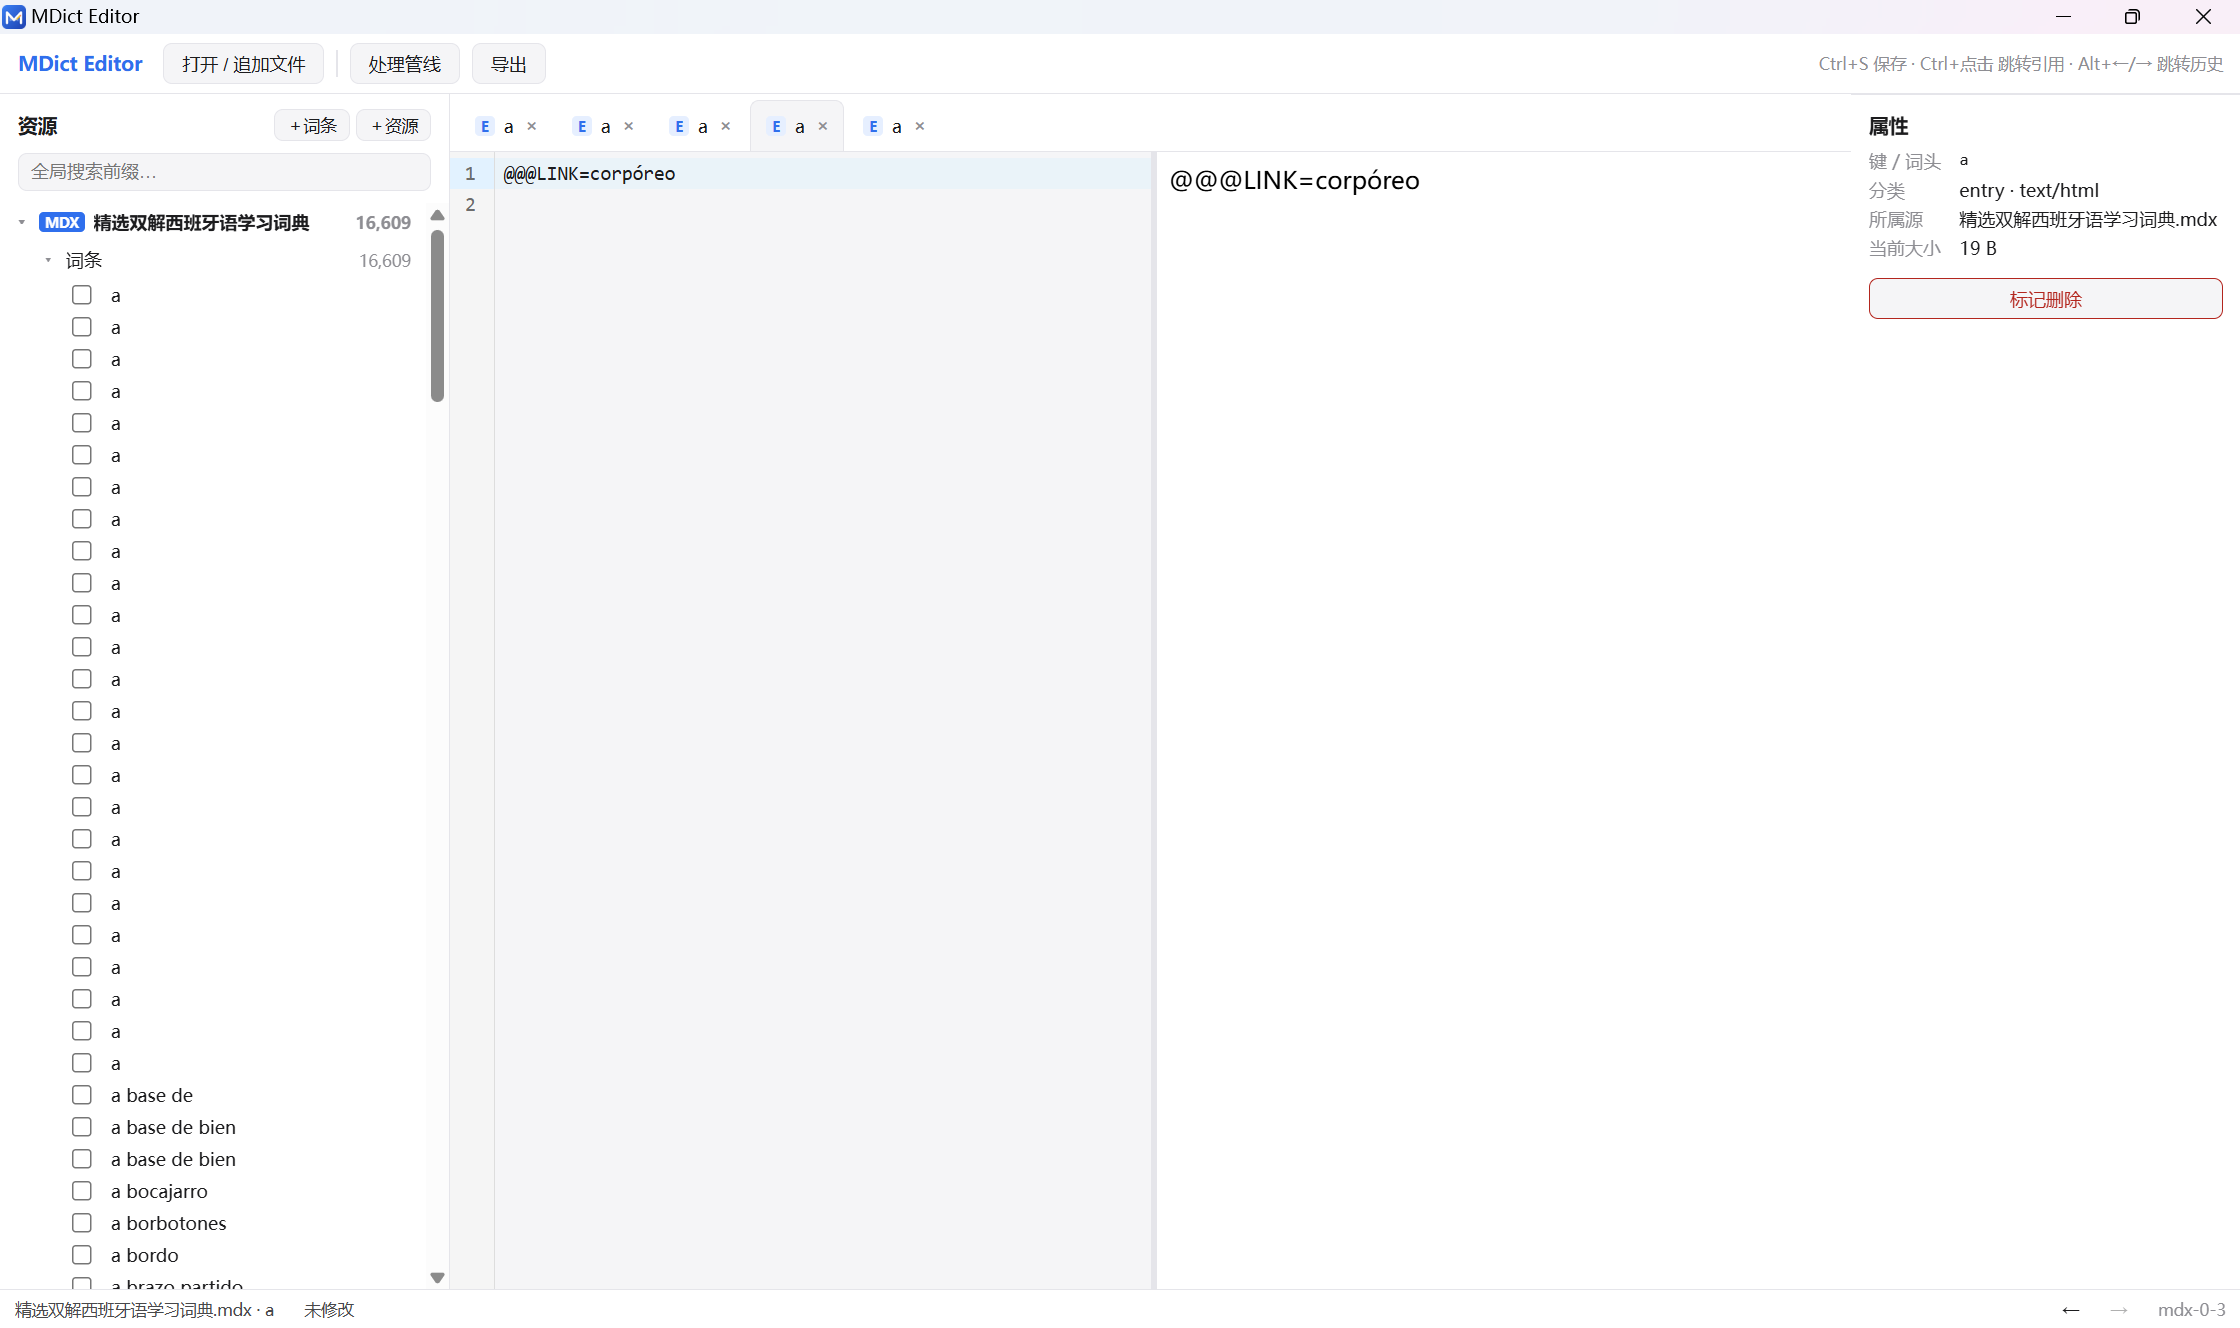
这个我觉得有必要支持一下。当时天才程序员下线了。
请问你的修改是跨天的吗?范围很大吗?我觉得有必要支持一下txt目录这种,但是我自己改词典并不是很多,而且大部分都是AI,没有这种需求……
很多词典,尤其是OCR的那一堆都缺乏校对啊,有时间要一点点改。不过能改的都规模不大,做不做都行。
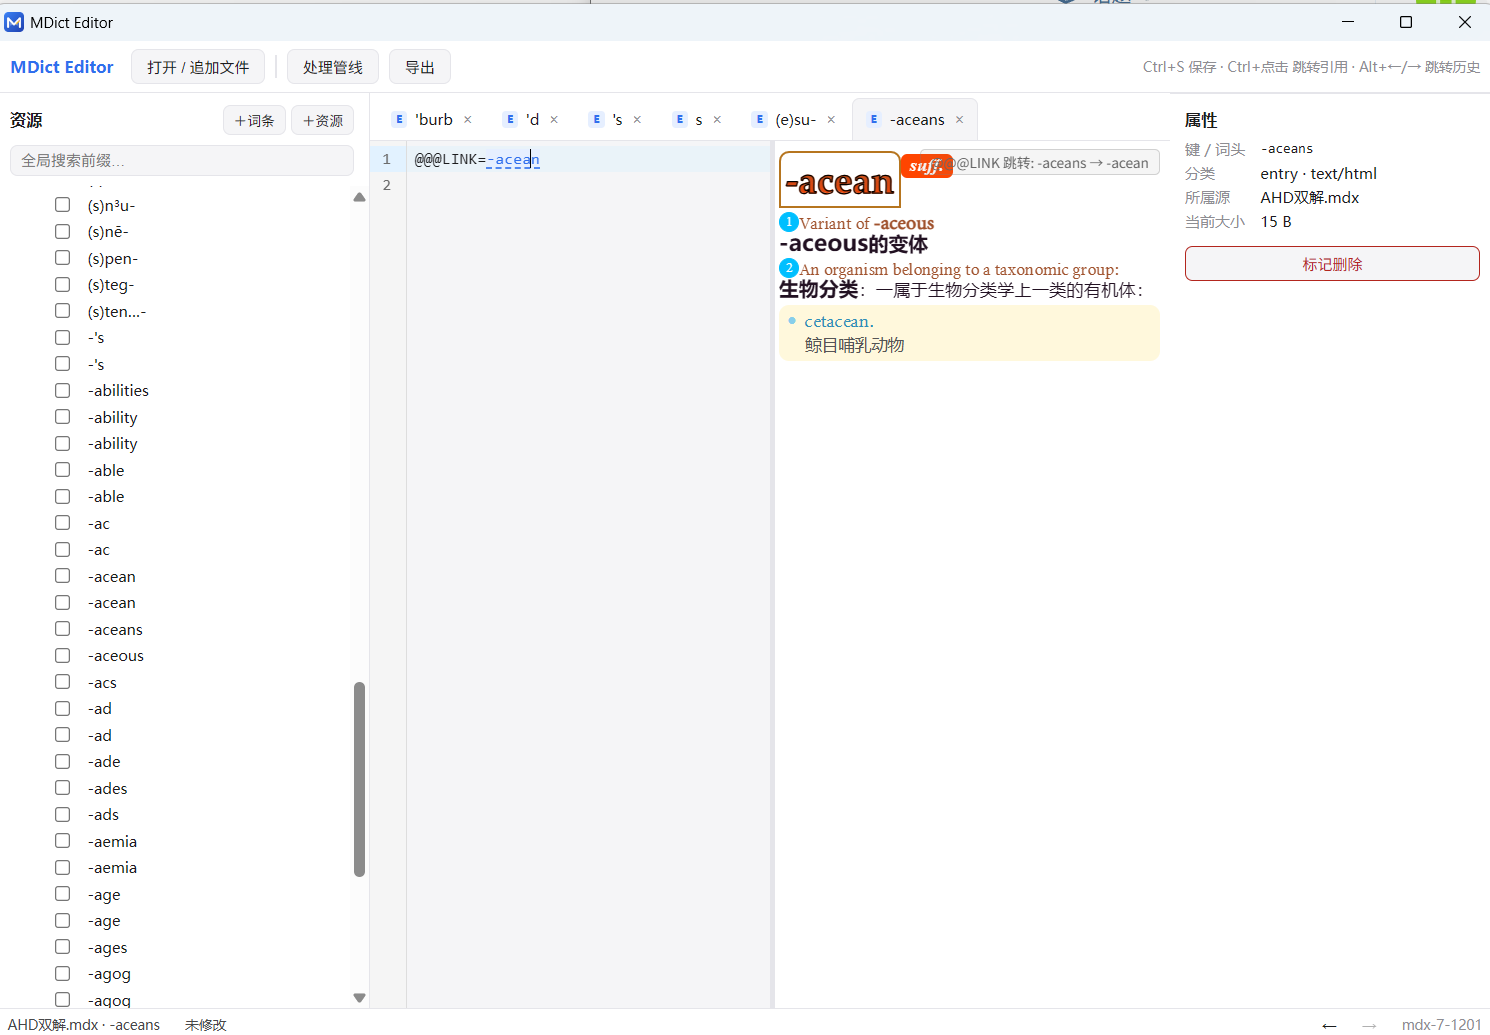
如果发现词头(key)错了好像还不能直接改,有无可能加上这个功能?
感觉是个很有必要的功能……
可以改了,不过覆盖层要保存下来还是挺麻烦的,不想做。先补一个原地导出就当是临时保存了吧。
我的需求是不解包在内存里看mdx/mdd的内容物,这个看起来挺不错的,之前站里的Preview看词条代码的方式太间接了,而且貌似不支持mdd
不过还是挑一点刺:
- 想要portable版本,加个打包产物方便吗,不方便就算了
- 希望mdd的文件列表不是所有文件平铺而是按目录分级的
很神秘,不知道为什么,中间的分割线按住向右拉,速度快了就会脱手,但是向左拉就不会
Portable应该没啥问题……有空了加。
目录分级不好搞,欢迎PR。
等我下次想看mdd内容物的时候研究一下,这一轮折腾差不多了
emmm,欢迎折腾