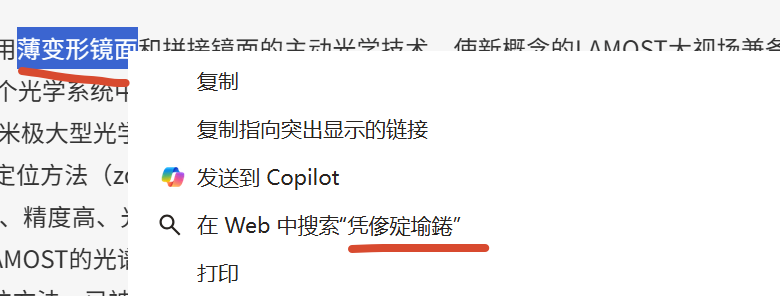
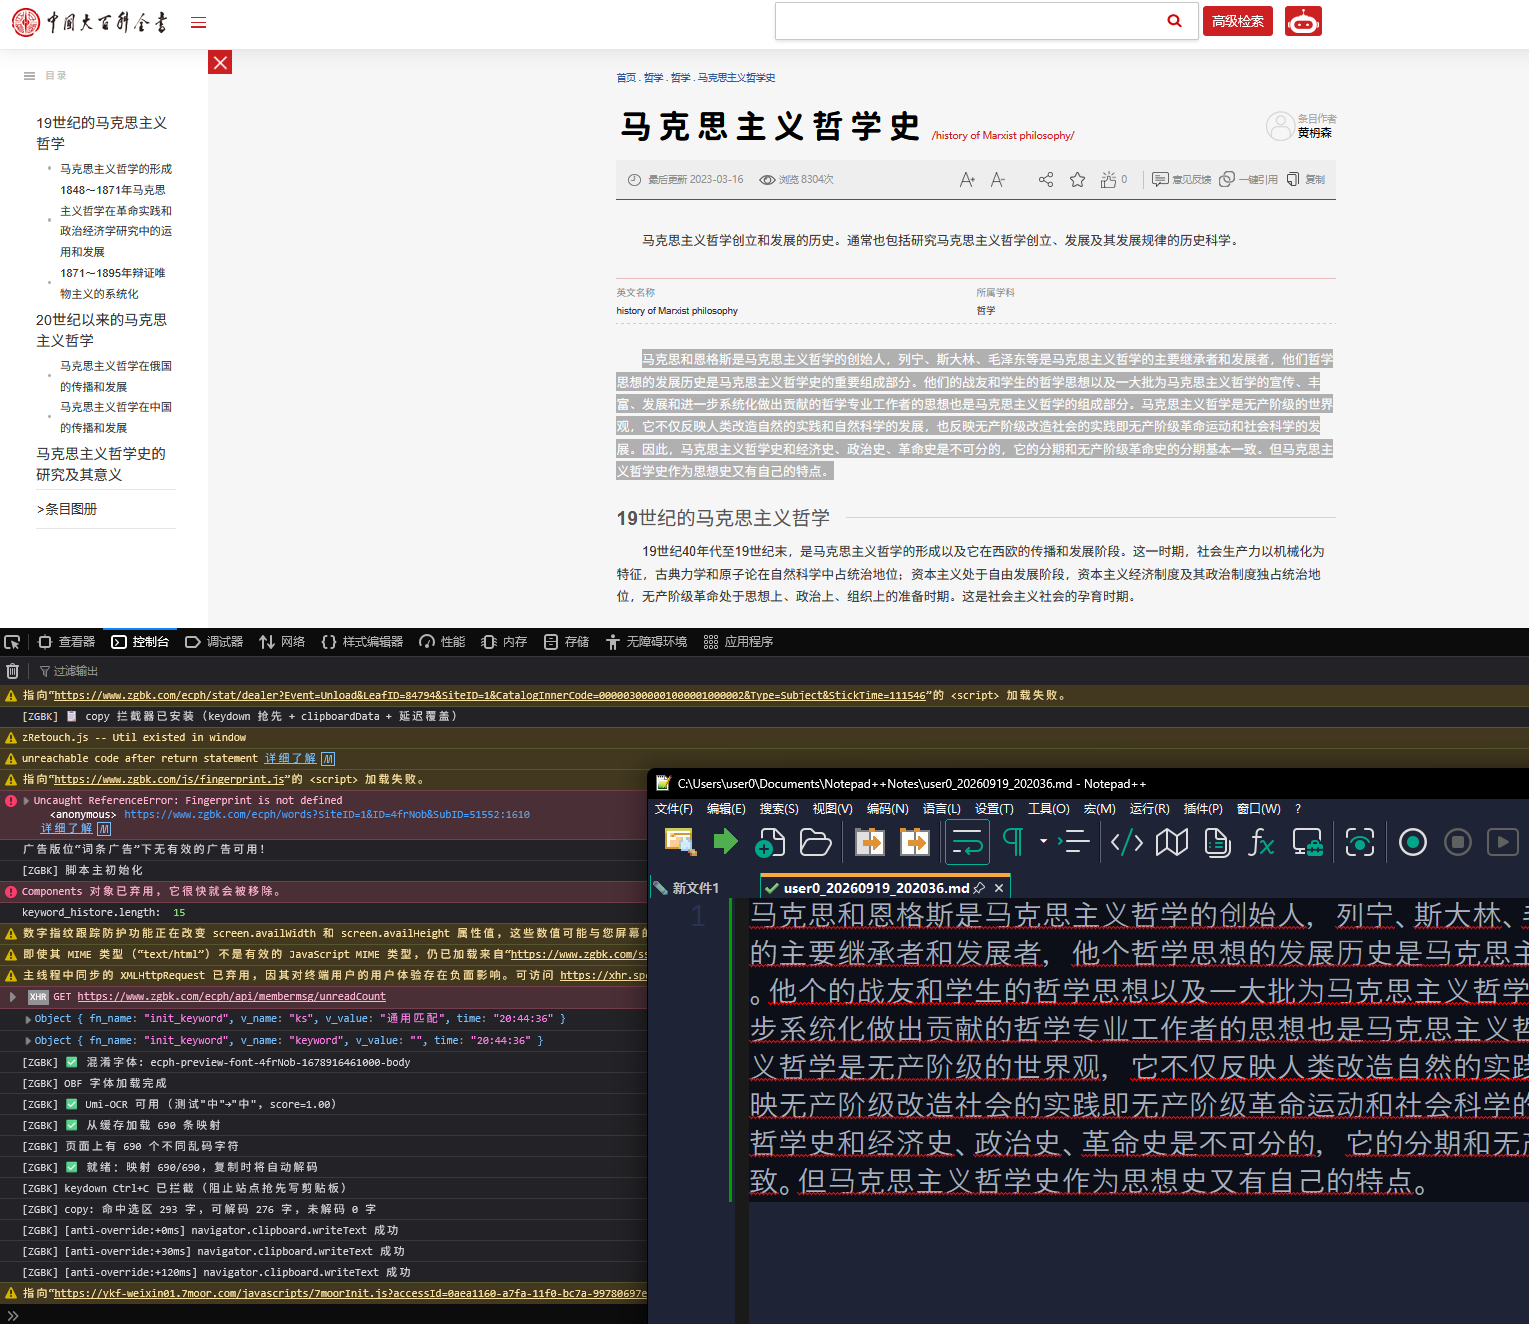
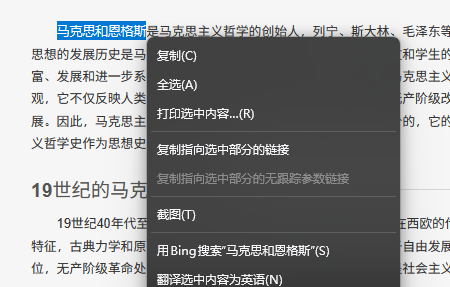
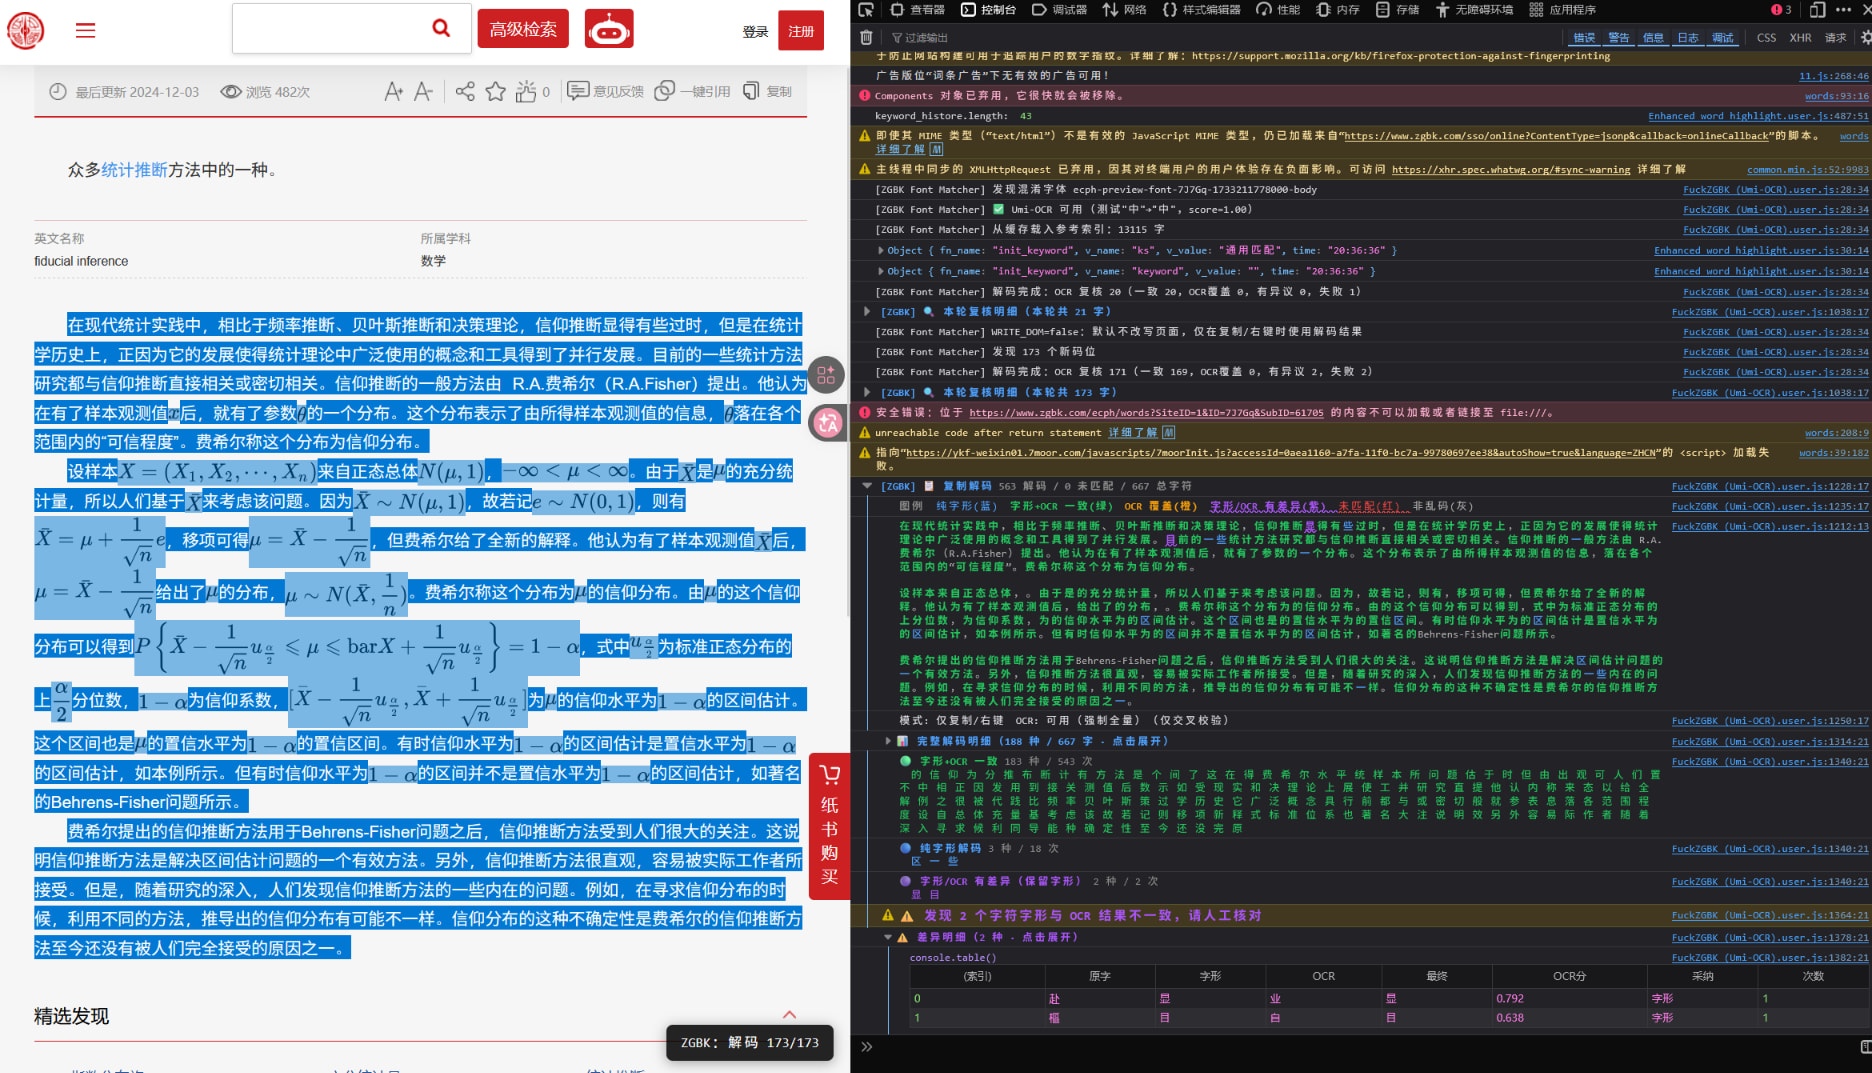
意外发现的一个插件,可以解除中国大百科全书(www.zgbk.com)的浏览限制,移除对右键、F12等操作的屏蔽。Lift browsing restrictions on the Encyclopedia of China (www.zgbk.com) and remove blocks on right-clicking, pressing F12, and other actions.
地址:FuckZGBK
——————
各位大佬在下面各显神威,看来这帖子也算抛砖引玉啦 
意外发现的一个插件,可以解除中国大百科全书(www.zgbk.com)的浏览限制,移除对右键、F12等操作的屏蔽。Lift browsing restrictions on the Encyclopedia of China (www.zgbk.com) and remove blocks on right-clicking, pressing F12, and other actions.
地址:FuckZGBK
——————
各位大佬在下面各显神威,看来这帖子也算抛砖引玉啦
是的,配合ocr用还可以,乱码是随机生成的,直接拿文本有点难 
我发布了基于 Umi-OCR 实现的可复制脚本插件
神速啊,不知道有了这个是不是可以抓取了,zgbk反爬不知道严不严
汗颜,怎么可能OCR爬虫,字体解密就行了。大家都不在意准确度了吗,所以最近论坛OCR+AI校对特别火吗。
我的意思是爬虫配合这个插件和OCR,交给AI,不知道可行不可行 纯猜想哈 
没会员的话,只能浏览几个词条吧
正确方法是找到原字体,得到正确的码表,对曲线做hash,然后根据曲线hash来确定对应unicode,这个我之前做pdf无cid的字体时就是用的这个方法,字体实际显示的曲线是不可能随便换的。
厉害厉害,给大佬敬茶
让ai写了个字体hash还原版,基于之前 @via 的版本改的
AI写的最好审核一下吧:是thin字重,不要选VF字体徒增加载字体大小,而且不要选github源,明明有很多字体公益CDN可以国内直连,就是拿谷歌的 fonts.gstatic.cn都比github快。网页字体加载你选woff2比ttf理想得多。。。
确实是让ai临时写的,没仔细看,不过thin应该是不对的,就是regular。现已改为woff2,换成了fonts.gstatic.cn,不过能上论坛和greasyfork的一般也应该能上github
之前版本没有处理非中文,也有动态加载检测问题,都已解决,又更新了一个版本
没注意网站的一层伪装,Postscript用的NotoSansSC-Thin,实际上是Regular字重。不过中国百科的字体混淆保护还是很初级,大部分国内网站都会改变曲线和字体改名。
https://greasyfork.org/zh-CN/scripts/596486-zgbk-umi-ocr
v9 版本将核心方案从纯 OCR 解码改为“字形指纹匹配为主 + Umi-OCR 交叉校验/兜底”,默认不改写页面、仅在复制/右键时替换,并新增了 详细控制台调试、切换阅读模式 和 打印解锁。
OPENAI给的方案也是字形指纹匹配;已经在慢慢dl了
这个好,不用安装Umi-OCR也基本能用了