gpt写代码很防御,非常喜欢写一堆测试,感觉没多大用
基于 Picture_Capture_v2.12.9_Release.zip 做了一些改造,并提交到 github,发布了一个新版本 2.13.0:
注意,这并非官方版本,纯粹是为了方便和理解,供参考。
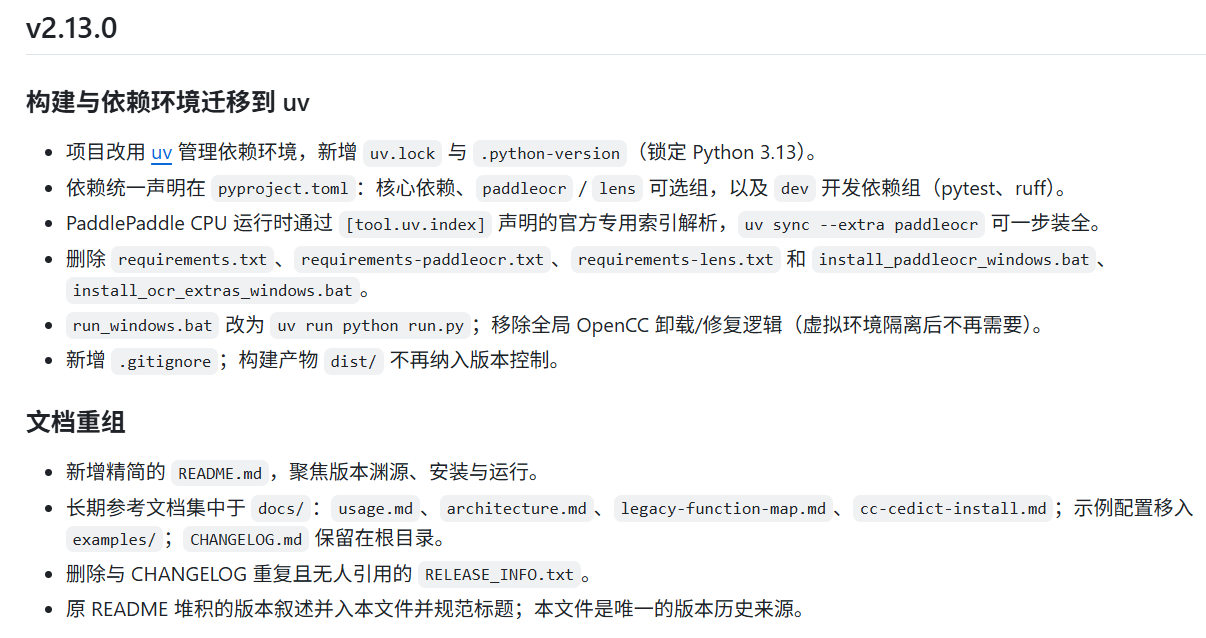
从 2.12.9 到 2.13.0 的核心是一次工程基线重塑,而非功能增补。
首先,项目把依赖与运行环境整体迁移到 uv:所有依赖统一在 pyproject.toml 中声明(核心依赖、paddleocr/lens 可选组、pytest/ruff 开发组),用 uv.lock 锁定全部版本、用 .python-version 固定 Python 3.13,并让 PaddlePaddle 的 CPU 运行时通过官方专用索引解析;同时删除了 requirements*.txt 与两个 install_*.bat,run_windows.bat 改为 uv run python run.py。这一变化必要性很高:原先脚本用 py -3 会落到本机的 Python 3.14,而 PaddleOCR 仅支持到 3.13,等于埋着一个"装了 OCR 却跑不起来"的隐患;全局 pip 安装还会污染系统环境、并让 uv sync 误删已装的 extras,这些都被隔离的 .venv 从根上消除。
其次,文档做了彻底重组:README 精简为真正的入口(版本渊源、安装运行、快速上手),长期参考拆分到 docs/usage.md,并把 architecture.md、legacy-function-map.md、cc-cedict-install.md 归入 docs/、示例配置归入 examples/,删除了与 CHANGELOG 重复的 RELEASE_INFO.txt,并让 CHANGELOG 成为唯一的版本历史来源(规范化标题、去重、严格降序)。这样做的意义在于:把原本堆积在 README、分散在多处的信息收敛成清晰、可导航的结构,为后续提供一个可复现、隔离、且随时可回滚的稳固起点。
期待参考我的上述仓库的样式(仓库内是代码本身,文档结构清晰,发布包使用 tag 或 release),这样大家更方便跟进你的最新版本,以及直接给你的仓库PR。你现有的仓库是发布包,没办法进行PR。
- 後續我將優化參數及其窗口、使用説明;
- 此外,也將繼續優化詞典類型Profile(這需要多種不同詞典的圖片+pdic數據進行profile改造,現在軟件裏面提供的還是比較粗的)
已按你上传的 v2.13.0 重新评估,并以它为基线升级为 v2.13.1。这次不是拿 v2.12.12 整包覆盖,而是保留 v2.13.0 已经整理好的 uv / Python 3.13 / .venv / uv.lock / docs 结构,再把 v2.12.9→v2.12.12 被跳过的功能逐项补回。
对 v2.13.0 的评估结果是:你列出的三个旧安装隐患,新的 uv 架构基本都已经从结构上解决了。现在依赖不会再装进系统 Python;主程序和可选组件统一走项目 .venv;.python-version=3.13 加 requires-python >=3.10,<3.14 也避免了 py -3 误选 Python 3.14。
同时我发现并修了三个新架构下的遗留点:第一,【OCR / 简化环境状态】里还残留着旧版“重新运行 bat 自动修复 OpenCC / pip 安装”的提示,现在全部改成 uv 语义;第二,run_windows.bat 改为:
uv run --locked python run.py
确保直接按已提交的 uv.lock 启动;第三,README 原先对 GPU Paddle 的说明有风险,因为 --extra paddleocr 当前实际上是 CPU 预设,会安装 paddlepaddle==3.3.0,现在已经明确注明 GPU 用户不要再叠加这个 CPU extra。
另外,上传的 v2.13.0 虽然 README 写了 uv run pytest,但源码压缩包里没有 tests/,这次也把回归测试重新放回源码树了。
补回的 v2.12.10→v2.12.12 功能包括:
- CC-CEDICT 繁体→简体映射比较重新加入。
CC-CEDICT(√/×)继续表示词条是否收录。- 新增
CC简(√ / 候选 / ×)。 - OpenCC 与 CC-CEDICT Simplified 字段一致时显示
CC简(√)。 - 不一致时直接显示候选或候选数量。
- 点击
CC简可查看:
*
原词条
*
OpenCC 结果
*
当前保存的简体
*
CC-CEDICT 简体候选
- 已保存简体绝不重新覆盖。
*
只要_PictureCapture/data/Simplified/<页码>.json里已经有该行,无论manual=true还是manual=false,重新打开页面都直接使用保存值。
*
OpenCC 只负责“从未保存过”的新行首次生成。 - 校对窗口默认 70% × 70% 屏幕尺寸,居中打开。
- 主界面联动高亮改为真正的 RGBA 半透明淡黄色,不再使用
gray50点阵磨砂效果。 - 版面行为默认关闭
☐ 手动分栏☐ 跟随词头列倾斜和局部变形- 老项目做一次性迁移,之后用户自己重新勾选的状态会正常保存。
文档也同步修正了两个原先与代码不一致的地方:docs/usage.md 不再写“倾斜/变形默认开启”,也不再写“校对窗口半屏宽、全屏高”;docs/architecture.md 也明确改成“OpenCC 只初始化缺失简体,不覆盖已保存 sidecar”。
验证结果:
- pytest:284 passed
- 传统 run_tests.py:70 passed
compileall:通过- Wheel 构建:通过
- Wheel 版本:
2.13.1 uv.lock与当前pyproject.toml结构校验通过
下载
下载 Picture Capture v2.13.1 Release
下载 v2.13.1 完整源码
下载 v2.13.1 Wheel
下载 v2.13.0 评估与 v2.13.1 合并说明
下载 SHA-256 校验值
这次我建议以后就把 v2.13.x 作为新的主线:继续保持 uv 单一环境管理,不再回到 v2.12.x 那套 requirements + 多 bat + 多解释器的安装方式。

已经更新上传,现在版本 v2.13.1
Picture_Capture_v2.13.1_Release.zip (1.4 MB)
环境要求
- uv >= 0.11(依赖与 Python 环境管理):https://docs.astral.sh/uv/getting-started/installation/
- Python 版本由
.python-version锁定(当前 3.13);uv 会自动准备,无需手动安装。 - 可选:Tesseract 5(系统级 OCR)、PaddleOCR、Google Lens、CC-CEDICT。
PaddleOCR 目前支持 Python 3.10–3.13,因此
requires-python设为>=3.10,<3.14。
安装与运行
核心依赖只有 Pillow、NumPy、pypinyin、OpenCC,无需 OCR 也可启动。
Windows
run_windows.bat
该脚本使用已提交的 uv.lock 启动,等价于:
uv run --locked python run.py
macOS / Linux
uv run --locked python run.py
首次运行会自动创建项目专属 .venv 并按 uv.lock 安装依赖;不会把依赖装进系统 Python。日常启动请使用 run_windows.bat 或 uv run --locked python run.py。
已经更新,版本 v2.13.2
Picture_Capture_v2.13.2_Release.zip (1.4 MB)
这次主要把安装说明重新整理得更适合普通用户,尤其强化了 Windows / GPU 用户的一键安装流程。
感谢分享,我早问孤影开源或帮他制作macOS,他不愿意!
我当年的软件太粗糙,不值得公开分享;)
现在有AI帮忙,把想法落实就行,代码大家就都运行地起来。
期待你Update使用过程的遇到的问题哈
DicSlicer 对 Picture Capture 的可借鉴点
DicSlicer 是我当初制作 “汉字源流大字典 - 谷衍奎” 切图词典时自研的一个软件:HeaderSlicer 切分页眉/正文、ColumnSlicer 分栏、WordSlicer 按行投影切出词条、MergeContinue 拼接续行,最后归集、重命名并生成 mdx/mdd。每一环基于图像几何与墨迹统计,可批量处理整本书。
其中对 Picture Capture 最有借鉴价值的,是它在质检/审计与预处理清理上的做法。以下逐条列出。
1. 缩略图总览(contact sheet)
- 出处:
MergeHeader.py把大量页眉小图按奇偶页分组、缩小后堆叠到接近 A4 比例的版面输出(奇数页靠右、偶数页靠左,贴合书口),一张图即可看几十页。 - 现状:Picture Capture 只有逐页校对窗口和 OCR 一致性的
_quality_summary.tsv,缺少这种"跨页缩略总览"。 - 价值:切图或 OCR 出现系统性错误(如某批页整体错位)时,逐页翻查很慢;缩略图总览能一眼扫过整本书,瞬间暴露问题。
- 落地建议:可复用
QT/PSW(单行图)或QT/PWW(词条图)的小图,按页/奇偶分组拼成总览图。
2. 逐页词条数统计 + 异常页标记
- 出处:
VocabStatistics.py按页统计词条数并分奇偶输出。 - 现状:Picture Capture 有
_quality_summary.tsv(OCR 一致性),但没有"每页词条数"的直白报表。 - 价值:这是低成本异常探测器——某页词条数为 0 或异常偏高,几乎必然是检测/切图失败。
- 落地建议:可直接复用
.PWWords/ CropPlan 清单,输出"页名 / 词条数 / 是否偏离邻页均值",快速定位需人工复核的页。
3. 装饰边框/大轮廓自动清除
- 出处:
HeaderSlicer.remove_decoration():深色墨迹阈值反相 → 闭运算把邻近笔画粘成连通块 → 取面积最大的轮廓 → 填充掩膜 → 抹白并置透明。 - 现状:Picture Capture 的
usage.md承认"自动路径明显受到装饰线影响"时只能手动关闭列跟踪;_whitefill_polygons只处理用户手画的 PPP,没有自动清理装饰的环节。 - 价值:在左缘分析/行投影之前先掩掉大块装饰结构,可减少手工干预。
- 注意:原实现假设"最大连通深色块 = 装饰",可能误删大号标题字,或把空心框内的文字一并抹掉;借鉴其"分析前自动掩掉大块装饰结构"的思路即可。
4. 显式的续行标记
- 出处:DicSlicer 用
_continue后缀把"这是上一词条的续行"做成可检查的产物,MergeContinue/CentralizeImg都依赖它。 - 现状:Picture Capture 的 CropPlan 有
suffix=(1)(2)与source_mode,也有_上页末词条_,但"这片是某词条的续段"这一语义不如_continue直白。 - 价值:提升审计可读性,便于人工核对跨栏/跨页拼接是否正确。
5. 导入文本的编码探测
- 出处:
GenMdict.convert_file_to_utf8_unix_format()用 chardet 探测编码、去 BOM、CRLF→LF。 - 现状:Picture Capture 读用户文本统一用
utf-8-sig,遇到非 UTF-8 的wordslist.txt/_Replace.txt会失败。 - 价值:健壮性补丁,让用户提供的任意编码文本都能被读入。
- 优先级:低。
优先级小结
| 建议 | 价值 | 优先级 |
|---|---|---|
| 缩略图总览(contact sheet) | 批量目视审计,暴露系统性错误 | 高 |
| 逐页词条数统计 + 异常页标记 | 低成本失败探测 | 高 |
| 装饰边框/大轮廓自动清除 | 减少手工干预,改善左缘分析 | 中 |
| 显式续行标记 | 审计可读性 | 中 |
| 导入文本编码探测 | 健壮性 | 低 |
这些建议都是增量、正交的通用能力,不依赖某本书的定制。
建议:
-
借助 AI 使用 GitHub - mattpocock/skills: Skills for Real Engineers. Straight from my .agents directory. · GitHub 中的 improve-codebase-architecture,对整个项目进行一次完整分析诊断,优化架构设计。
-
把 CLI 做成 headless 核心的薄适配器(①),再用 AGENTS.md + skills + 文档把这套接口讲清楚(②),并补上测试与 --dry-run/JSON 护栏(③)——从而加入 AI 协作能力,很多繁重的任务都可以直接交给 AI。
我开发了一个整页版图片词典的制作软件,都是使用 AI 来制作,方便的很,已经回不去手工时代了。
我已经通过 AI 完成过往几十个采用 mdxsourcebuilder 甚至完全手工制作的图片词典的升级,这在过往是完全不可现象的。
无论是软件本身的升级、维护,还是词典项目的创建、词条的修订、版本升级维护等,大部分都可以通过 AI 来完成。
用多了之后,感觉软件本身更多是定义规范、提供基础工具等,有点类似于是针对特定领域的 Agents 的概念了。这也反过来逼迫我们将软件架构想清楚、将文档理顺,软件整体的质量也就上来了。
我仔细看了你的内容,相应地写一下我的想法:
背景:在使用 Picture Capture 前,扫描版的图片是已经经过 批量处理(如ComicEnhancer Pro)且核对并排除了版面问题了的(图片浏览软件,直接键盘翻页检查)。
-
缩略图总览(contact sheet)
OK. 可以更方便地发现批量处理过后的异常图片和定位画线问题;
1.1 针对整体版面:不生成缩略图,直接检测固定的页眉位置横条+第1栏左侧纵条,以确认图片版面位置是固定的;
1.2 针对画线:
(1)从OCR的文字出发:合并所有行的OCR结果,正则处理判断,这个应该比较OK;
(2)从图像上额外处理:
①是否多画了:A. 通用方案:根据已有画线,提取单行(PSW,限制宽度w如50%栏宽)合成以页Page为区块的集合,再以数量XX页为一个整体放到一起为一个屏幕大小;B. 根据词典排版的特别方案:如三民大辞典词头单独一行(长词条连同注音2行也是有很多的),可以提取已有画线位置右侧宽度w如2个字符宽度*单行的矩形区域,检测空白程度,有问题的继续检测下一行同样宽度矩形的空白程度;
②是否少画了:将已画线处填白单行,取每栏左侧XX宽度合并,N页合并为一个屏幕宽度。 -
逐页词条数统计 + 异常页标记
直接在页面列表里添加一列统计词条数(页面列表栏头是可以点击排序的) -
装饰边框/大轮廓自动清除
这点的必要性是什么吖?(现在软件里根据指定的版面参数去画线的老方法只是保留,还未优化;根据OCR结果+词头规则去判定画线的方法可能可以限定在一个大的区域里?) -
显式的续行标记
切图的功能我保留着,但我个人之后是不会再去切图了,因为我个人现在都使用PicDic插件一站式管理/浏览图片版词典;只需要对原始的索引文件维护;
即便是需要切图,现在的切图逻辑里,不会产生错误的切图吖 -
导入文本的编码探测
这个读取文本的编码问题我倒是忘记了,因为个人习惯,文本都是utf-8的;)
这个使用AI的工作流程倒是很不错;)
我开发了一个PicDic扫描版词典的浏览/管理等的JS套件,用起来很惬意。从索引到词典包也是python一次运行,后期也仅需要维护索引。支持仅有页末索引,也支持全索引。
逐条回应一下:
- 缩略图 contact sheet:我只是用于页眉处的截图,这样可以将整本书的页眉放到几页中,方便快速浏览和批量OCR及校对。不过我看你扩展了这个概念,按需取用吧。
- 无
- 装饰边框/大轮廓自动清除:主要目的是去除画线时的干扰,前文描述更多是针对当前文档中的旧版方法。
- 简单示例(# 为深色墨迹):
.....###############.....      ← 装饰性横线
.....###############.....
...........###...........      ← 花饰
..汉..........#...........      ← 真正的文字
闭运算把横线与花饰粘成一块,面积远大于"汉"字,于是被选中并抹白,只剩文字:
.........................
.........................
.........................
..汉.....................
- 现状:Picture Capture 的 usage.md 承认"自动路径明显受到装饰线影响"时只能手动关闭列跟踪;_whitefill_polygons 只处理用户手画的 PPP,没有自动清理装饰的环节。
- 价值:在左缘分析/行投影之前先掩掉大块装饰结构,可减少手工干预。
- 可忽略
- 无
看来又发现了一个宝藏:
你可以先去百度链接下载试用一下
PicDic下面的几个词典 可以选择性地下载
通过网盘分享的文件:GoldenDict
链接: 百度网盘 请输入提取码 提取码: gr73
第三点我大概理解了,以后改保留的旧方法的时候再考虑哈。