这个词典还挺有意思的,有好多小说作为例句,还加了各种方言标记,还挺值得制作的。
已知问题,仍然缺2000个左右词头,生僻字存在很多识别问题,圆圈和方框内的文字存在大量识别问题,ruby存在大量识别问题。我还在尝试改进算法,这是当前版本,会持续更新。


下载:
通过网盘分享的文件:现代汉日辞海
链接: 百度网盘 请输入提取码 提取码: 1234
这个词典还挺有意思的,有好多小说作为例句,还加了各种方言标记,还挺值得制作的。
已知问题,仍然缺2000个左右词头,生僻字存在很多识别问题,圆圈和方框内的文字存在大量识别问题,ruby存在大量识别问题。我还在尝试改进算法,这是当前版本,会持续更新。
下载:
通过网盘分享的文件:现代汉日辞海
链接: 百度网盘 请输入提取码 提取码: 1234
诚挚感谢 wynick27的辛苦付出和无私分享。无法想象此次如何在这么短时间内能够将上下两册的汉日辞海扫描并制作成MDX,并且还是词条和原书对照的。这里有个小小的请求,是否可以将 paddleoc扫描的txt发送一份呢 [[email protected]],非常感谢!我手上有国内和日本发行的原书各一套,也就是收藏用,很少当做工具书来查,若是有需要的话日版的可以提供出来扫描。国内版的不少页做了标注,翻得有些旧了。
又一部仏和大辞典/独和大辞典/西和大辞典级的重磅巨著,中日辞典的最高峰
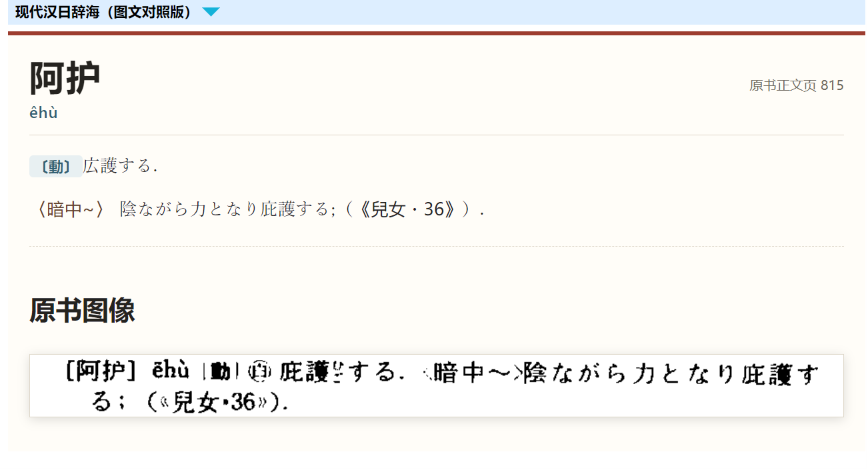
说起来这最后一张图里庇护给扫成广护了,看来短期的确得图片对照
是的,现在词头都没核对完,核对完以后可以筛查一些错字了。我还标注了10页数据,让ai根据这个数据写定向检测带圆圈的符号和furigana的方法。然后我还准备对于生僻字,渲染unicode标准字形,然后用传统cv方法匹配生僻字。其他的可以通过拼音输入法词库之类的核对拼音和字是否对应。做完这一套还有问题的再人工核查,不过全文校对我就不打算做了。
这么多字确实没啥必要搞全文的了,其实有个图片版的也很好了
我是用夸克做主版本的,因为生僻字效果更好,但夸克的问题是遇到字占两行就经常把第一行丢了,非常麻烦,目前有大量缺行,只用其他版本补了一部分,现在有1/4的页面都不能保证内容对齐,圆圈内符号基本全错,还不适合阅读,等问题修的差不多了我再发文本吧
普通版mdx有两个,大小不一样,下哪个?标(1)的那个么?
是的,是之前没覆盖变成了两个文件,现在文件名正确了
赞,能不能生成个四周没有空的版本,好用来根据比例裁剪
括号这个已经改了一轮了,应该是没改全。现在这个pdf清晰度不行,识别错误有点多,还有各种漏行问题比较复杂,有600个词没匹配到图片。我写了个生僻字识别,但正确的字很很多没排第一位,感觉做到基本完善也要很久
扫描清晰度比较低,带框的文本识别率很差,这个4000页手动修复至少100小时,我试了单独算法标方块和圆圈效果仍然一般,可能要准备个标注集单独处理这部分才行。
这个经典大部头不急,从0到1的变化才是最重要的,能有mdx就很厉害了 


