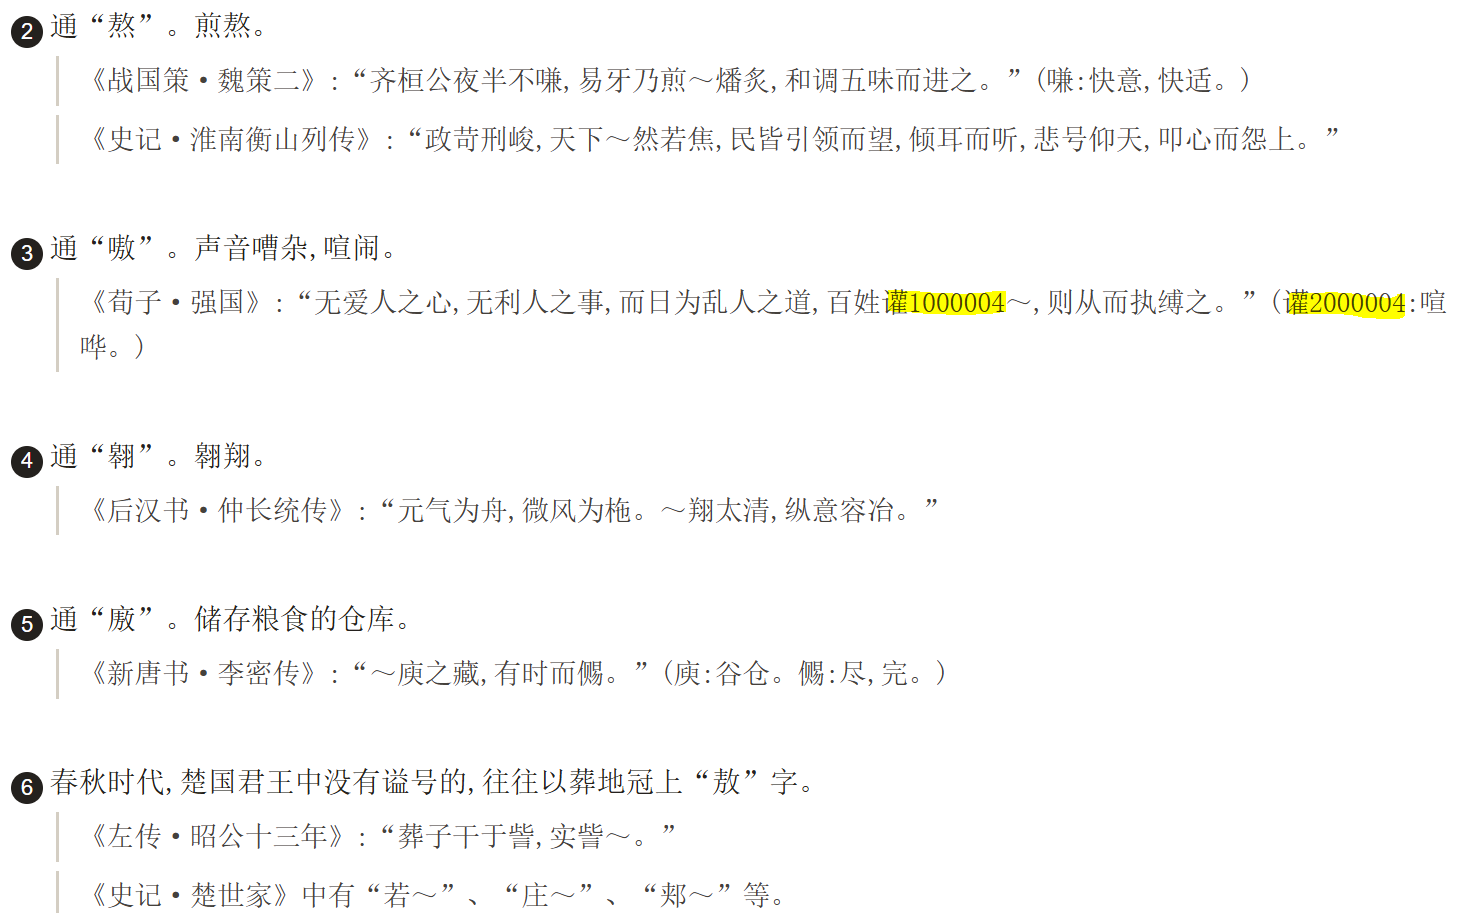
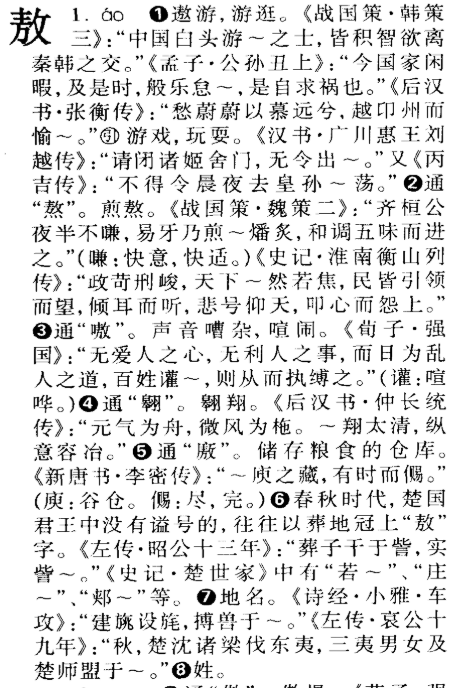
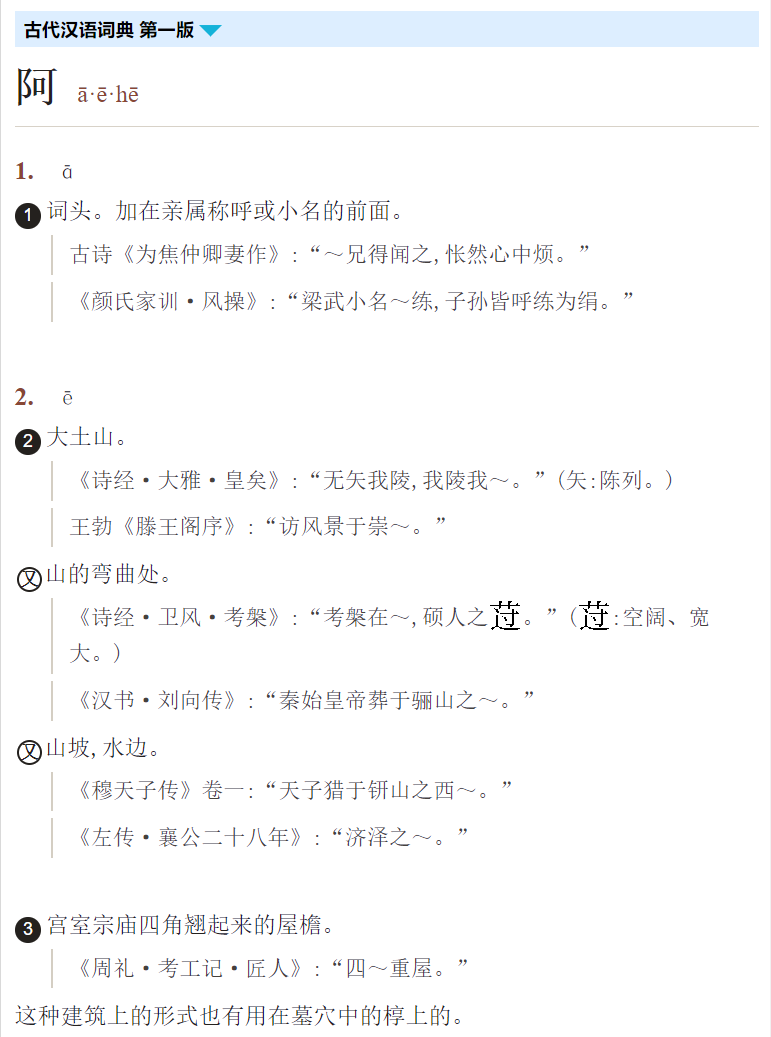
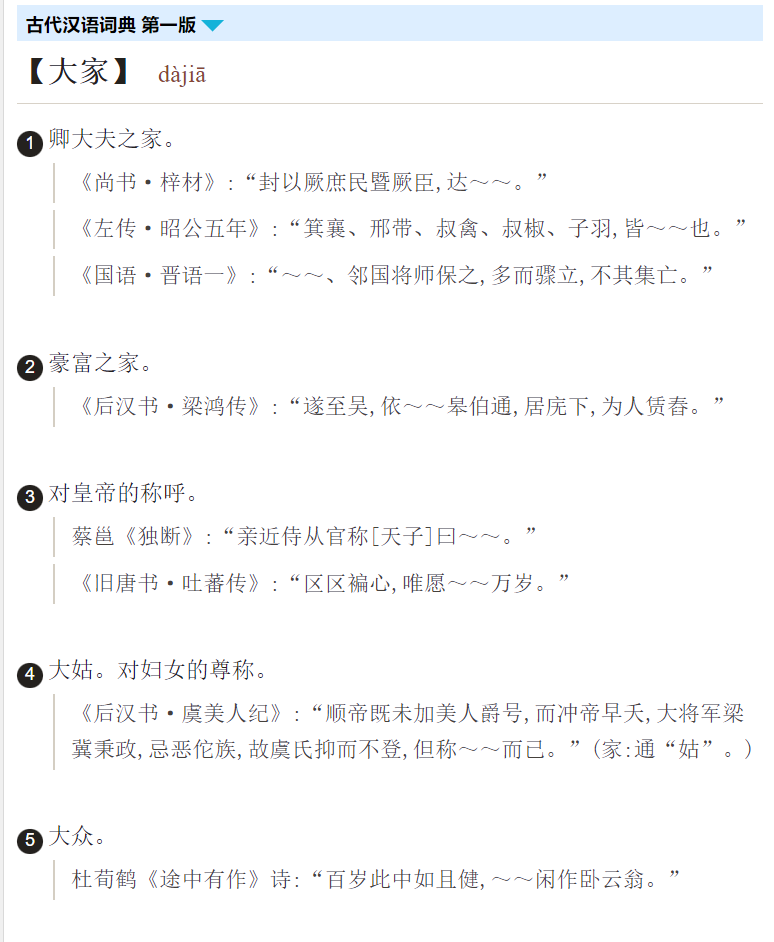
发现之前第一版没有文字版的,现在有casio数据可以提取文字版了,不过这个外字数量极大,有2700个生僻字,目前采用图片版字头覆盖,以及用字形匹配方法匹配了一大部分,但外字还有2/3没校对。现在词头有外字的只能通过读音或者部首检字才能查到。
下载:
通过网盘分享的文件:古代汉语词典 第一版
链接: 百度网盘 请输入提取码 提取码: 1234
提供了原始数据包,希望坛友帮忙校对,下载GDHYCD_extracted_data.zip
校对工具是gaiji_proofread_gui.py:
发现之前第一版没有文字版的,现在有casio数据可以提取文字版了,不过这个外字数量极大,有2700个生僻字,目前采用图片版字头覆盖,以及用字形匹配方法匹配了一大部分,但外字还有2/3没校对。现在词头有外字的只能通过读音或者部首检字才能查到。
下载:
通过网盘分享的文件:古代汉语词典 第一版
链接: 百度网盘 请输入提取码 提取码: 1234
提供了原始数据包,希望坛友帮忙校对,下载GDHYCD_extracted_data.zip
校对工具是gaiji_proofread_gui.py:
感谢分享。终于开始做汉语词典了。
阿弥陀佛做过第一版的图片词典,不知道那本词典的词头对这本文字版是不是有帮助。Index of /uploads/【阿彌陀佛】/【阿彌陀佛】漢語辭典合集/《古代汉语词典》商务(第一版)/
你说呢,果然内容太长一般不会去看。
是用了这个版本词头的,现在规则是外字不是已校对状态而且在词头时会使用图片版的词头替换,其他时候都显示图片,这个图片版词头很多地方只有繁体,没有对应的简体,因为外字没校对完,所以现在的版本会有简体查不到的情况,此外发现有些简体版本是没有unicode编码的,还有J区的字是编码后也无法显示的都暂时保留了图片。
这个校对有些麻烦啊
没校对的图片字直接打包发出来?
哪个编号对应哪个字,这样比较快吧,而且大家都能做
给出图片所在的词条,
然后查询已经文本化的新版本中的该词条,把生僻字复制出来,这样确实要快些
已经打包发了啊,校对工具和生成脚本都在GDHYCD_extracted_data.zip,运行python gaiji_proofread_gui.py就可以开始校对(需要安装pyqt依赖,校对后运行build_cz102-mdx.py就能重新生成mdx,我校对了一半多
这就是门槛啊
比如手机怎么运行呢
不懂python呢
之前没考虑过手机校对,只能电脑运行