在论坛里,大家讨论得比较多的,是怎样整理资料、制作和完善电子词典文件,让文本更便于检索、跳转和动态呈现。而我的兴趣点更集中在另一端的问题——怎样把流动的数据放进特定的开本、字格和阅读语境中,使它成为一种确定的组织形式。
十多年前,在中国大陆的公开出版物中,一些栏目、标题或特殊版面中还偶尔可以看到竖排文字,现在却很少见到了。台湾地区保留的竖排出版物相对多一些;日本的文学、历史和辞书出版中,竖排至今仍是一种常见而成熟的选择。相形之下,当前大陆能够接触和积累的现代中文竖排实践确实不算丰富。
前段时间看了一些日文词典,对它们的竖排版式印象很深。传统日文词典通常采用竖排,正文、栏线、字头、读音、释义和页边索引之间的关系处理得十分精细。我一直想认真做一次竖排实验,而辞书恰好是很合适的载体:它结构复杂、信息层级丰富,对字体、网格、分栏和分页都有较高要求,能够把许多排版问题集中暴露出来。
排版本身是一件极其精细的工作。对于东亚方块字而言,它不仅是选择字体、设定字号和把文字排进页面,还涉及字形搭配、标点挤压、行首行尾禁则、注音定位、纵中横排、专名号与书名号,以及不同信息层级之间的空间关系。日本在这些方面积累了相当成熟的规范和工具:字体技术中有 Adobe-Japan1 这样的字形集合以及一系列 OpenType 竖排特性;InDesign 等专业出版软件也提供了面向日文的排版引擎、禁则和行组版设置。这些经验不能原样等同于中文规范,但仍然提供了很有价值的技术参照。
与日文相比,现代中文排版,尤其是竖排和复杂版面的公开讨论及可复用方案相对少得多。比较有代表性的工作包括 The Type 发起的 孔雀计划,以及 W3C 的《中文排版需求》(Requirements for Chinese Text Layout,CLReq)。前者从字体排印和中文字体设计的角度展开研究,后者主要面向数字环境梳理中文横排、竖排、标点与行列组织的基本要求。这个项目也参考了这些讨论,但具体到辞书,仍然有大量问题只能在实际排版中逐项处理。
这次分享的项目,是尝试把《辭源》第三版的电子词典数据重新整理成适合纸面阅读的竖排版本。目标是尽量恢复竖排纸书应有的组织关系:按照十二集、部首、部外笔画、单字及其所带复词重建条目次序,再以传统的四栏竖排、右装订和从右向左的双页方式呈现。
选择《辭源》,一方面因为它是中国大陆最知名的文史类大型辞书之一,内容和结构都具有代表性;另一方面也因为《辭源》初版于民国时期,早期版本原本就是竖排。今天重新把它处理成竖排,既是一项技术实验,也多少带有一点复古意味。
从大框架看,整个流程分为三层。第一层把 MDict 电子词典数据转换成尽可能保留原始内容、分隔符和顺序信息的结构化数据(电子词典数据来自于 【阿彌陀佛】辞源-第三版4个版本2021.6.12更新,谨表感谢!);第二层依据原书索引重建纸书次序,并把人工校订保存在独立的补丁层中,而不是直接修改生成结果;第三层由 LuaTeX-ja 和 jlreq 完成竖排、分栏、分页、字体选择和 PDF 输出。这样做虽然比直接拼接文本复杂,但数据整理、人工校订与版式实现彼此分离,后续调整页面时不必反复改动正文。
实际处理时,困难主要集中在几个方面。电子词典的检索顺序并不等于纸书的阅读顺序,需要重新核对单字、复词、部首和笔画之间的关系;语料中又有大量生僻字、异体字、注音符号和专用序号,单一字体无法完整覆盖,因此必须按照字符和文本角色建立字体后备关系。此外,读音、义项序号、书证、交叉引用、专名号和书名号,在竖排中都有各自的组织规则。插图也不能一概当作普通字符塞进正文,而要根据尺寸和条目位置选择行内、绕排或独占栏宽等不同方式,同时避免破坏正文的连续性。
项目目前仍是一项个人研究和排版实验,距离真正可供通读、校勘乃至印制的完整版本还有很长的路。《辭源》的内容规模很大,电子词典数据也不能自动等同于可靠的纸书底本。
页图选摘:
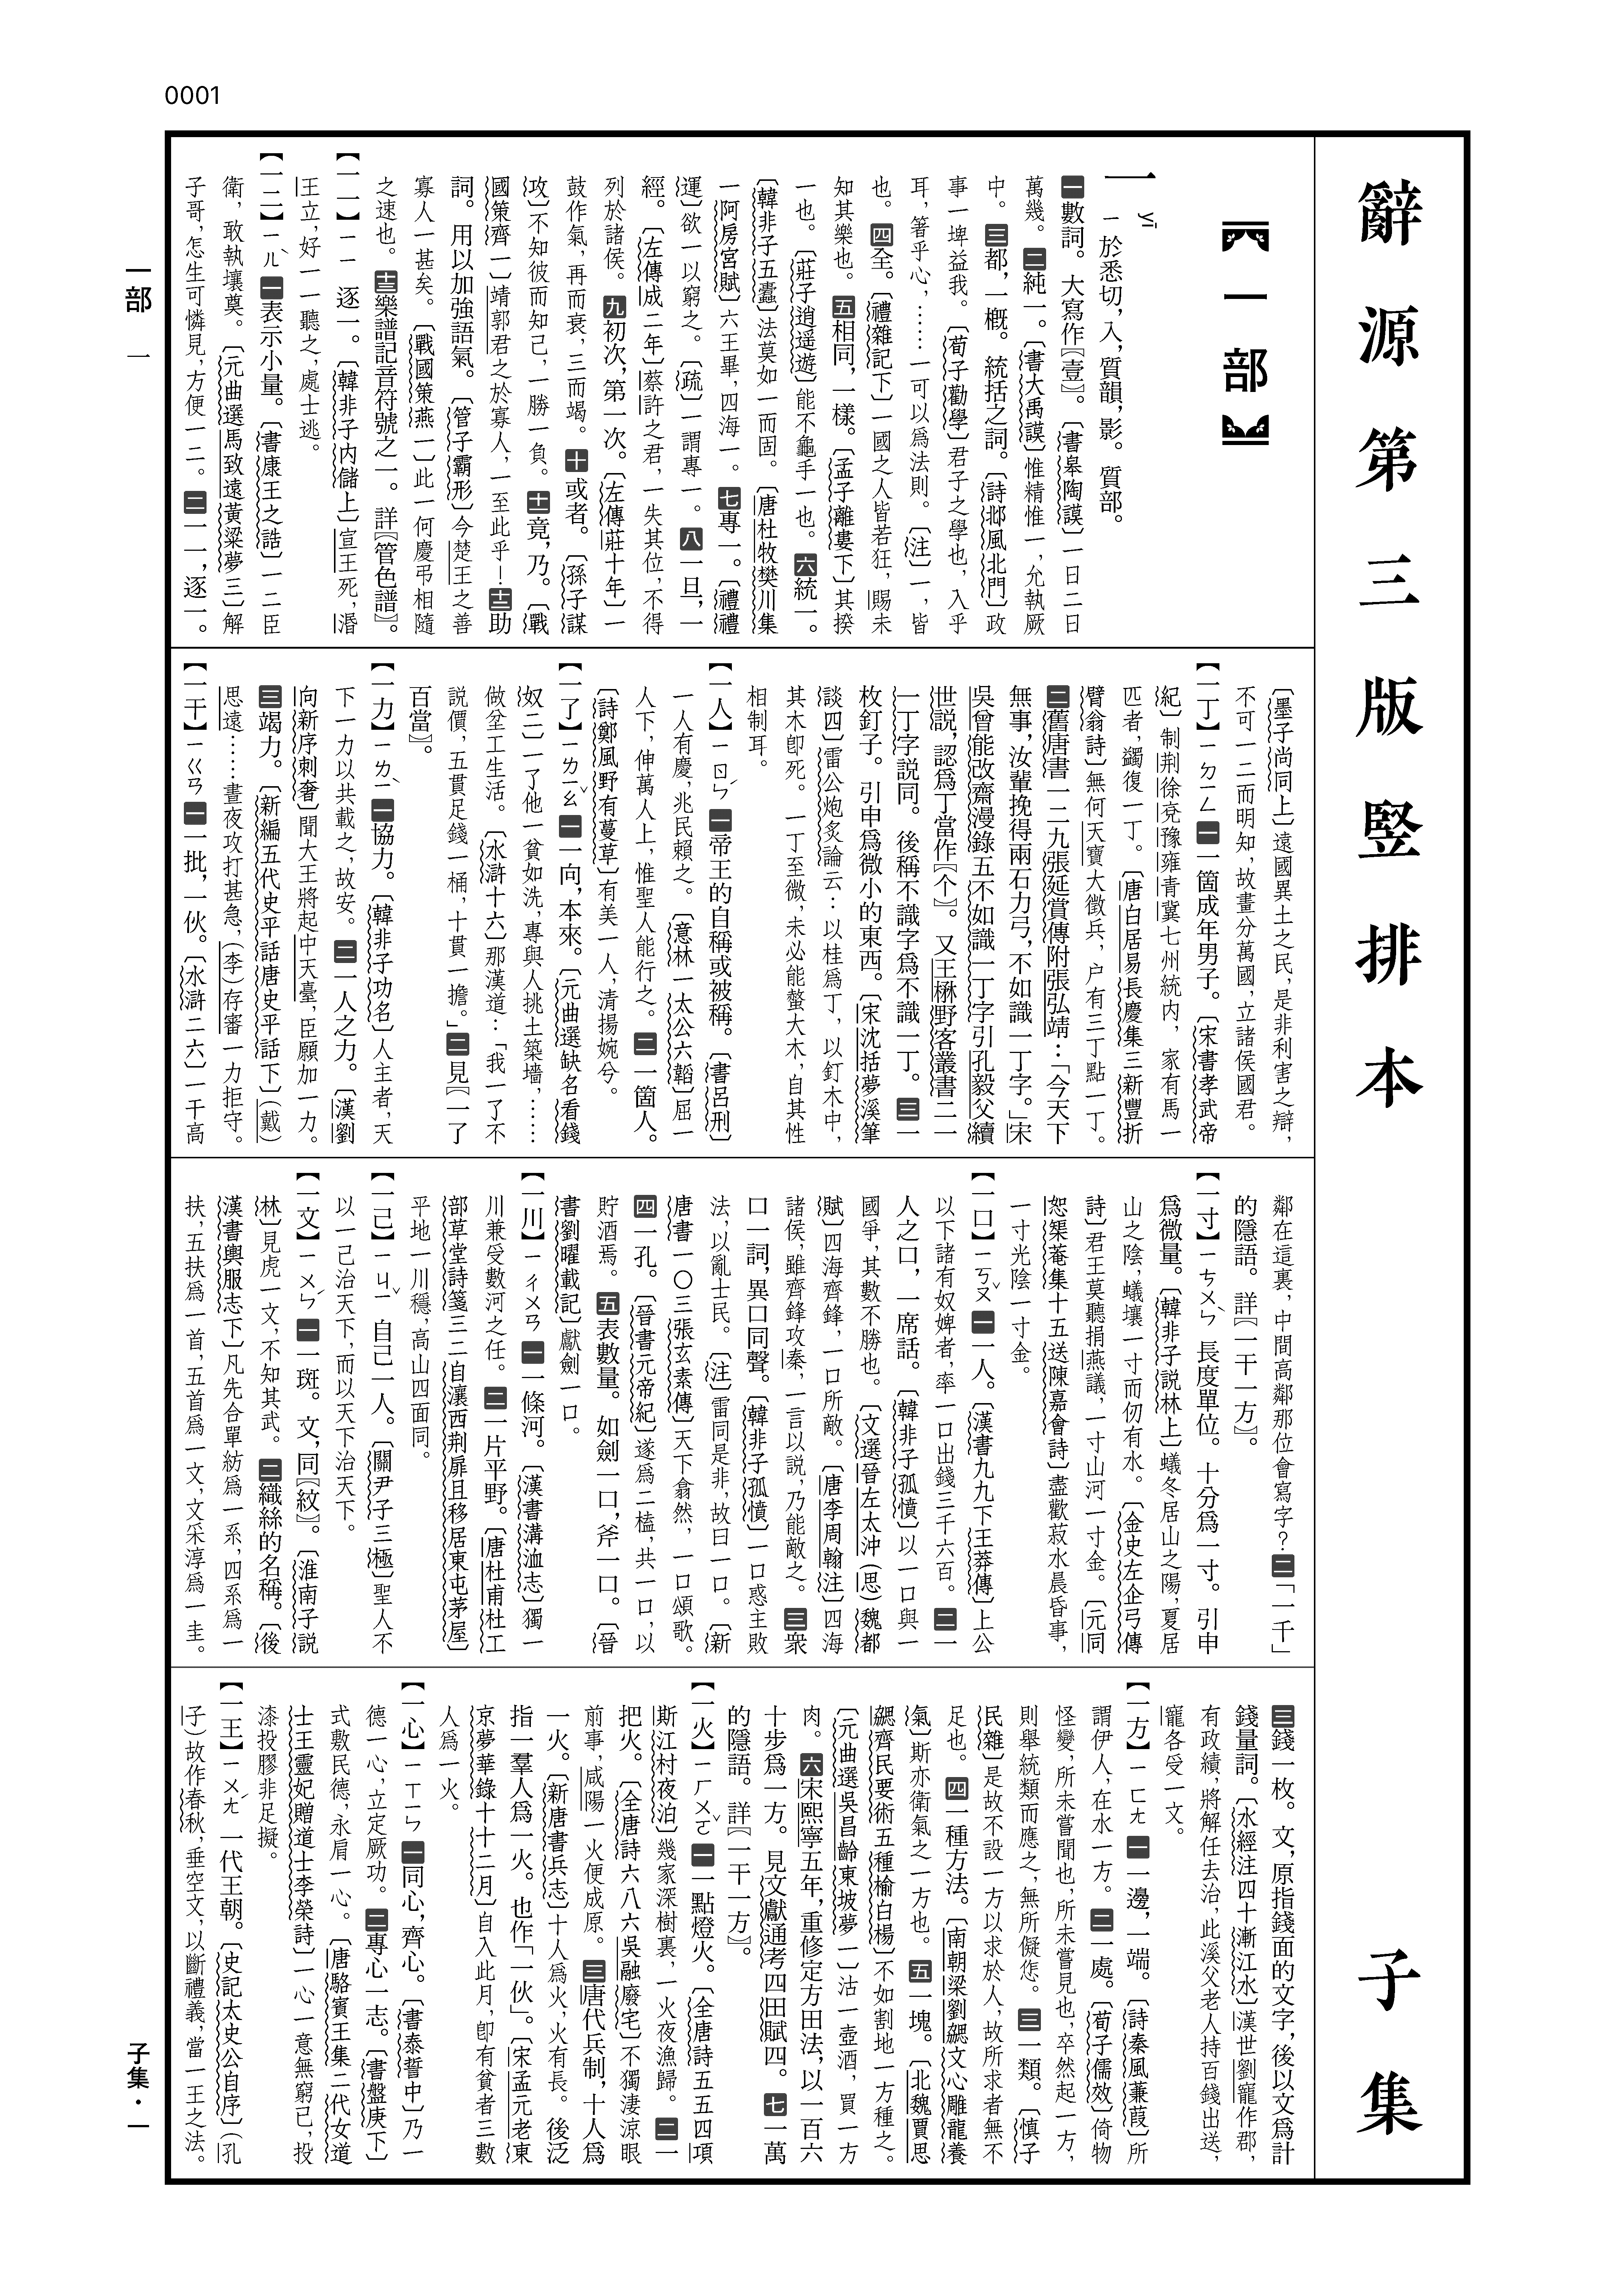
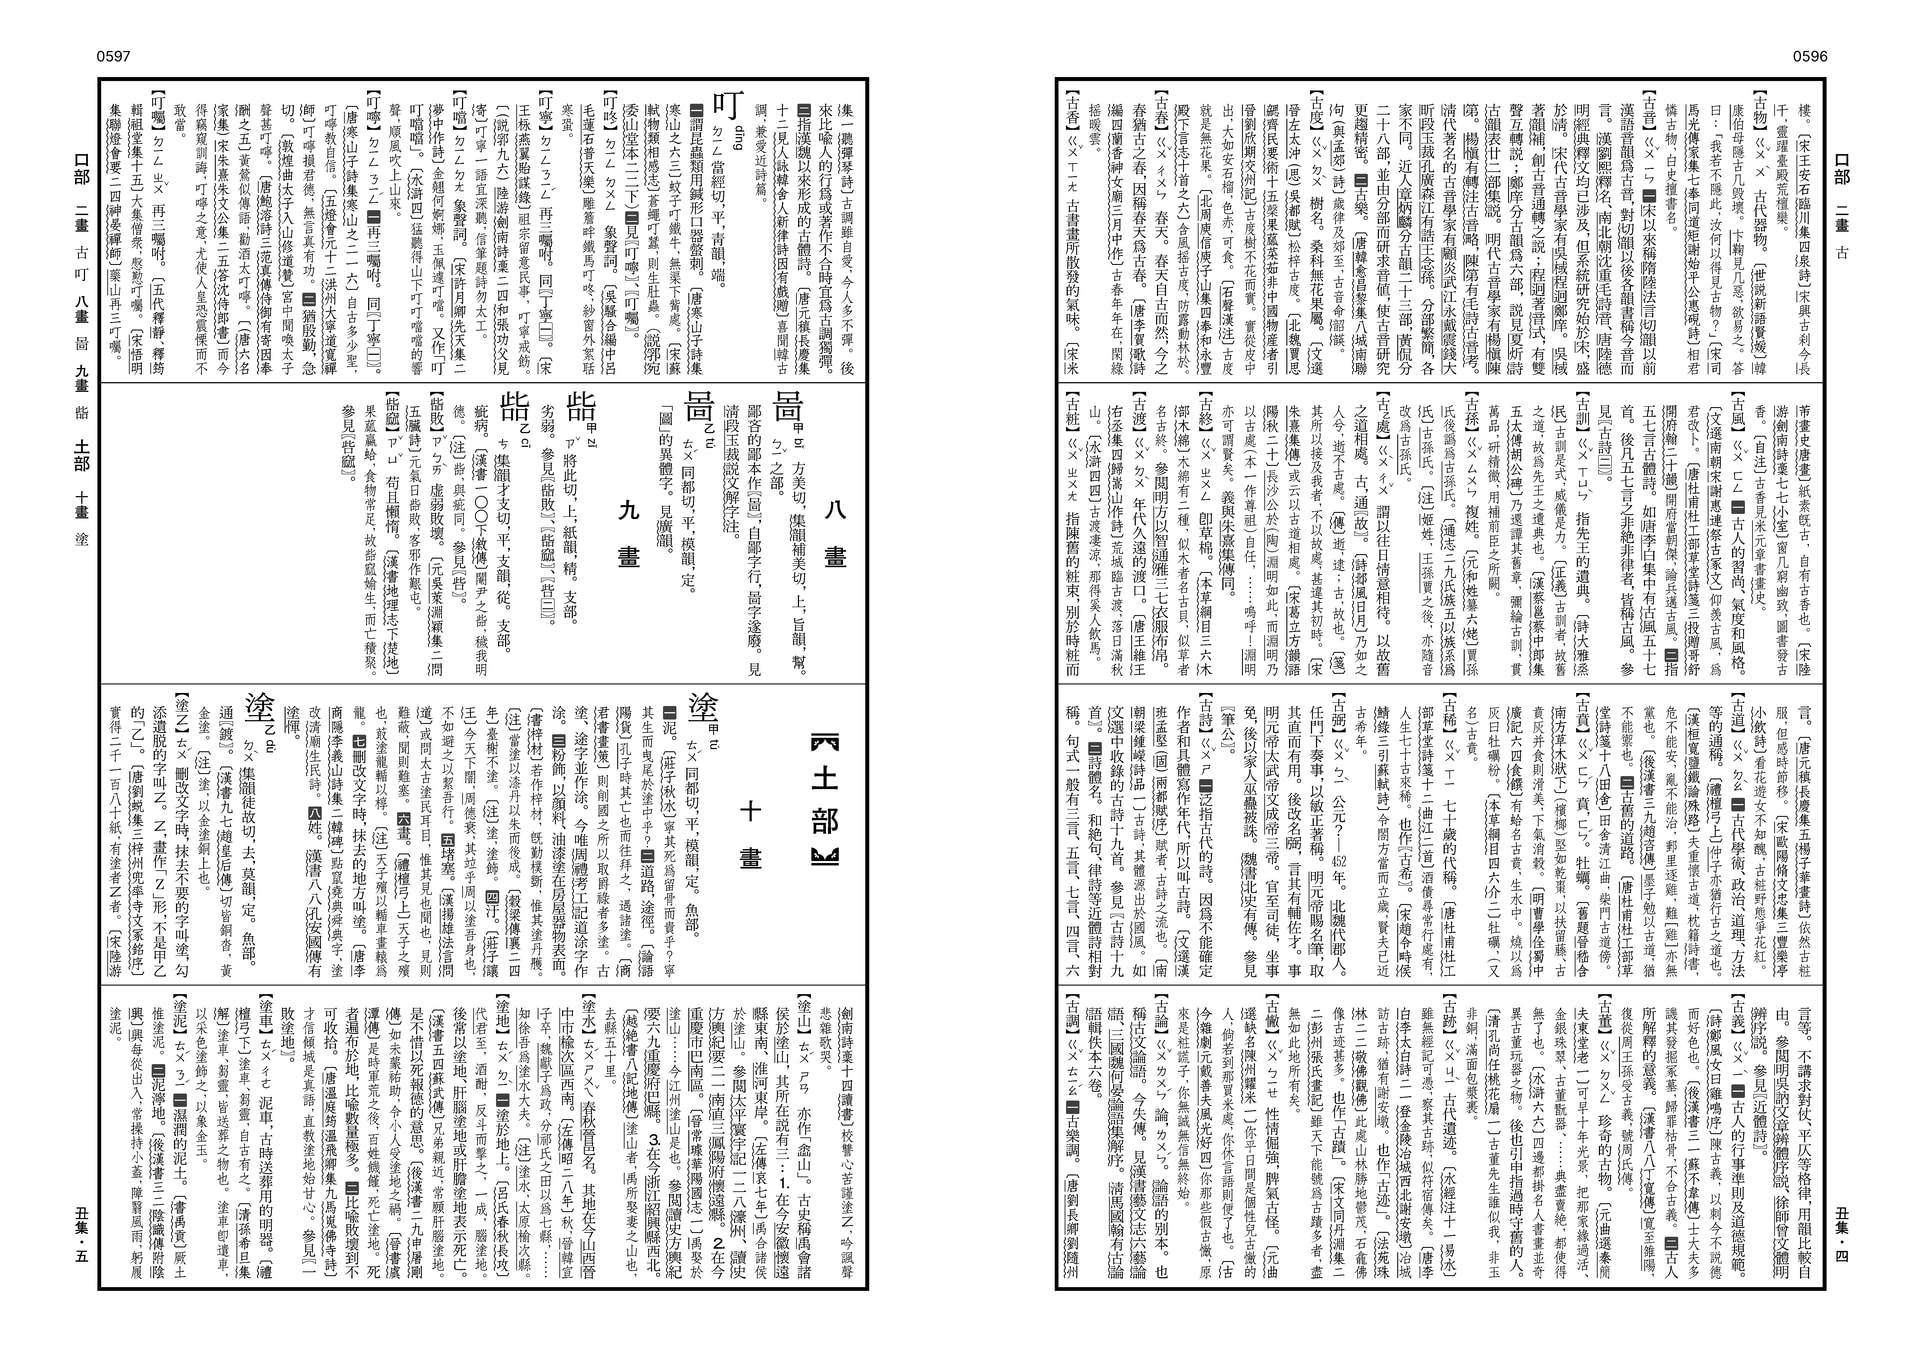
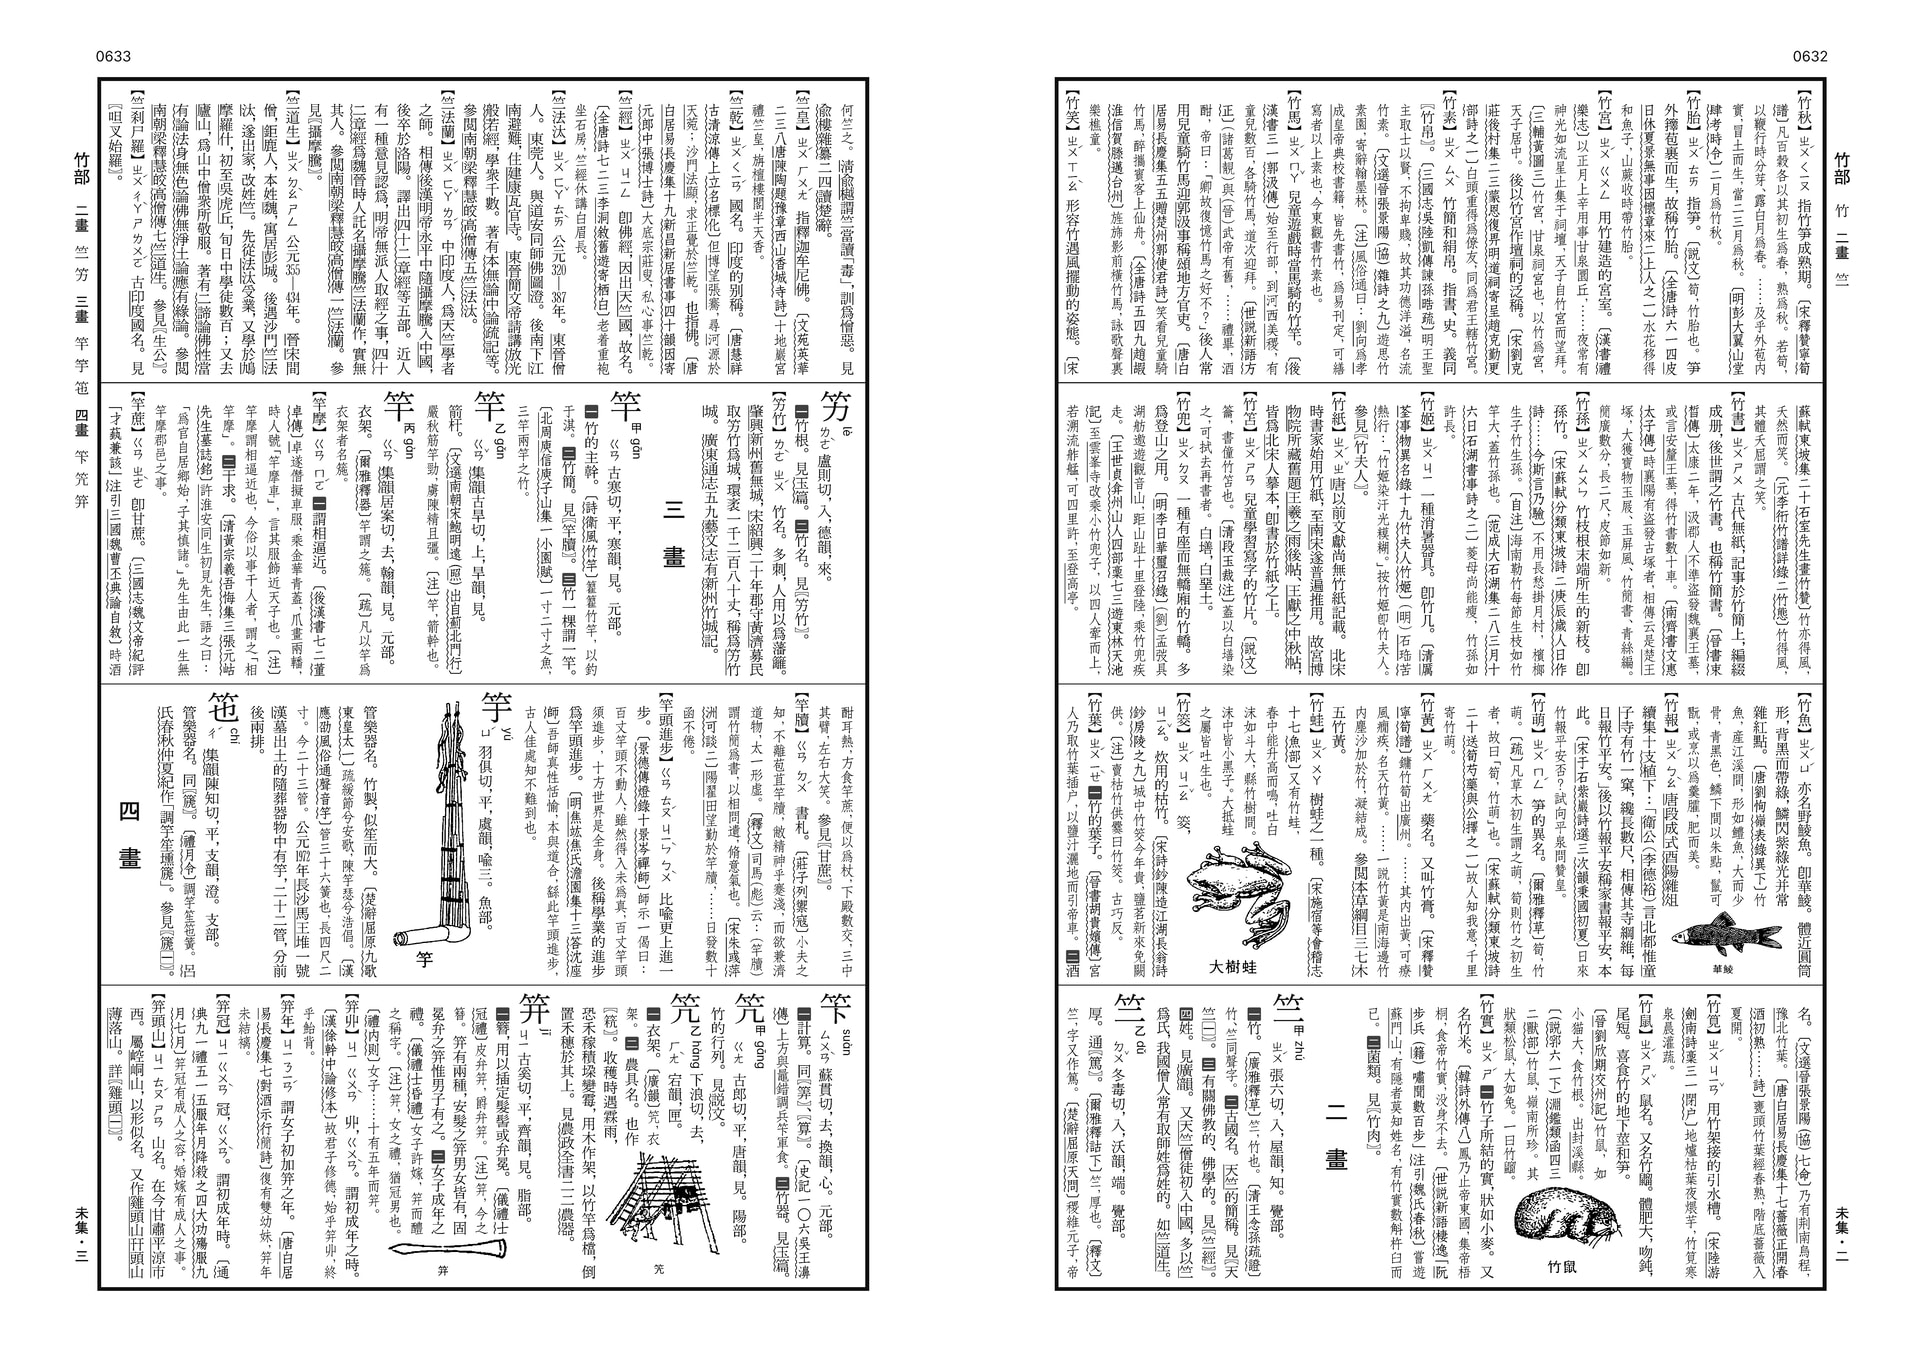
样张可在此下载:
《辞源》竖排样张1.pdf (9.5 MB)
本样张仅用于辞书排版研究和技术交流,不作商业用途,也不包含或分发排版时使用的字体文件。