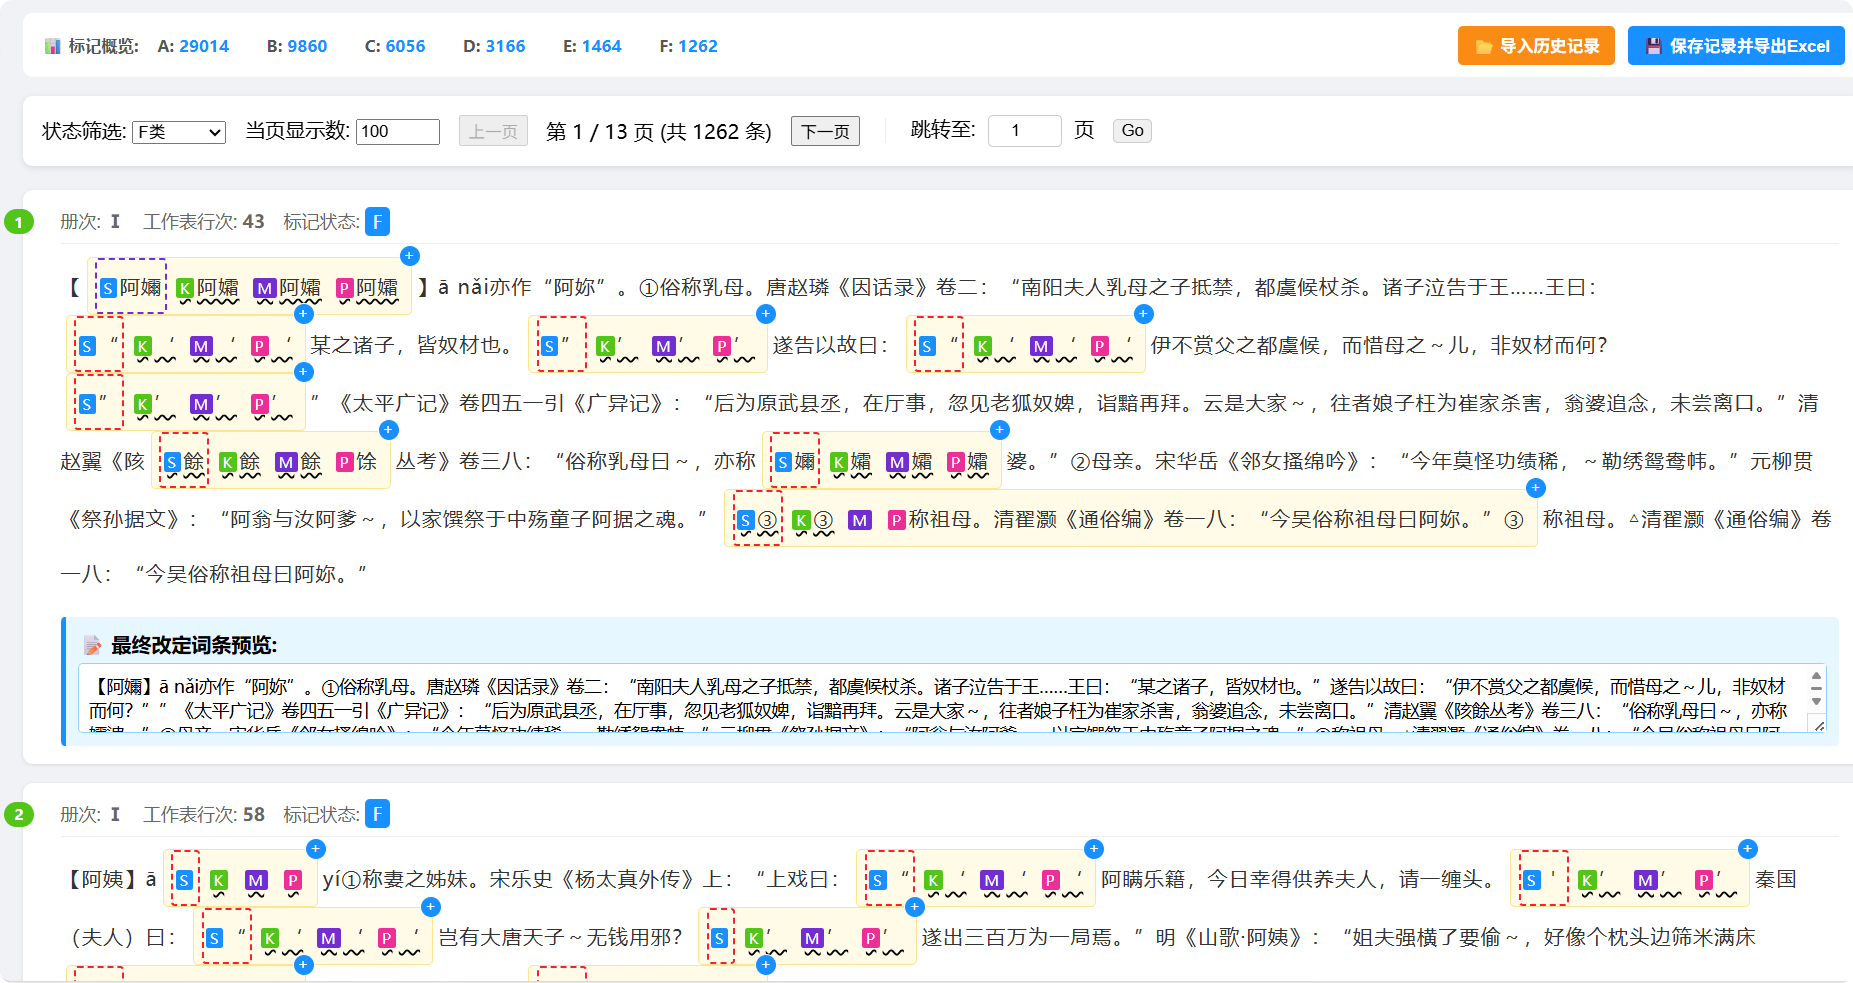
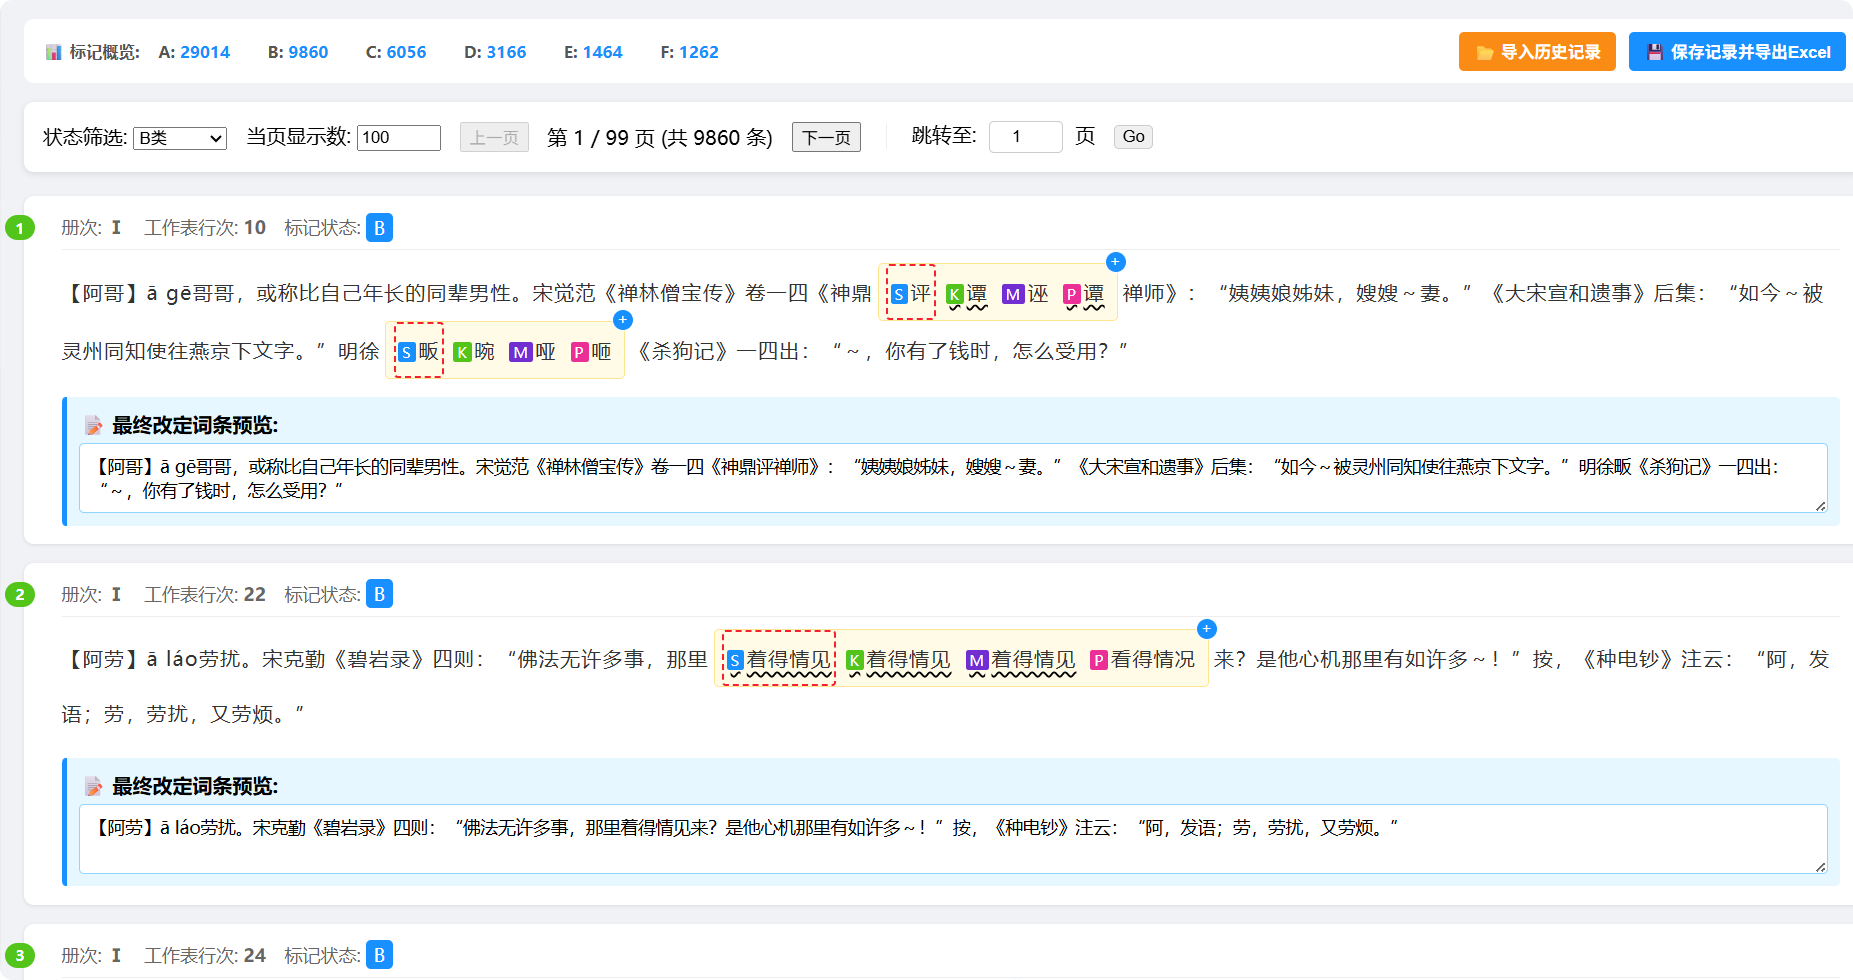
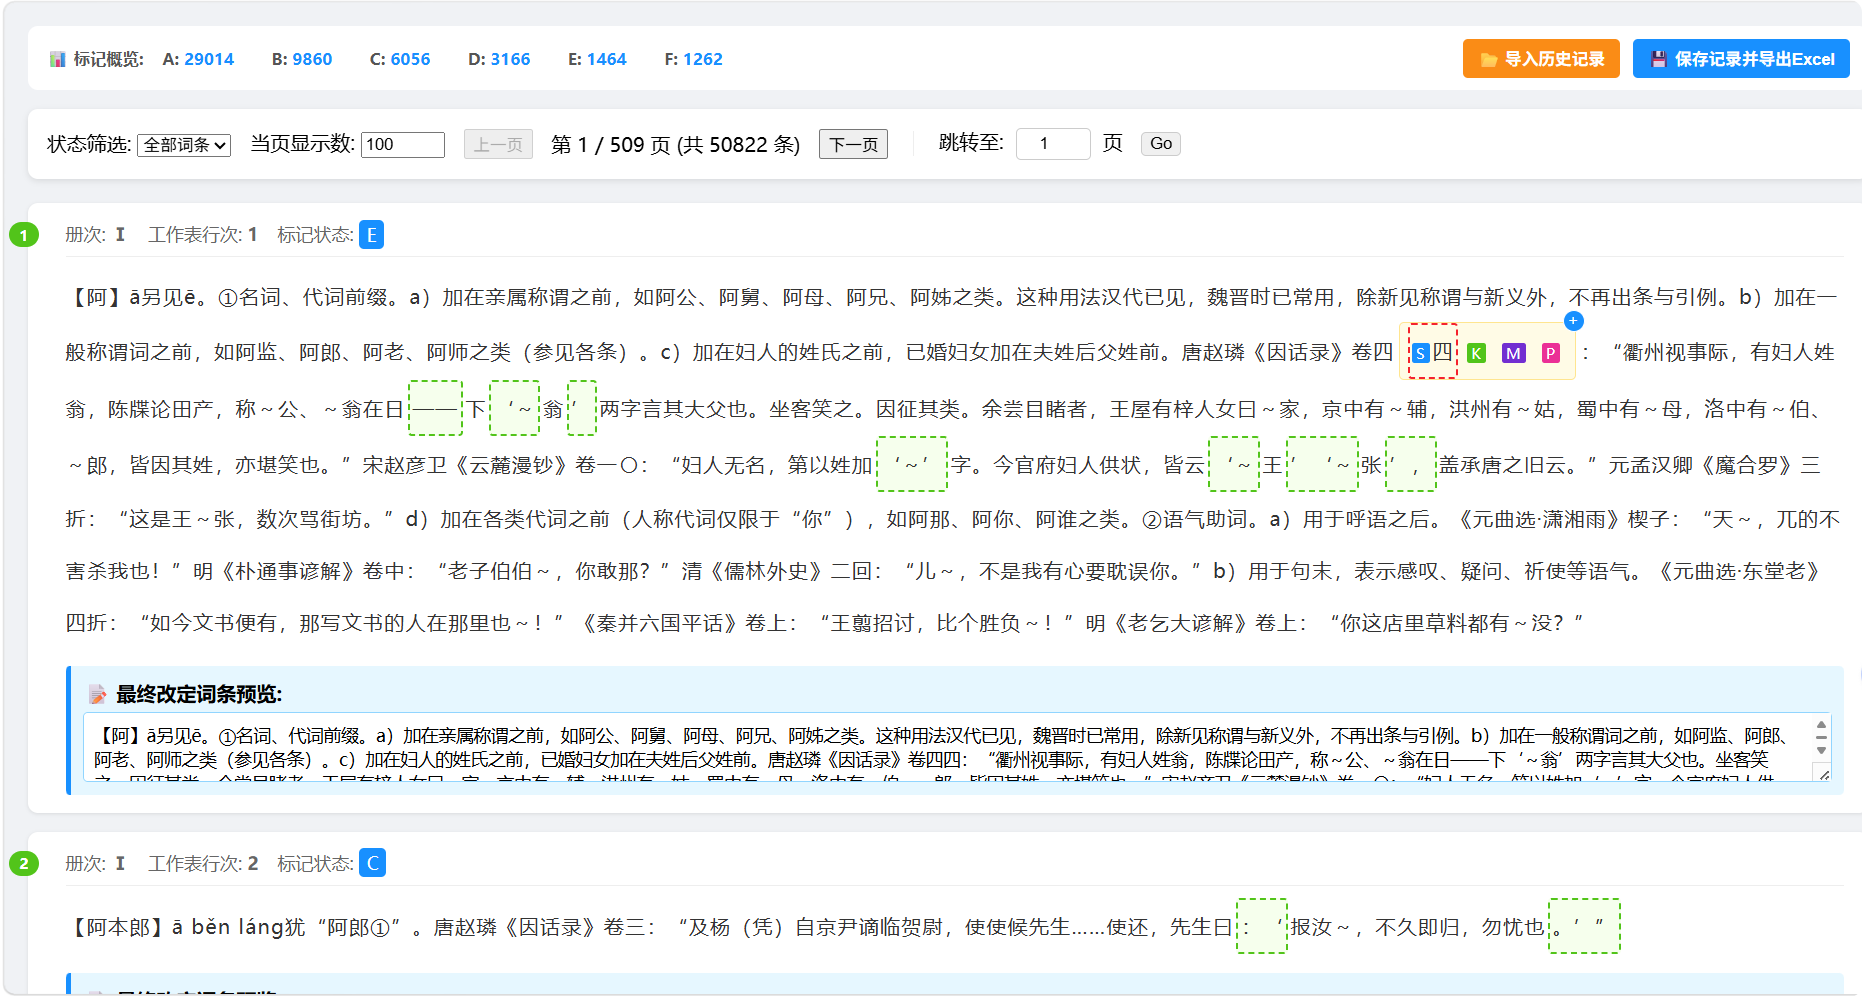
前段日子在gemini的辅助下,我构拟了一个汉语词典同源词条半自动化校对工作流框架代码。初衷是为了适配上海教育出版社四卷本《近代汉语词典》的多版本OCR文本对校任务。采用“Python 后端 (Flask) + Web 前端 (HTML/CSS/Vue.js)”的前后端组合架构,实现复杂的文本比对(多重序列比对)、丰富的富文本可视化(不同颜色的虚线边框、不同颜色的波浪下划线等)以及复杂的交互逻辑(双击选中、撤销、自定义、全局同步联动)。在启用代码进行核校前,我做了pdf文档初加工(分栏裁切、抹除特定版面要素)、初加工文档OCR识别、多版本词条对齐、词条对照组标注等前置工作。目前还只是尚在粗坯阶段的工作流框架,有很多待完善的地方(如数据存储问题,点击保存时excel格式文档写录的改定词条可能覆盖不到位,存在可视化工作台个人词条已正常、完整修改但导出的本地文档未正常、完整修改;随校对进程推移,操作卡滞问题),只能说勉强可以满足于我自己的基本需求。有兴趣有能力的坛友可以自行优化重构,扩大应用场景(适配更多词典词条校改任务)、丰富交互设计、修补显见漏洞缺陷。
下面附上可视化工作台界面截图、样例文档、多轮次ai引导提示词、工作流框架代码。
界面截图——
样例文档——
近汉1同源文本词条对齐_已标记.xlsx (269.6 KB)
近汉2同源文本词条对齐_已标记.xlsx (298.6 KB)
近汉3同源文本词条对齐_已标记.xlsx (417.1 KB)
近汉4同源文本词条对齐_已标记.xlsx (326.2 KB)
提示词——
汉语词典同源词条半自动化校对工作流搭建=ai提示词.txt (38.0 KB)
代码脚本——
app.py (34.7 KB)
 还有我总觉得或许可以利用paddle ocr产线工具的能力(识别区坐标参数),校改特定词条时跳出图文对照窗口,映射到词条电子文本对应的某页内页截图上下文区域,当然这就非我能力可及了。还有一个改造方向,是小说文本(若干章节)不同版本ocr文本的对校
