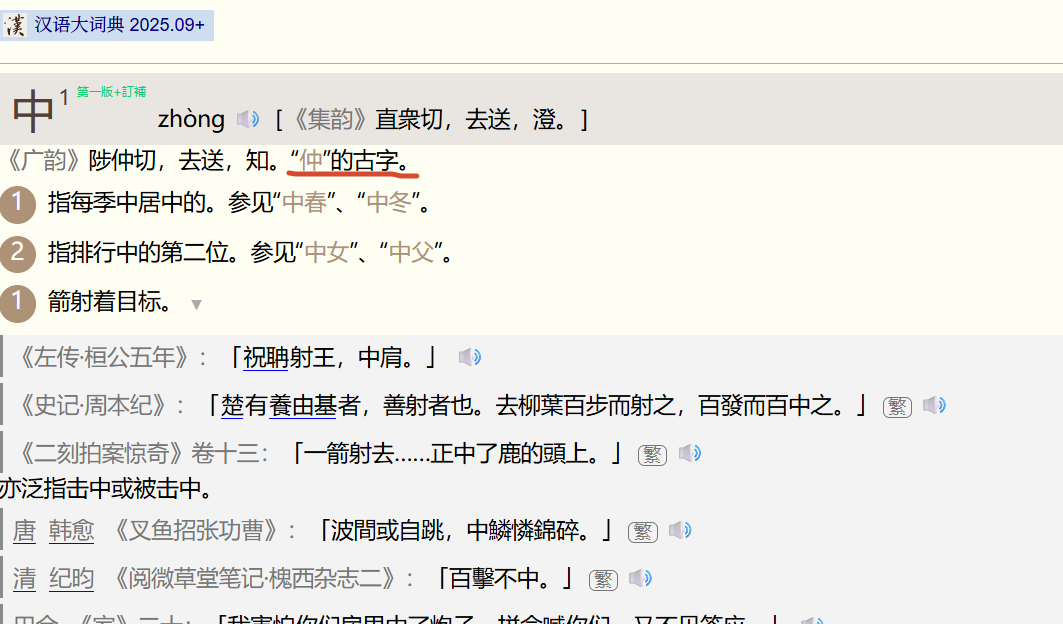
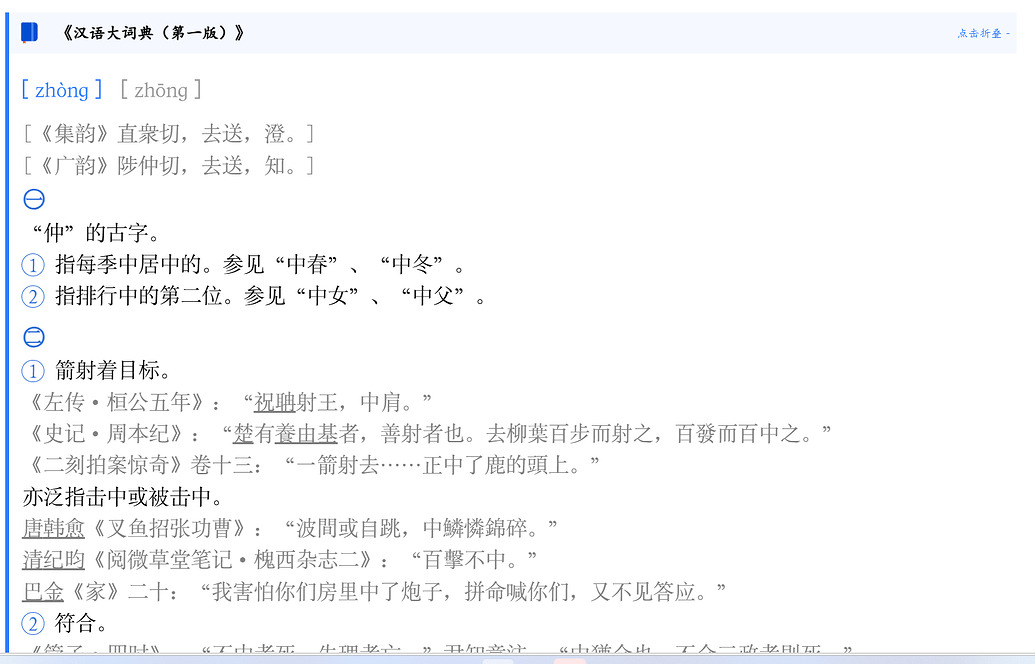
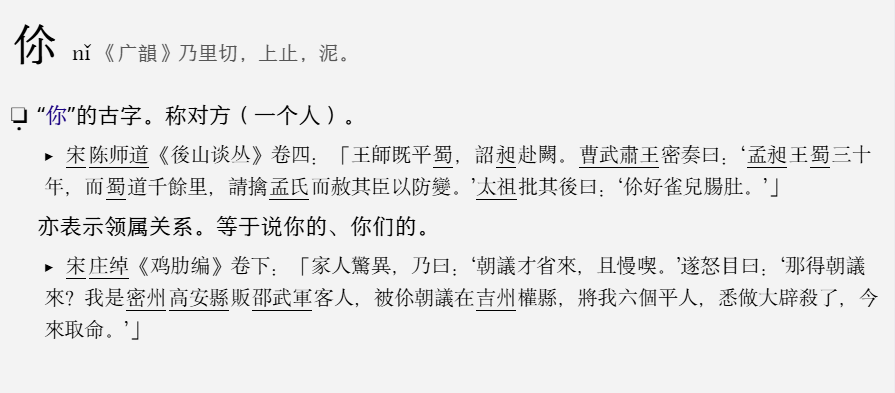
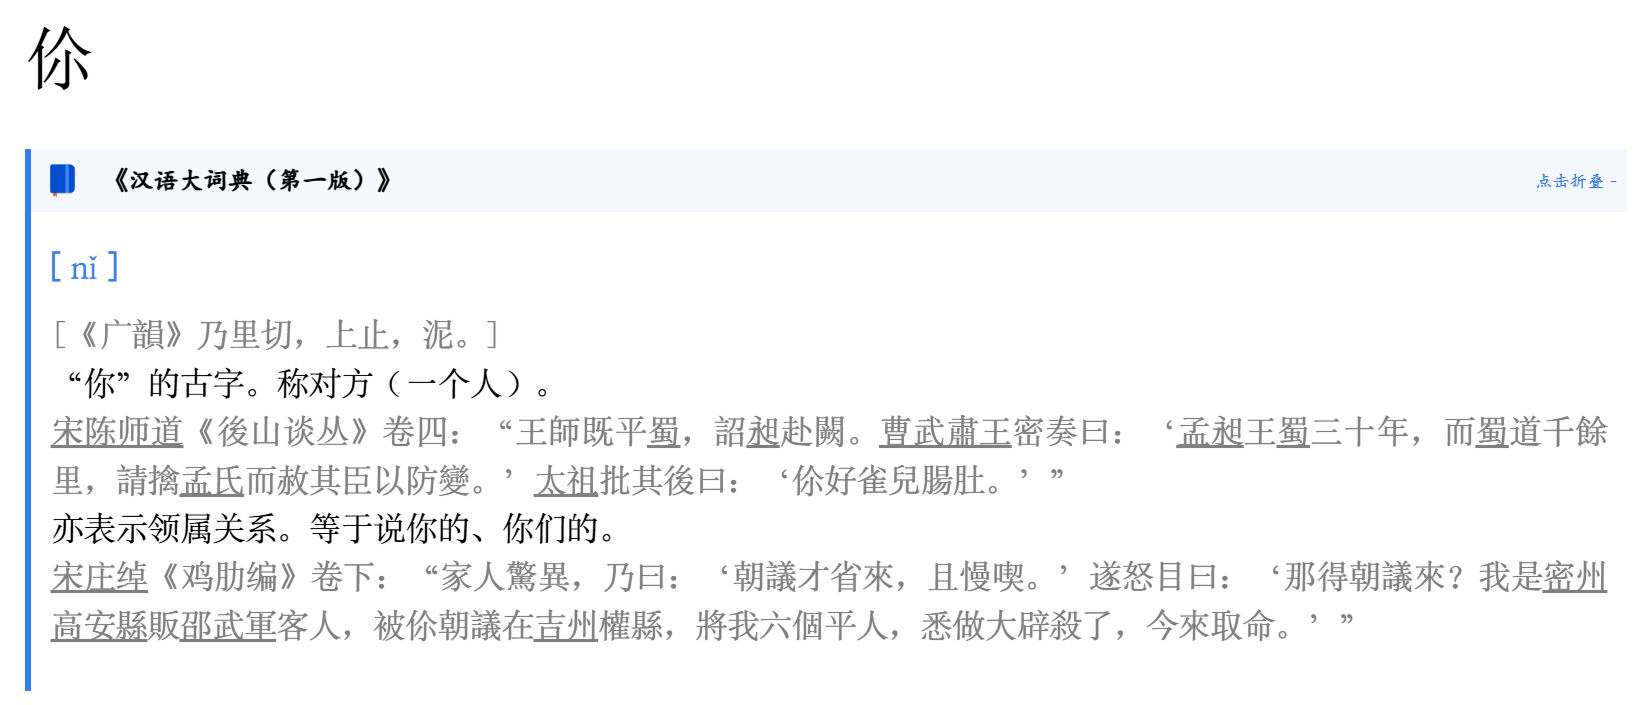
基于leon版(源文件是那个七订fork),对照tsiank版数据并参照自己改的排版汉语大词典originally by tsiank。
版本日志:
20260617:
修复问题:一些以例证开头的释义,会把例证间的释义重复放到前面;还有一些只有例证的释义。现在去掉了重复的释义,并且释义开头的例证都是为释义本身,保留例证的字体,但不再纳入开启隐藏范围、不再分行显示(漢語大詞典 Fork - #111,来自 bmcc718)。
20260615:
(1)修复重构版一些内容丢失。
(2)给A区及以后的字使用子集字体。
(3)非重构版应该不会再更新,也不在此次更新范围内。
20260614:
(1)修复一些繁体追加简体遗漏。
(2)根据拼音重构释义块。
20260613:
(1)修复层级丢失。
(2)处理了一下简繁异的对照,这一块很混乱,反复尝试才勉强凑合,后续还有问题可能只能发现一个解决一个,我估计不会再整了。
(3)修复了一点小问题。
修改内容By Antigravity:
1. 基础音义匹配与重定向支持(v1 & v2 阶段)
- 音义匹配扩展:不仅支持文字释义的精确匹配,还引入了对带有中文引号重定向(如“见“”、“同“”、“通“”)的识别。
- 图像容错与位置修正:实现了“图像容错比对”,并自动将繁体块中缺失的插图标签(如
img容器)修正并补充到对应的简体词条中。2. 变体过滤与核心释义精细匹配(v3 阶段)
- 排斥异体字头:匹配中自动过滤含有
<standard>标签的异体字头,避免其干扰正常的简繁比对。- 核心释义比对(Category B):剥离释义中的书证、引用和标点符号,仅比对纯粹的核心释义,大幅提升了对复杂释义的匹配召回率。
3. 多对一释义分拆与合并(v4 阶段)
- 释义区间分拆:针对“多个繁体单字块”对应“一个简体合并块”的情况,通过算法将简体的合并释义进行区间定位和就地拆分,使得繁体释义块能够精准地与简化字里对应的具体义项进行 1:1 配对。
4. 块级精准排除与扁平化追加(v5 最终阶段)
- 块级精准排除(Exclusions):从原本的“字符级排除”细化为“音义块级排除”
(简体, 繁体, 繁体块序号),加载了 1,991 条 块级排除规则。这完美解决了“干-乾 (gān)”需要保留匹配、而“干-乾 (qián)”及“借-藉 (jí)”需要排除匹配的复杂冲突。- 扁平化
hdc追加:对最终仍无法匹配的 1,273 个 繁体音义块,取消了复杂的level_block插入,统一以<hdc class="appended">的扁平化新块形式追加到简体词条末尾,既保留了繁体字形和释义,又维护了原词典的扁平结构。- 错误简体标签标记与去嵌套:对被排除匹配的错误简体字标签进行 CSS 标记(如
<simp class="exclude">干</simp>),并彻底修复了标签重叠嵌套的 bug。5. 义项异常分拆与格式规范(v5 最终阶段)
- 圈号子义项分拆(Sub-meanings):自动将 15 处在单个
<mean>内混杂了⑴⑵圈号的异常排版分拆为标准的<submeans><submean><xh>(N)</xh>...</submean></submeans>标签结构。- 排版格式规范化:将所有
<trad>、<simp>、<standard>标签统一规范为前置<deriv_type></deriv_type>属性的格式,并将<ZI>和<EXTBI>标签强制保持为大写。
20260607:
(1)修复中zhong4的层级丢失。
(2)优化义项和例证的层级关系。
(3)给异体字加了@@@。
(4)将词语表嵌入到字释义中。
(5)改排版、改功能(原来的css和js不晓得还能用不,应该不需要改很多,喜欢原排版的自己改吧)。
有错误请反馈,工作原因近期只有周末有空时处理。
(AI真的好用,codex、antigravity这些工具真是做到了自己以前不敢想的事情)
百度盘:链接