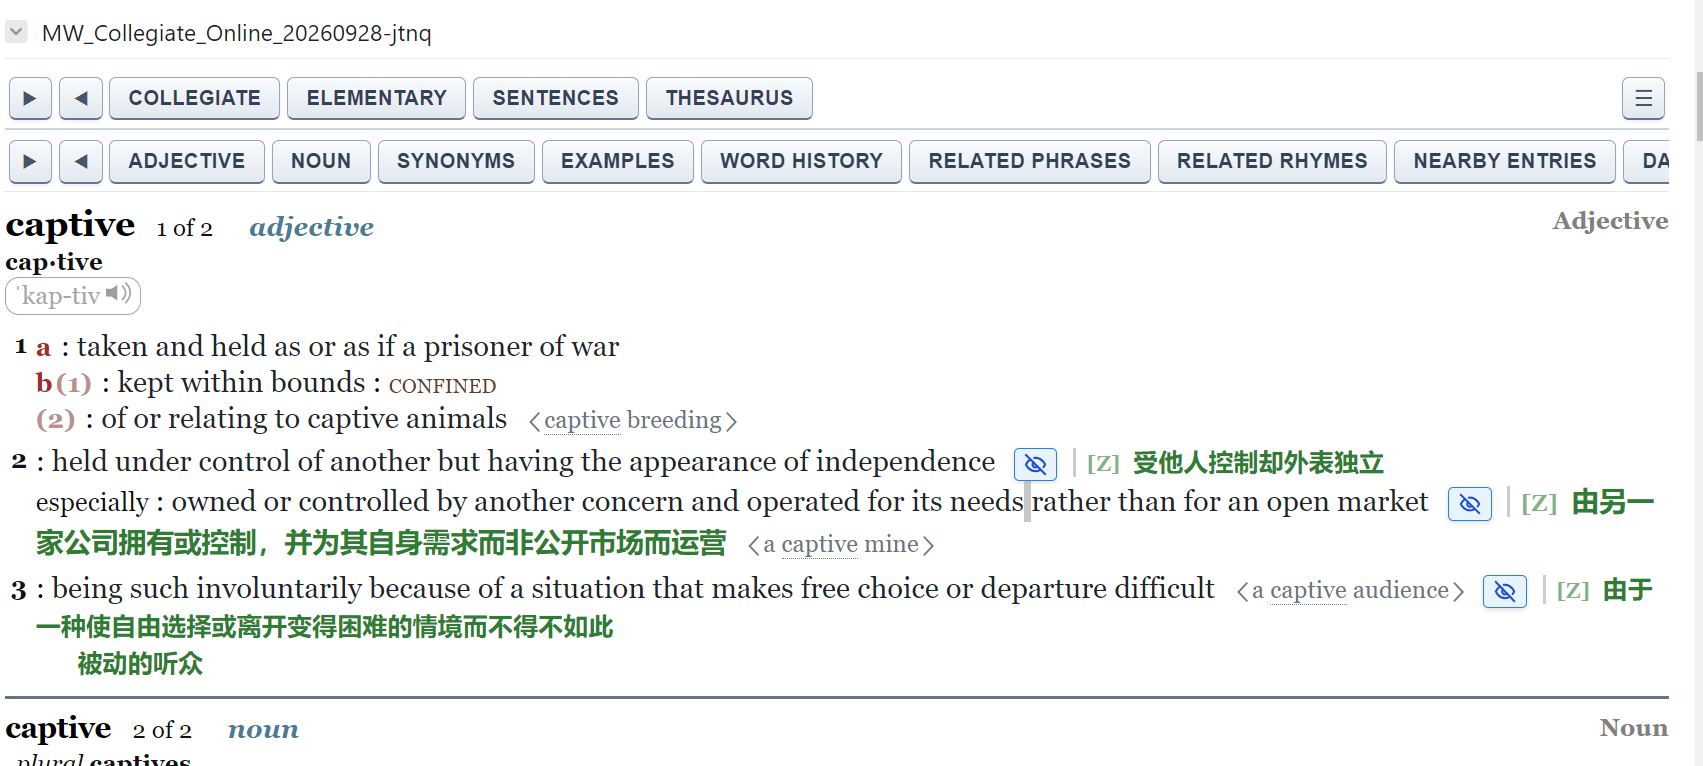
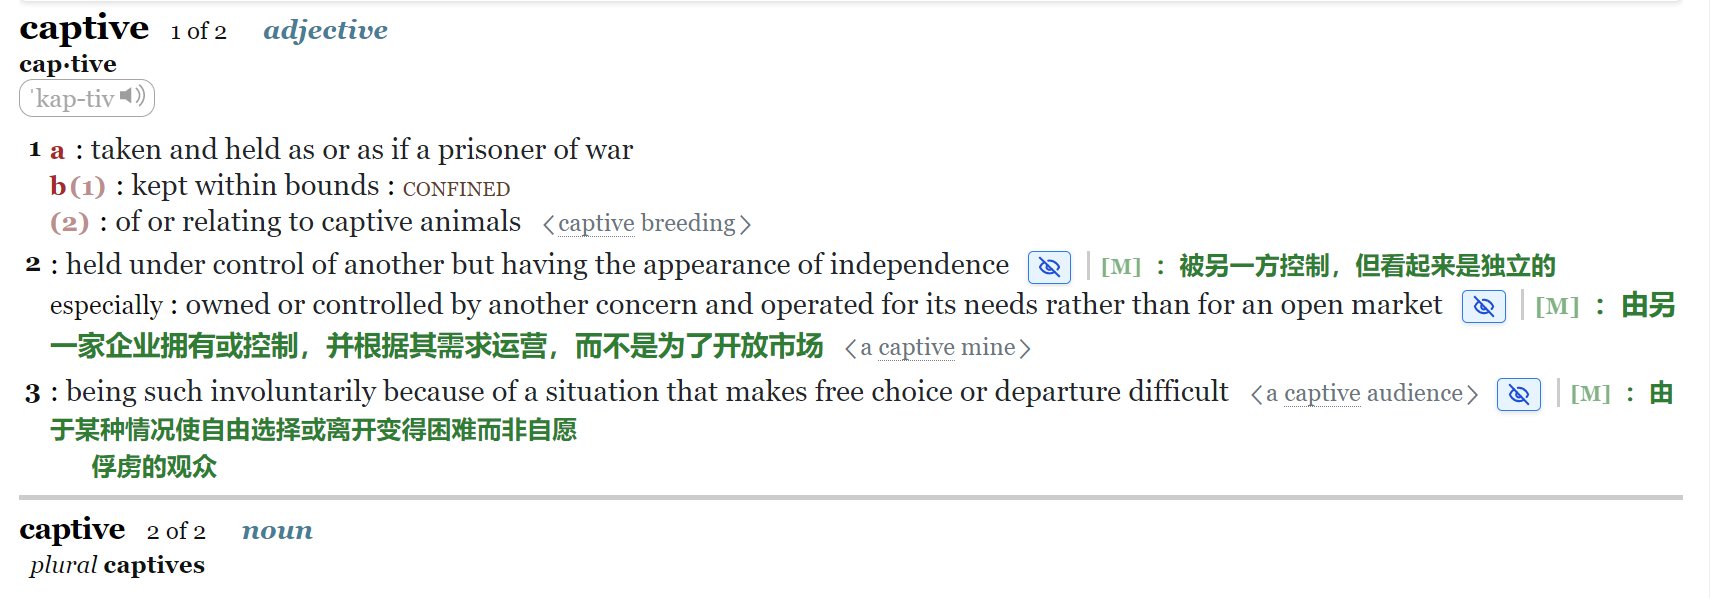
这个翻译还好
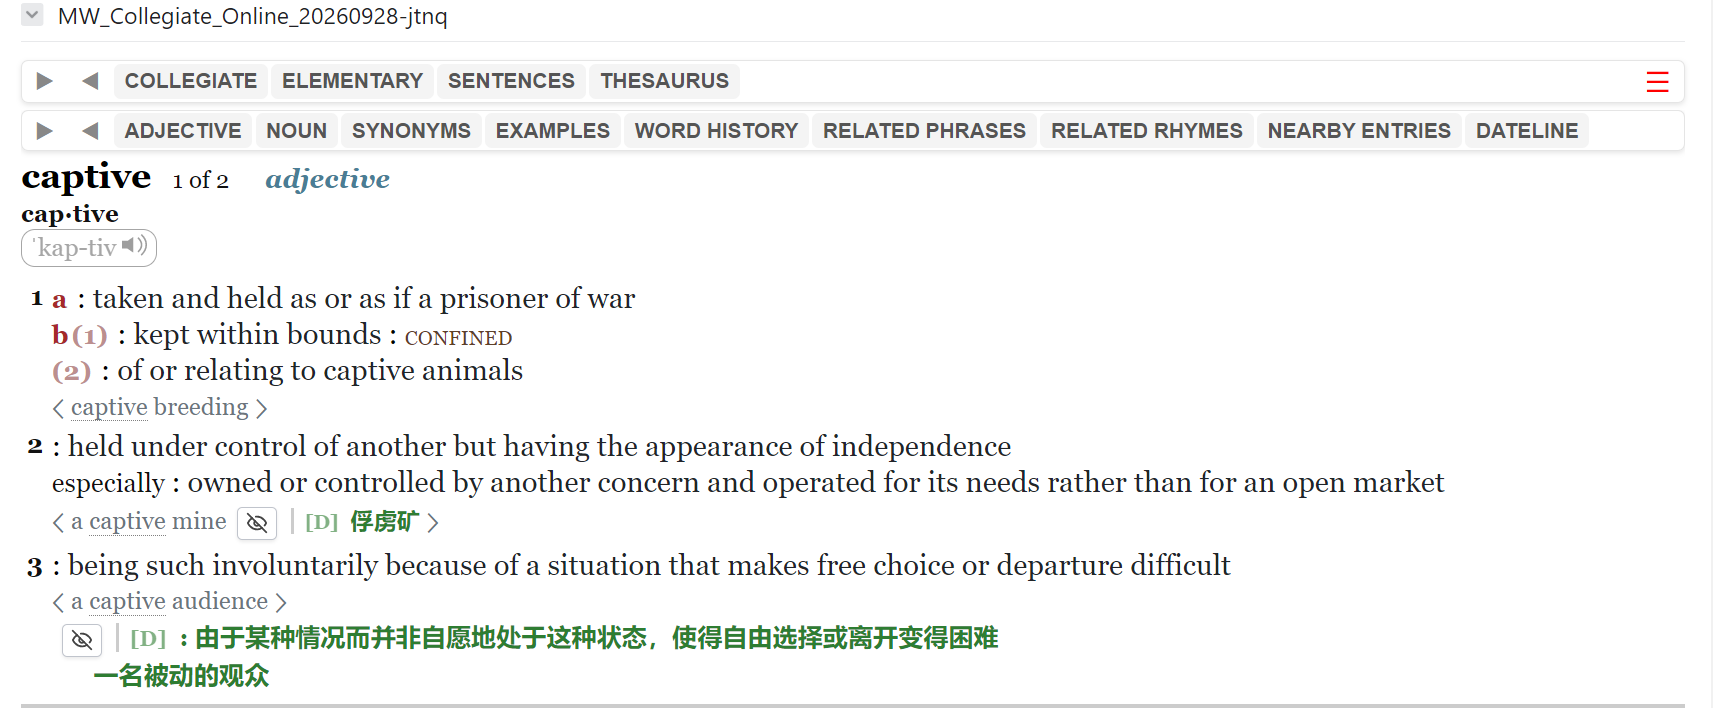
免费的没被墙的可能没D好.
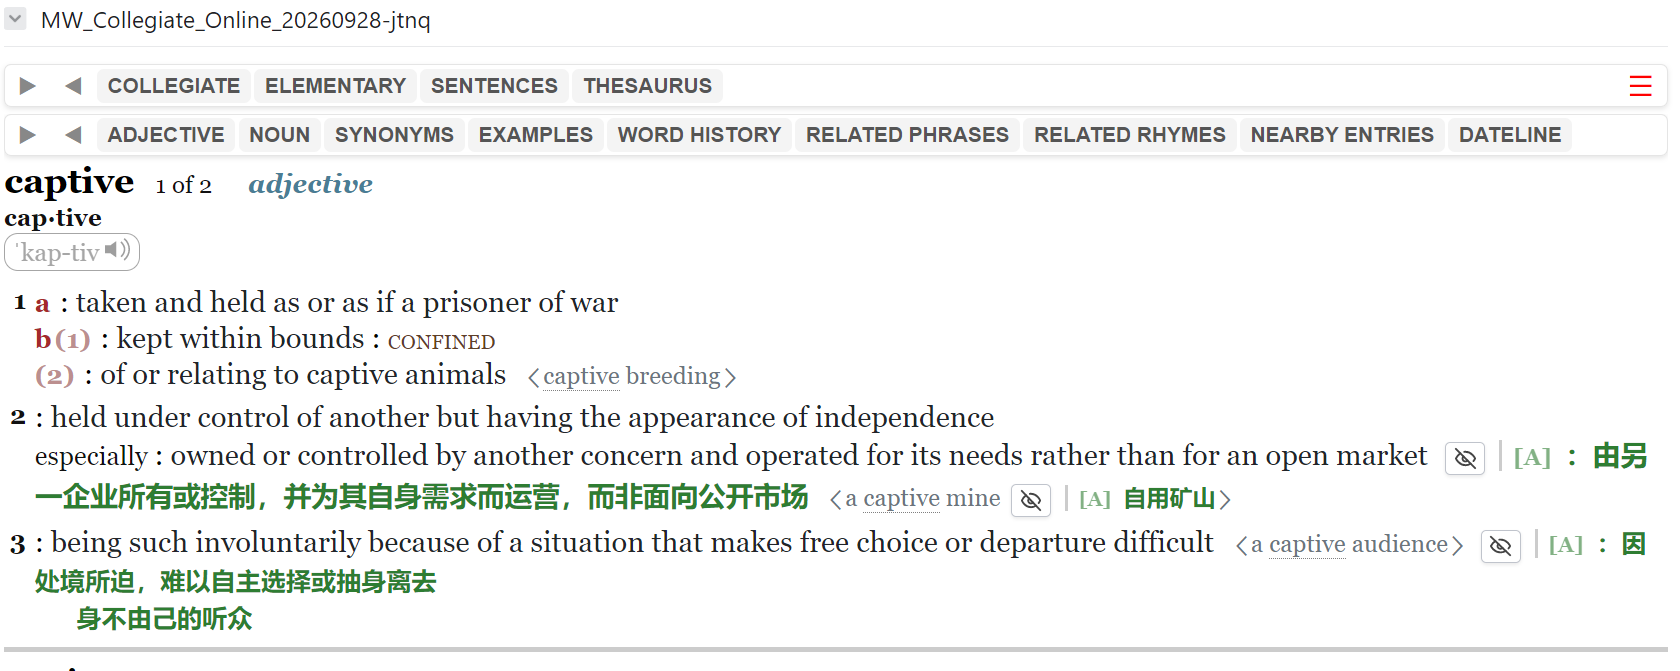

Mobile version
I’ve tested in Dictango 2.3.7.8 and MDict 2.3.7
To enter sub menu mode tap the main tabs once.
On Dictango there is a bug when I tap on the far right to expand a menu or open a spoiler. I couldn’t figure out what it is.
jtnq mobile version.zip (29.1 KB)

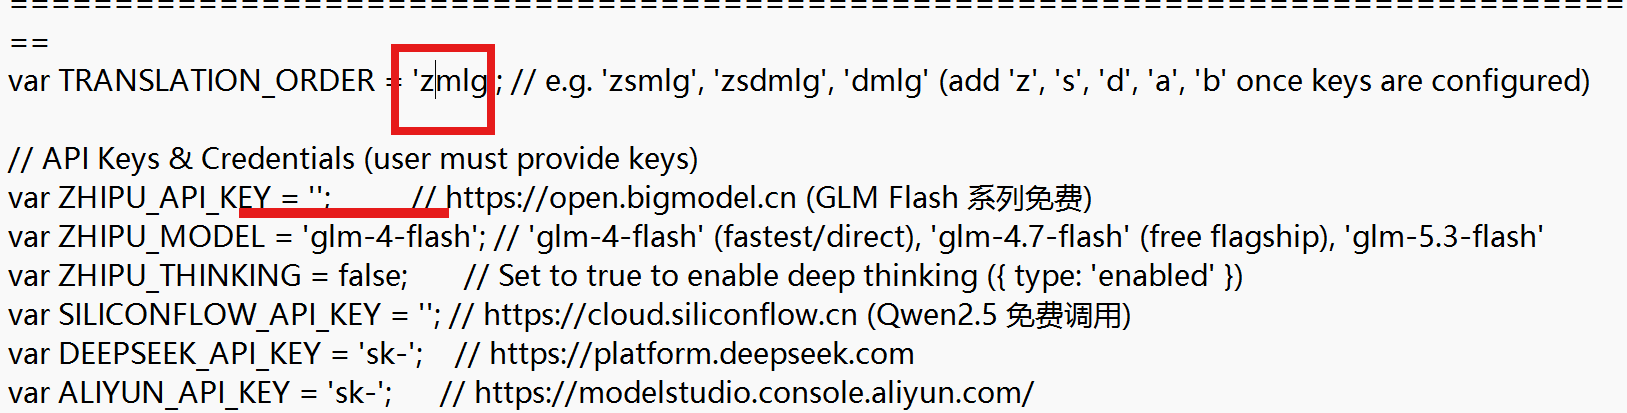
差不多这样,在测试过程中,建议只放一个字母,可以报错。否则会默认滚动到下一个字母,把错误原因压制掉了,蒙在鼓里。
感谢更新!回报一个问题(俄版GD/安卓欧路):查询“hold one’s peace” > 点击“hold one’s tongue” > 错误跳转(打字输入“hold one’s tongue”则正常)
谢谢, 看来是链接没有清洗彻底,我会修复更新.
href="gdlookup://localhost/hold one&?gdanchor=x27;s tongue"
貌似MdictPC没这个问题.
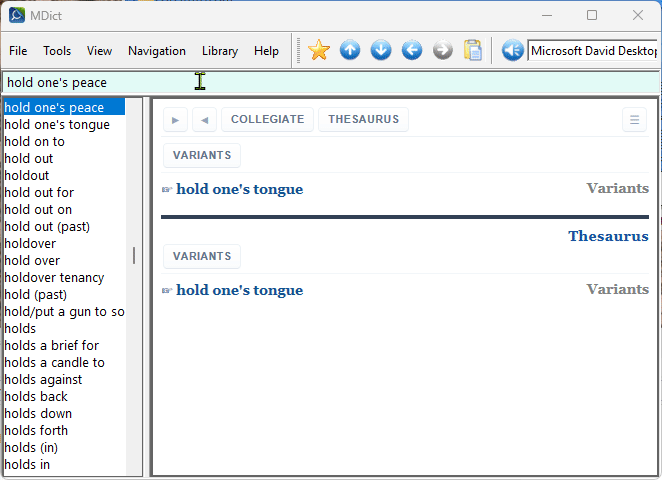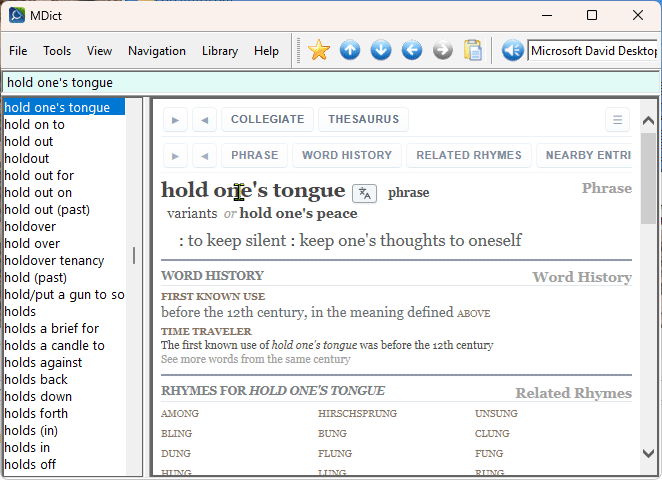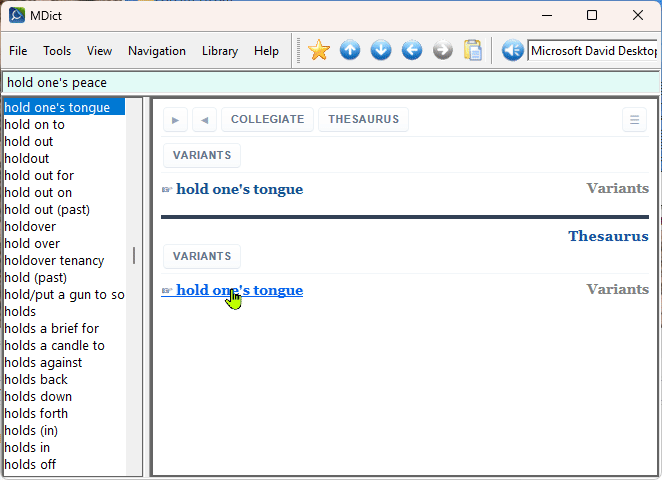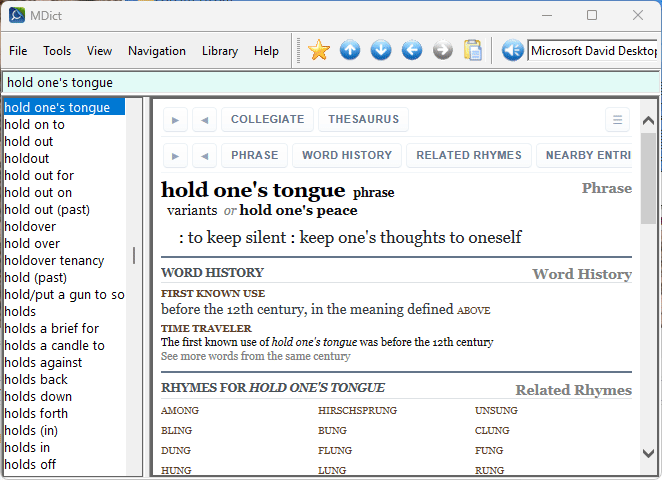
看了GD的代码, 好像是这个原因:
-
按照规矩, 字典生成html时会 escape 所有内容 “hold one’s tongue” =>
<a href="entry://hold one's tongue">(escaped apostrophe into entity containing#) -
GD用比较危险的regex (mdx.cc) 直接处理encoded内容, GD应该先parse DOM 然后再decode内容
QRegularExpression wordCrossLink("([\s"']href\s*=)\s*(["'])entry://([^>#]?)((?:#[^>]?)?)\2");
因为内容字面上有html 特殊符号 # 而错误被割裂成 Headword ("hold one&") + Anchor ("x27;s tongue")
GD然后会跑下面的一步生成 href="gdlookup://localhost/hold one&?gdanchor=x27;s tongue
QString newTxt = wordCrossLink.cap(1) + wordCrossLink.cap(2) + "gdlookup://localhost/" + wordCrossLink.cap(3);
if (!wordCrossLink.cap(4).isEmpty())
newTxt += QString("?gdanchor=") + uniquePrefix + wordCrossLink.cap(4).mid(1);
- 等到跳转的时候, Qt’s WebKit/WebEngine DOM 按规矩把 词头读取为 “Hold one&”, 跳转为空
是第二步GD跳过了应该的步骤使然, 折腾html的时候用regex很危险, 以下两个链接都合规,但是第一个会在GD里面报错
href="entry://hold one's tongue"
href="entry://hold one's tongue"
再请教下,它也是一样原因在安卓15欧路v26.8.4上吗?(词头显示)欧路:“hold one”;GD:“hold one&”
(不确定)AI的回答:改为 href="entry://hold one's tongue" 或 href="entry://hold one%27s tongue",就能完美避开 GD 的 # 陷阱和欧路的 & 陷阱。
额外补充(给小白如我的坛友们参考)
在这些词典软件中,href跟url是一摸一样的机制吗?
不完全是一回事。href 是 HTML 的属性(容器),而 URL 是网络地址的标准规范(内容)。它们属于两个完全不同的解析层级。
软件在处理点击跳转时,正常的标准流程应该是先拆包装(解析 HTML),再读地址(解析 URL)。
1. 第一层:HTML 层的 href (拆包装)
-
作用:
<a href="...">是 HTML 用来存放链接的语法。 -
规则: 这一层必须遵守 HTML Entity 转义规则。比如遇到保留字符,会转成
&(&)、"(")或'(')。 -
标准处理: 渲染引擎(如 Qt WebKit、Android WebView)在用户点击时,第一步是“脱掉 HTML 外衣”,将转义符还原,提取出纯净的字符串。比如从
href="entry://A'B"中提取出entry://A'B。
2. 第二层:URL 层 (读地址)
-
作用: URL(Uniform Resource Locator)是一套通用的资源定位标准(包含协议
scheme://、路径path、参数?key=value、锚点#fragment)。 -
规则: 这一层有自己的功能性符号(
?,&,#)。如果内容本身含有这些符号,必须遵守 URL Encode 编码规则(即%XX格式,比如单引号是%27,空格是%20)。 -
标准处理: 软件拿到上一步剥离出来的干净字符串
entry://A'B后,按照 URL 标准识别出它是entry自定义协议,并读取后面的路径(词头)。
GoldenDict 和欧路到底错在哪了?
它们犯了“跨层级混淆”的严重错误:拿解 URL 的规则,去硬切 HTML 的源码。
-
标准做法: 等浏览器内核把
href里的内容彻底还原成干净的 URL 字符串后,再去寻找#(锚点)或&(参数)进行截断。 -
GD/欧路的错误做法: 它们为了追求速度或由于底层接口调用不当,直接跳过了 HTML 解码这一步,用正则表达式直接去扫描原始文本。
-
灾难发生: HTML 转义符
'里自带了&和#。GD 一看到#就以为遇到了“URL 锚点”;欧路一看到&就以为遇到了“URL 参数分隔符”,直接把后面的内容全切掉丢弃了。
结论与启示
href 里装的是被 HTML 规则包装过的 URL。两款软件的机制并不完全一样(切分的符号不同),但犯错的逻辑是一模一样的。
为了兼容这些解析逻辑不严谨的软件,制作词典时最稳妥的做法是只用 URL Encode,完全摒弃 HTML Entity 转义。即写成 href="entry://hold one%27s tongue"(%27 既不会触发 HTML 里的 & 和 #,又是绝对标准的 URL 规范),这样所有的词典软件都能正确识别。
大概率是,因为那个regex属于GD最常用核心逻辑,应该很少改动.
欧陆闭源,没法知道,但是如果错得类似,也是同病相怜.
目前最直接办法就是碰到apostrophe就特别处理去掉 #, 得更新mdx
MdictPC可能没有依赖regex干这脏活.
10号更新啦,谢谢。mdx有何变化,多了二三十兆
@qdreader 先别下载,发现处理的时候丢掉了widgets(Did You Know, Little Gems, Usage Discussion, FAQs), 尽快更新完整的
@xingxingla mdx设计的时候加一个 protocol本身没问题,只是软件在处理html的时候当string用regex简单粗暴处理,会有漏洞. 如果特别弄一个mdx的规则会有后续麻烦. html本身就支持各种protocol. “entry://” 相当于protocol.
目前的解决方式大概是各退一步 实际有内容的条目条目的名称尽量只包括连字符 空格 和英文字符 实际有特殊符号的名称用链接的方式指回标准名称的html条目
sound://a#b.mp3 需不需要转义也是一个问题。还是说转义这一块是需要明确的规范性的。以及通常情况下需要动态创建sound://和entry://的protocol也会因为词典实现受到阻碍。。。日后也许会有更规范的mdx实现标准
越简单越好,规则太多会出问题.
这是软件用regex的问题. 不能为了软件的错误来改动规则.
一些本来就应该写好的代码就能做到的事情,为啥去修改规则.
既然各大软件(欧路,Goldendict)都不支持这样写也不得不做一些妥协。
另外我一直有一个疑问到底是应该转义为 's还是%27,如果是url应该是%27的