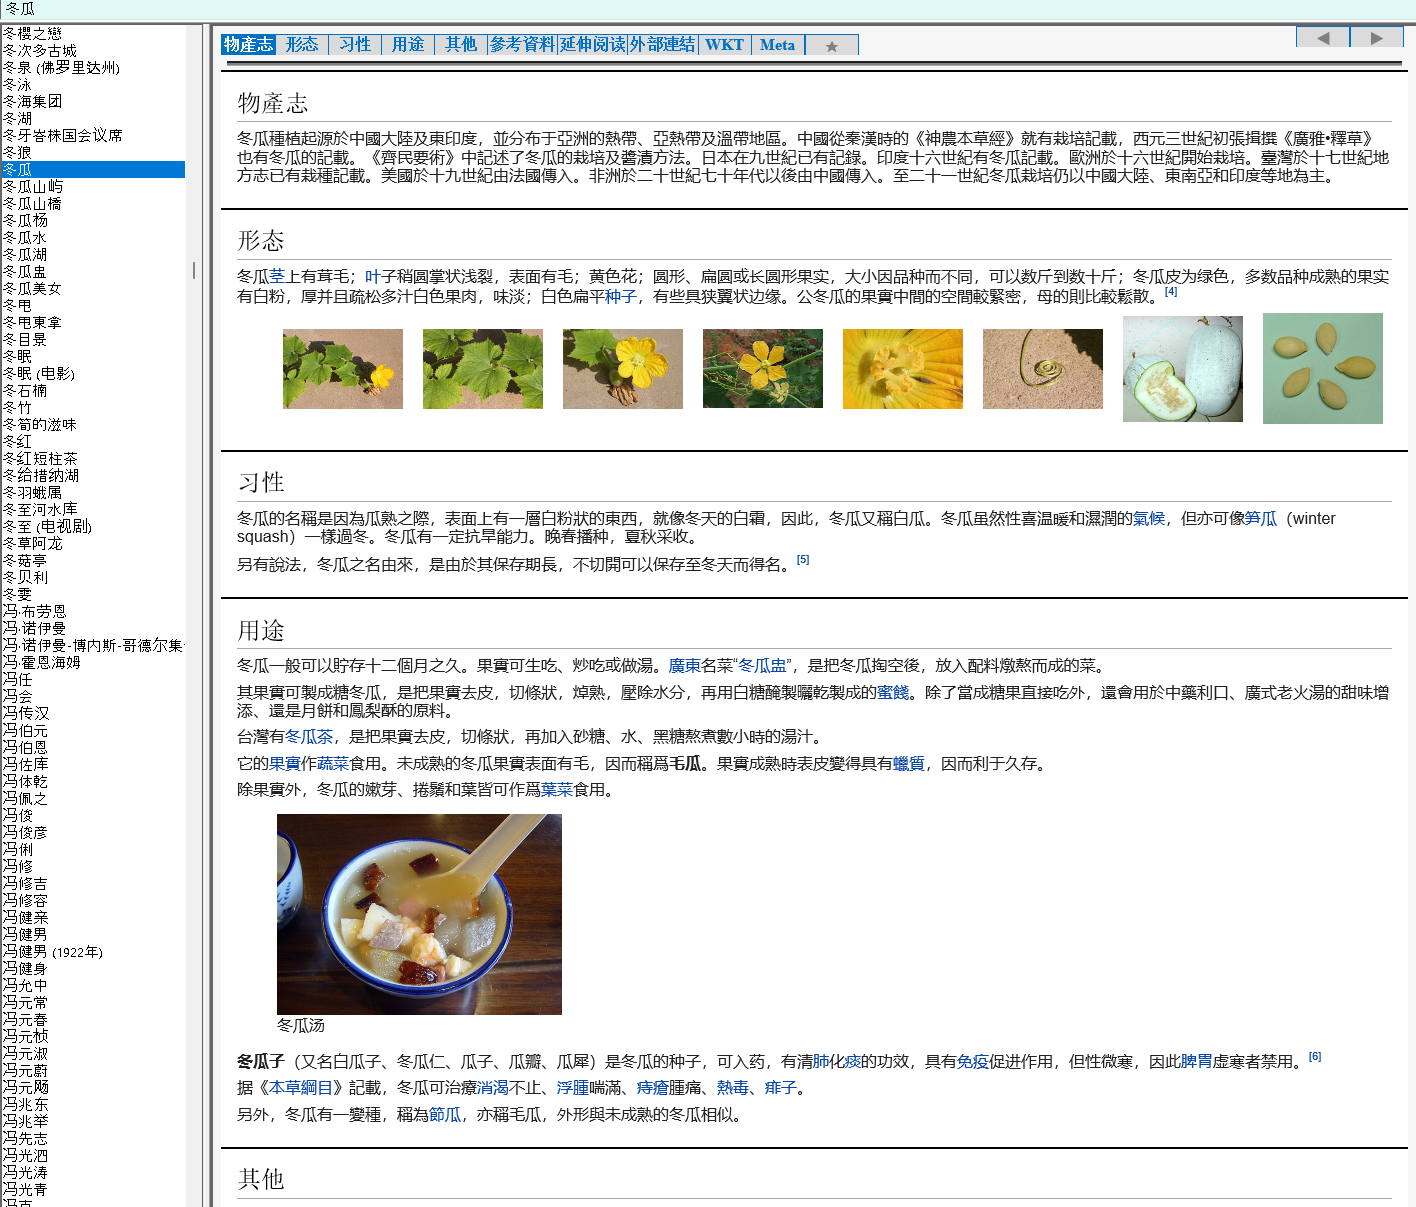
中文维基 zh.wikipedia.org 20231001 (9月离线123GB照片+10月mdx)

FreeMDict没法上传/太慢

FreeMdict Cloud

百度: 百度网盘 请输入提取码

大约来自10个2GB json文件。一共100个这样的文件,处理10个大概10小时。
数据有可能不完整,以后 Index - Wikimedia Enterprise HTML Dumps完善再跟进也不迟。

image

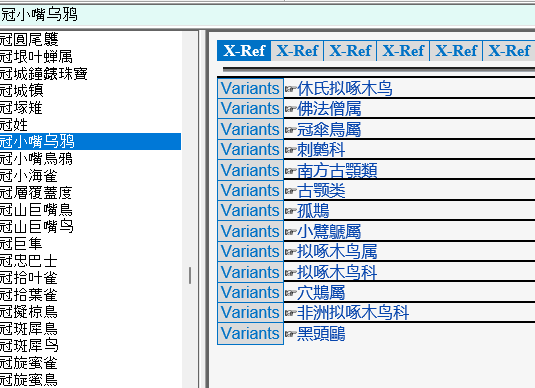
特点:保留了里面的languageVariant (联想相关内容)做了link,参见图二。

图像数据mdd 位于0901文件夹里面,就一个 .1.mdd文件,还是可以通用于其他日期的版本的。其他日期的版本加一个小的补集.2.mdd即可,绝大多数图像都重合。

厉害!
非常感谢!

感谢楼主无私奉献。很可惜文件链接打不开,恳请再次上传到百度云盘可好,非常感谢!!

行动派真的可怕!

太赞了!感谢楼主大神,这行动力无与伦比!

太厉害了。十分期待。也期待有人做出日语的。

上传太慢,几个小时才1gb,等。。。

感謝製作!可重新上傳 :grinning:

感谢分享,辛苦制作

非常感谢,等全部出来啊

Thank you so much for your contribution! I wonder if you use some kind of multi-threading to reduce the time of processing…

I do use multithreading, and even with that, it takes a very long time to process, memory and disk intensive too. Probably more than an hour per json file (2GB data) and average 20 hours per mdx.

May I ask how many threads you are using?

I have 12 cores / 24 threads, 64GB memory. Each mdx is exactly 20 json and approx 1/2 million entries.

Thank you so much for your explanation. The workload is indeed heavy.

It wasn’t designed for big data, wiki is orders of magnitude larger than the largest dictionaries, such as OED. I guess the process is adequate but slow given the file sizes.
配置好强,看来未来如果要做大型mdx得换个旗舰cpu了。

除了wiki,不知道有啥mdx需要特别大的配置,32gb足矣

mdx 这个格式相对简单,实际可以一边读一边写磁盘,最后再拼接起来,用不了多少内存。全读内存比较省事,看看以后有没有人改进。

我要去重,还有很多细节,放在database里面处理,最后形成mtext,这里有些单线程,最后全部内容必须放在RAM里面,比较费力。