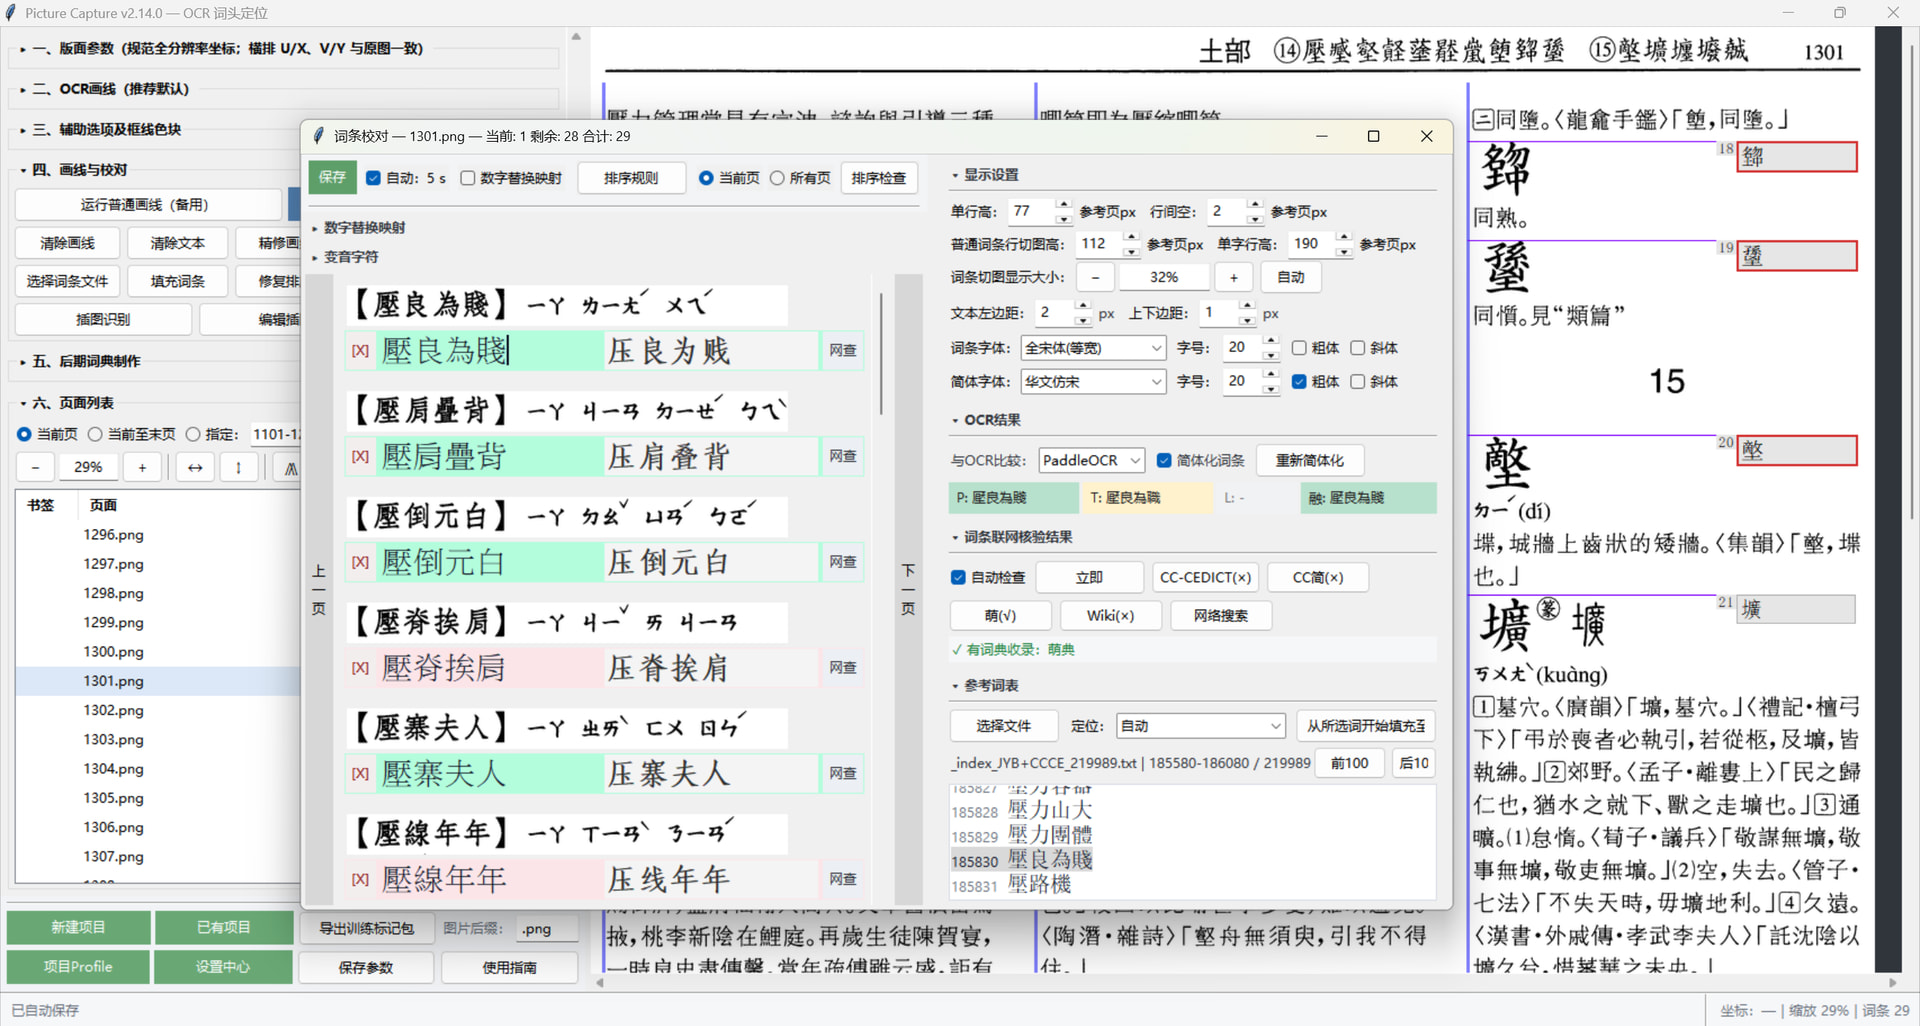
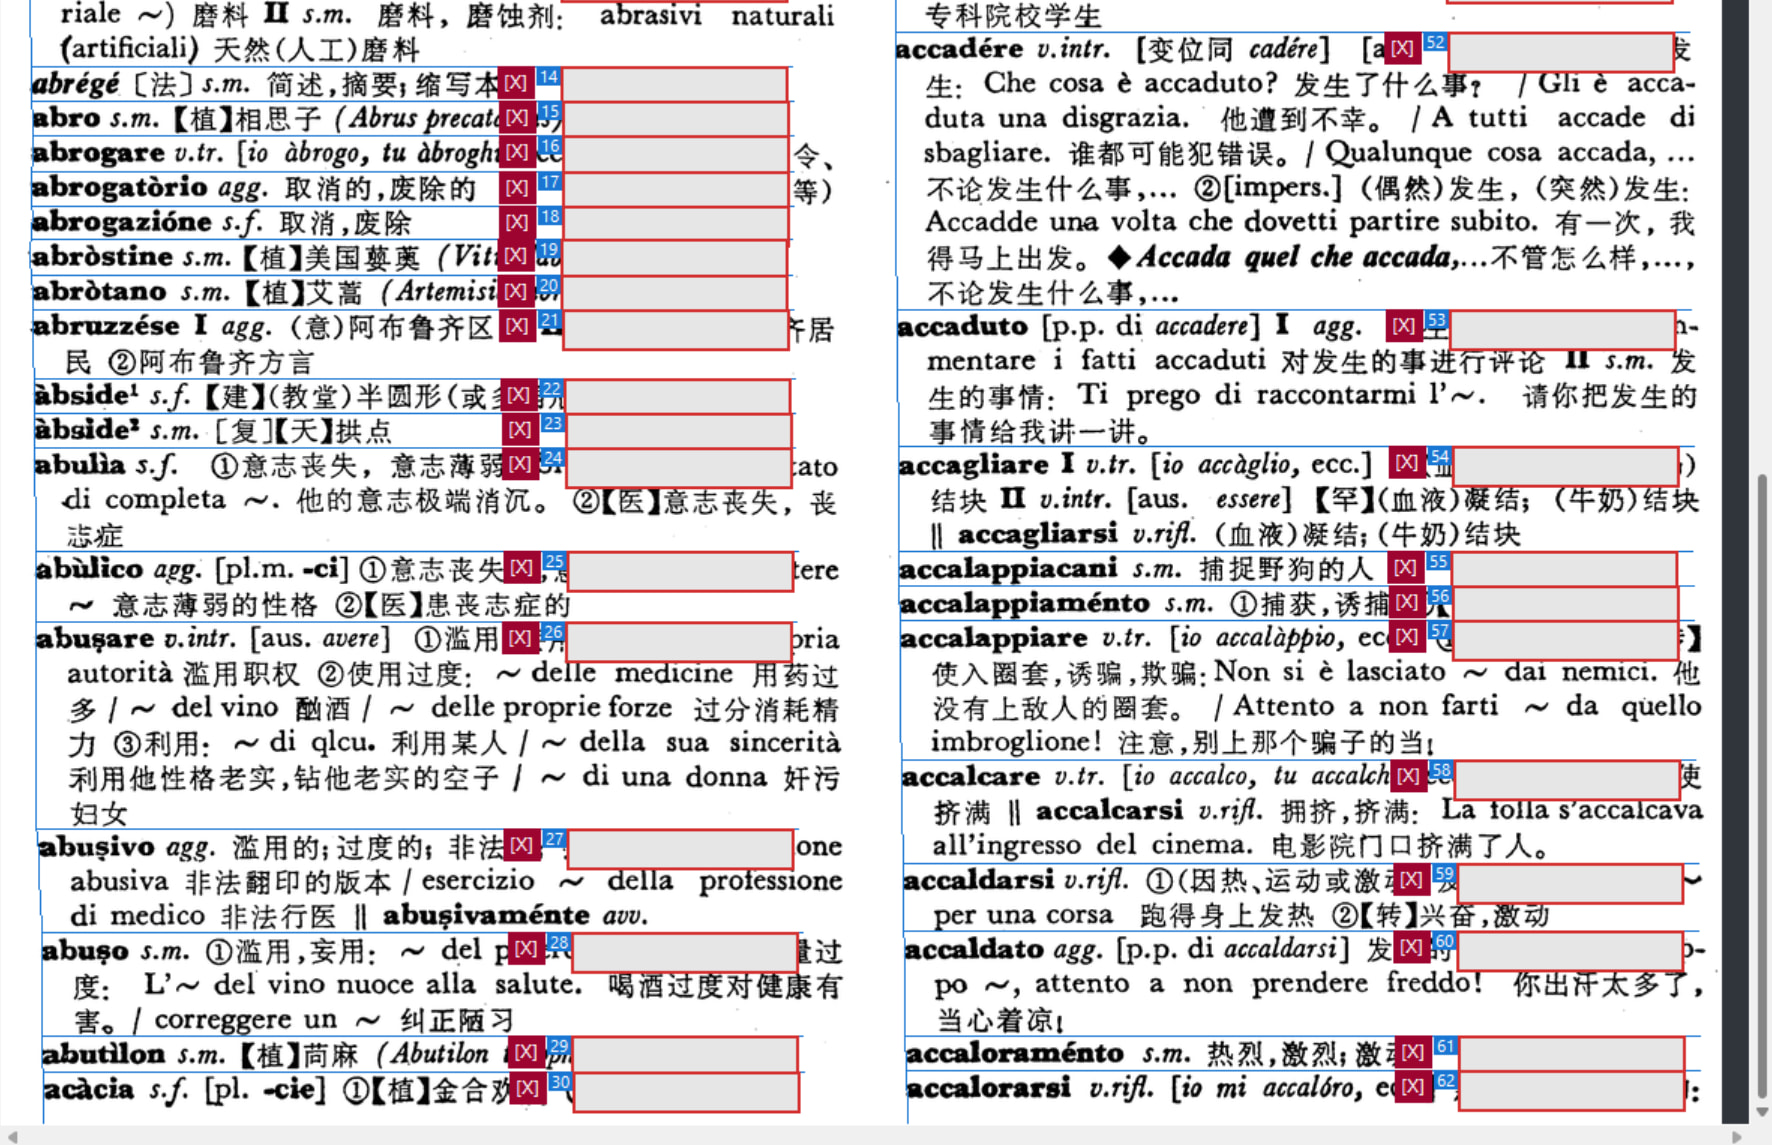
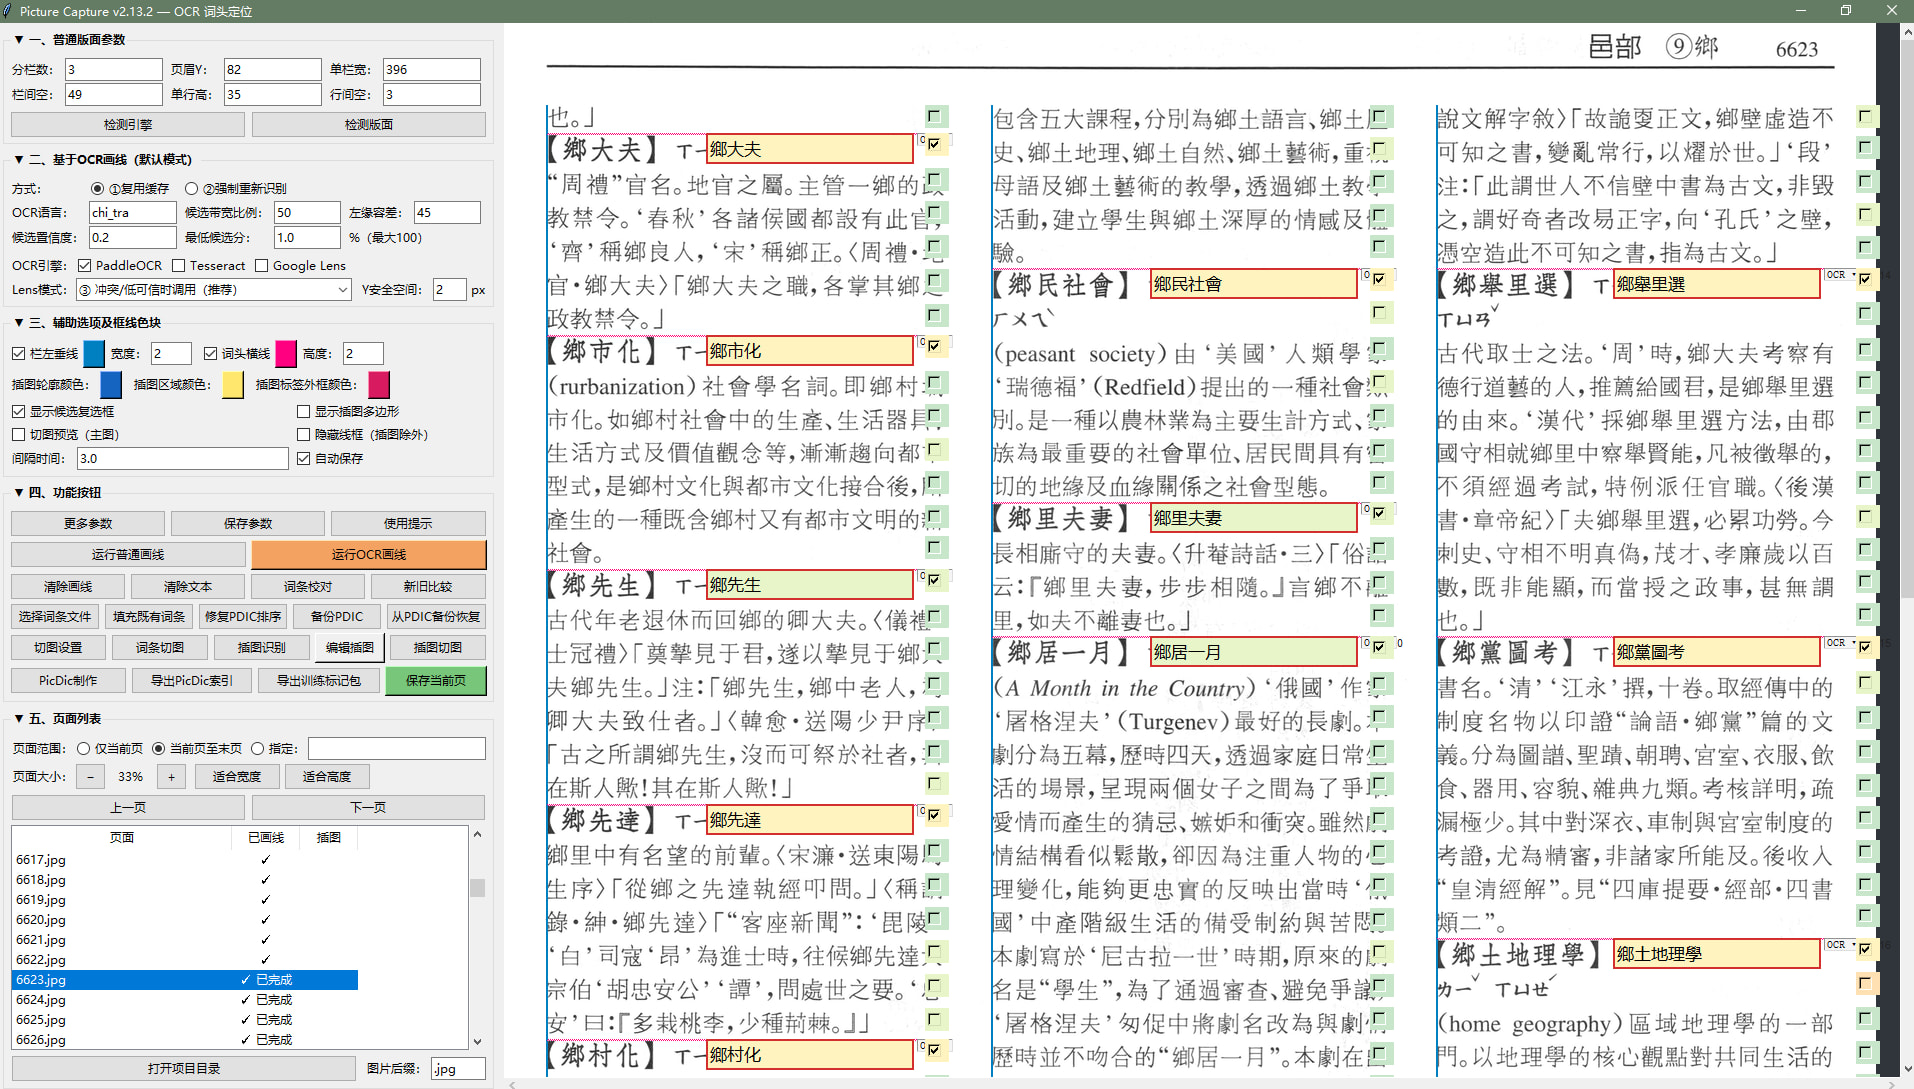
看起来画线很好,OCR结果页不错,你再搞一个参考词表,校对的时候还能提示;
校对界面还有自动简体化词条,既可以帮助校对,也可以帮助构建正确的简体词条(因为单纯用OPENCC转的不一定都对)
我在使用的版本是最新测试版(还未发布,在修理bug, 很快就会发布)
普通模式是先画线,后OCR;画线极快,毫秒级。
多谢!升级版发布了吗?看github上还是一周前的版本
升级啦。改动的原则是“尽量方便工作+方便用户”
可以直接使用源码,不用等 release
即将发布正式release
新版已经发布,请大家测试,祝使用愉快!
后期制作还没有完成,有好几个方案:
(1)全索引切图版
(2)整页精确定位版
A. 安卓GoldenDict/Mdict 我有成熟的PicDic一站式JS为后台的显示/查询/管理插件)
B. 通用的精确定位整页版+瀑布流切换上下页(每个词典都用自己的JS,就是JS等开销成本太高,每一个词典都要单独制作。→ 所以才开发了A)
欢迎大家提供想法。
继续修bug:
把重点筛选改成了真正的批次流水线:
Tk/ImageTk 仍只在 UI 线程创建,保持现有线程安全原则。都这样画线了,是不是具备做成切词版的条件了?
对于需要进一步合并图片的词条,可以先命名为_A/_B/_C/…,待人工确认无误后再处理
一开始的版本就有切图啊
然后为啥要合并图片? 一个词条可以有好几个切图,自然顺序放着就是啦。
这些在VBNET版本就已经成熟了,你查看 切图预览
我想问的是已经有词条及其坐标信息,之后做成APP内词典的形式啦
这回换了%还在适应中、但不耽误使用。(改了%填写后是不是就不挑屏幕分辨率了?感觉可以在别的电脑上直接载入不用更改参数再适配不同屏幕的分辨率了,猜的)
几乎都是自检然后主界面ocr里的键入那向右的像素多少也没啥要自己填写设置的了,这回好像走纯自动适配的方向更如易上手直接用。
再把词头特征根据词典有选择,中英繁简啥的按实际的是啥就选啥。
就可以ocr画线了
14画线没有13成功率高、参数什么的试了。目前还在熟悉这个画线使用中

这个版本用着(大字、【】的词头画完线很准,几乎不怎么再参与检查、修改画线的那种,画错、漏画的很少)。
我用14这个版本画完了大概1/3 — 1/2要手工修改ocr自动画线错误(删减多画的和漏画的,漏画的错误要少、错画多画的多)。
看了下14的temp和13有差别,这个版本ocr应该改了些东西,我在AI词头正则也加了修改后的正则,地方在高级那个选项里的那个,觉得13那个准确要好得多。
我这两个版本切换用要OCR画线几页才正常(②强制重新识别 选上了也要多ocr几页),要不然ocr画线显示文本框和候选那个小方块会叠在一起、猜可能ocr还使用原先的缓存啥的吧。
这个标签底下能加个底色么?别留白,上下滚动页码看着无厘头的就没了、再往回滚动又出来了。纯我个人使用的感觉。

页码列表的栏头我这里都不会消失的,你在什么情况下出现消失的情况?
上面那些设置完成了,就折叠呗,正常就4/6两个区块展开,页面列表怎么都会正常
之所以这么想,是因为:制作词典的最大障碍,其实是准确词条的获取,以及在页面中的定位。按照传统方式,词条获取常是最耗时耗力的一步,而且效果不太理想;而在页面中的定位,限于技术性,更是劝退了大部分人。而 Picture_Capter 是当前解决这两个基础问题的最优秀的工具——画线、OCR、校对等基础工具集,极大解放了人类的肉眼和精力。至于后期,反而是大家擅长的、个性化发挥的环节,没必要局限于特定的一两种风格。
看来还是这样解决方案就行了。