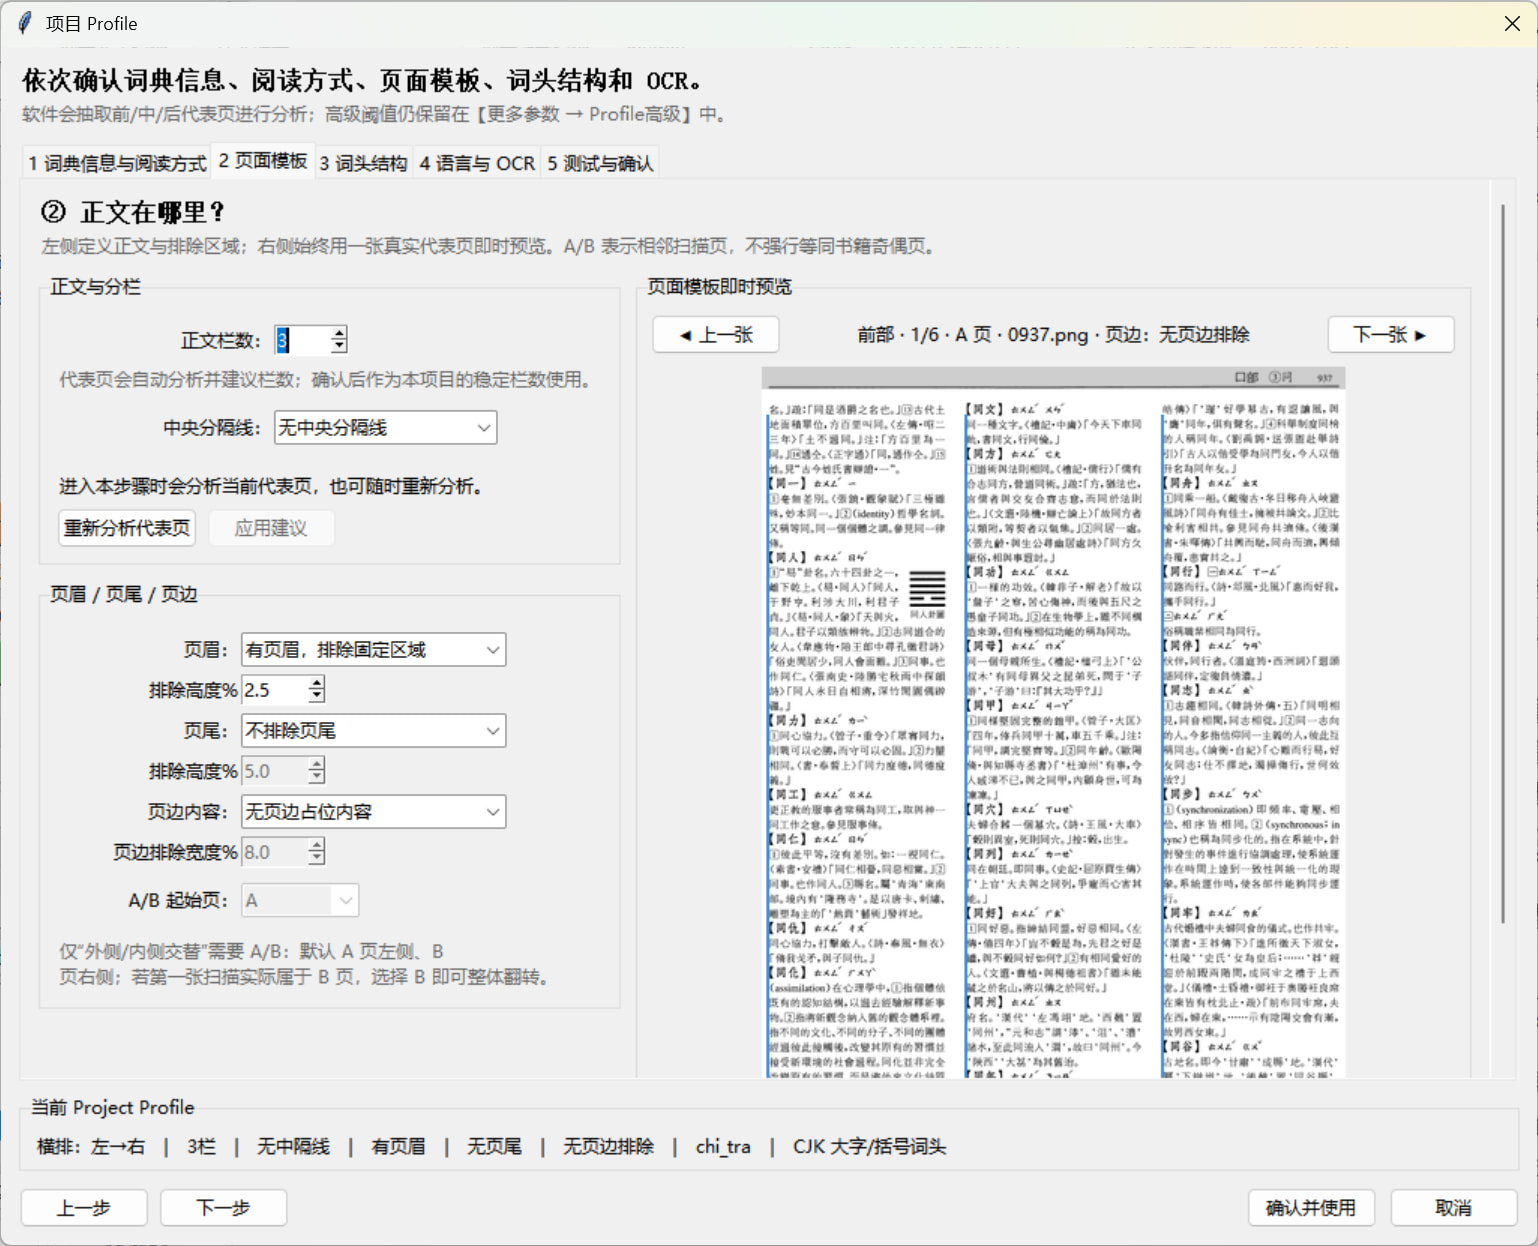
初始版本的【项目Profile】,还在重新设计和完善中。
W2K
83
汇报下
估计今晚10 — 12点差不多跑完,效果很不错。
显卡弱?和你用的2天跑完7822頁(3栏)sm差距不小。
但速度对于我个人使用足够了,我免费ocr使用量也就2百、3百頁吧每天。
这个过程中停下看了下,英文的可能更好(只要词头对,出版社印刷厂把关到位)。中文使用外部ocr反溉进去能更快(和现在收费平台中文的ocr准确率还有差距,但内置的也足够好了)
提个添加项建议
頁中或栏中清章节画线(涂抹掉使用)
頁中
栏中
现在 项目Profile的Wizard里提供了项目统一的页眉/页尾/页面两侧的设置,
切图有考虑不同的页尾/页头专项设置;
现在你说的这个“不同页面不同位置的页中特殊处理”倒是没有考虑到,这倒也会影响切图的正确性:像你第一张图里,阅读顺序都改变了呢~
这个建议非常好~ 之后改进,今天我会发布一个这几天大幅改进后的版本,使用引用等方面都改善了。
W2K
85
改变就对了,要是能像图里示意的走位顺序就再也不用每次挑出来先记录下、最后再手动调整顺序了。
A、B、C三段各自保持的读取顺序才是对的(虽然很少在一页上出现3段,两段是印刷里常态出现的情况)
看到你WINDOWS任务管理器的截图里CPU占用高,但是也有NVIDIA 的独显吖?
OCR是否设置为GPU?
W2K
88
独显, CUDA是支持的,我这个760太老了,好多主流的应用都抛弃它这个型号了  。
什么情况?
刚想看在在哪设置GPU就弹出个这个,重新开始还这样。我大退下看下
你现在的版本,可以先在【普通版面参数】那里有一个检测引擎的按钮。
如果CUDA支持,就可以安装GPU相关的支持组件,PaddleOCR就会更快吧
W2K
91
收到
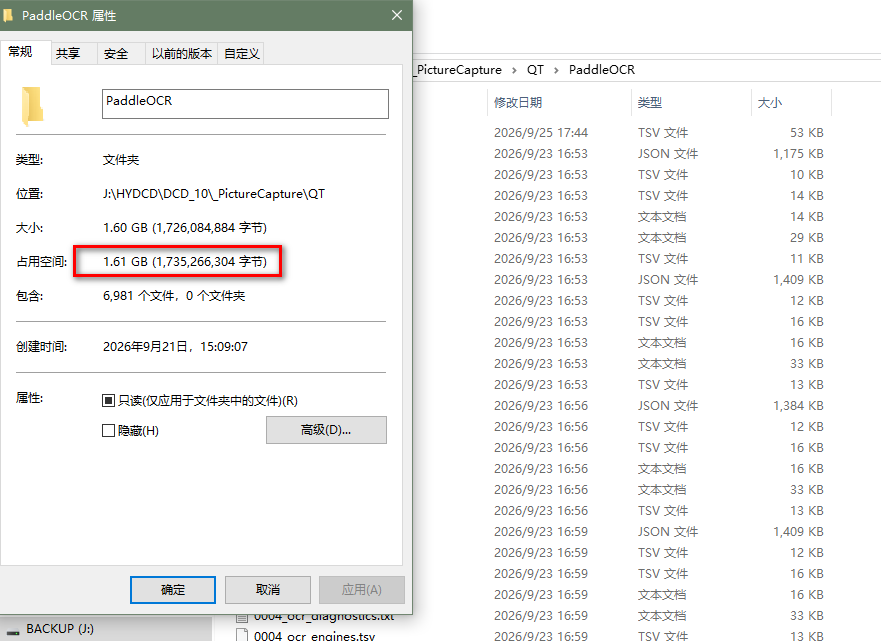
突然停了,原来是这个生成的文件不小。像我这样磁盘空间小的尽量提前预留好充足空间,要么挂机它就白跑了。
这个OCR的文件接下来应该要优化,我这里这个文件夹30GB,之前看到我都愣了一下。
W2K
93
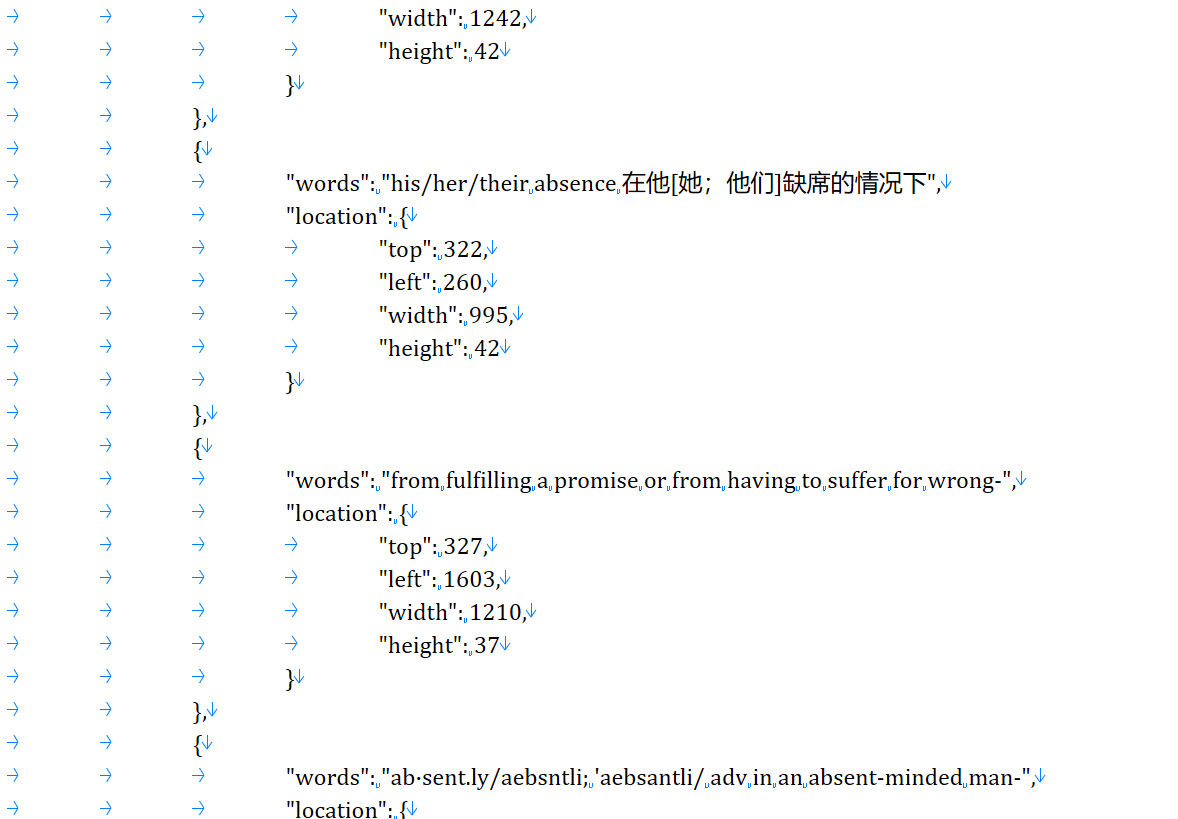
觉得应该有用,好多OCR的网站都是这些.json供你下载,携带完整的页面信息。
这是百度的(虽然各个平台样式呈现的不一样,我不懂具体.json啥意思,但双层图片上层有文字有了它对位精准,我还原过这些.json里的位置信息都可以用得上)。
PaddlePaddle能做到啥样没用过,对于你后期想进一步添加这个功能给个接入点应该可以直接用上吧,猜的。
PaddleOCR画线的设计之初就是将单栏的xx%候选区域(尽可能少,包括绝大部分词头区域就行,一般我都50%以下)整个拿去OCR,得到你图中这些信息。对我们画线有用的信息就是文本+位置信息+单行本文box的大小等,后续相关的画线/正则提取/判断等也都是基于此;)
只是觉得应该优化结构,减少文档大小,因为实在太大了。
W2K
96
见你这个  。
瞬间懵,有点大啊。为了扣图不再4点怼我也要跑一下 
插图识别大小测试了么?估计也小不了。跑完再看吧
没必要折腾,这背后都是temp,界面上的内容看到就行了 ;)
已经着手解决这个问题,这个 SECTION 属性纳入页面属性考虑,整个工作流就会按照我们阅读的正确顺序来: Section1, Col 1, Entry 1 …
词条排序和整词条切图都只走同一套 SECTION → 栏 → SECTION 内Y位置 处理顺序