最大的独和词典,16万词条和18万用例,1万音频,转换自monokakido(是老的dump数据,后面有更新但应该不是增加词条)。
下载:
通过网盘分享的文件:小学館 独和大辞典(第2版)
链接: 百度网盘 请输入提取码 提取码: 1234
或
小学館 独和大辞典(第2版) - FreeMdict Cloud
最大的独和词典,16万词条和18万用例,1万音频,转换自monokakido(是老的dump数据,后面有更新但应该不是增加词条)。
下载:
通过网盘分享的文件:小学館 独和大辞典(第2版)
链接: 百度网盘 请输入提取码 提取码: 1234
或
小学館 独和大辞典(第2版) - FreeMdict Cloud
感谢转换,这本算是独和里面唯一发音没什么问题的,其他的クラウン和アクセス都有点问题例如Lob
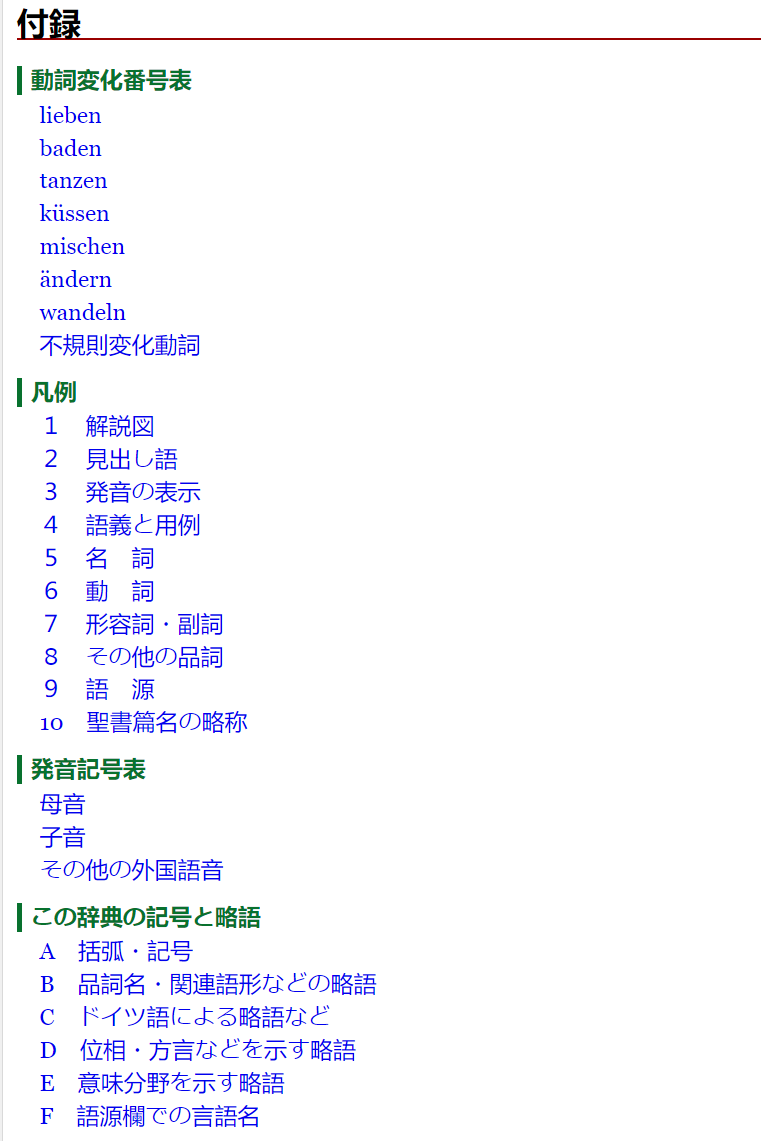
üppig, Üppigkeit查不到,而uppig, uppigkeit则是又跳转到üppig, Üppigkeit
深蓝翻了下,确实有,但深蓝和DictTango上搜索这词就是不显示结果都,不知道会不会跟之前日语一样,像が一样,是两个字符拼起来的? 因为我看其他词典能显示这俩词,所以软件应该没什么问题
太感谢了!他应该没有增加新词条的更新了吧?毕竟,在增加新词条之前,至少应该把2004年新正字法加上,而我用过的物書き堂版本里面是没有新正字法的。
新正字法是德国文化部长联席会议于2004年6月4日决定的德语书写规范,自2005年8月1日起全面实行。该字法基于德国、奥地利、瑞士与列支敦士登签署的协议,经过7年过渡期后取代旧正字法,旨在简化拼写规则。
新正字法_百度百科
《独和大辞典》〔第2版〕1997年出版的,当时新正字法已经在计划中了,但《独和大辞典》〔第2版〕好像没赶上。
monokakido在2024年3月1日更新了这个词典的2.0版,不知道更新了什么内容,论坛dump是2023年的,版本号1.5.2,不知道改了什么
使用GoldenDict-ng的话,可以在编辑-首选项-高级 中 勾上 「搜索时忽略变音符号」。
就是搜索schon或者schön的时候schon和schön的结果都会展示。好处是有些有问题的词典,比如说《三省堂 クラウン独和辞典 第5版》搜uppig也能找到üppig啦。
我在手机上查词
原来是手机
你可能遇到了ICU问题
AI的说法:
结合你描述的现象——“uppig”能跳转到“üppig”但搜不到,这指向了几种可能性:
- 词典文件的编码方式:你使用的
小学館 独和大辞典(第2版)这部词典文件,其词条很可能使用的是分解形式的ü(即u+̈)。而你在搜索时输入的是预组合形式的ü。- 软件对 ICU 的利用不充分:深蓝词典和 DictTango 在处理搜索时,可能没有完全启用 ICU 的规范化或语言敏感搜索功能。
- 没有进行规范化:软件没有将你的搜索词(预组合
ü)和词典中的词条(分解ü)进行统一,导致它们被当作两个完全不同的字符串,所以搜不到- 缺少语言感知的搜索:即便进行了规范化,如果搜索逻辑没有针对德语进行优化,也可能无法将
uppig(无变音)正确匹配到üppig(有变音)。它可能只是做了简单的字符替换(比如将u映射到ü)来实现跳转,但这并非真正的语言智能搜索。作为对比,GoldenDict-NG 能搜到,很可能是因为它对 ICU 的利用更彻底,在搜索时正确地进行了规范化处理。
手机上我就把MDict格式的词典转换成stardict的格式,然后用安卓版的GoldenDict Mobile查了。
我还改过德文的Hunspell文件:
遇到字符的变体(比如日文的半角片假名)可以使用Hunspell的 ICONV:
看来被我猜中了,之前看日语区帖子里出现过这问题
新版GoldenDict-ng使用了ICU(International Components for Unicode)库。我之前下载的Windows版的新版GoldenDict-ng,运行就提示缺少icu.dll。查了下这个动态链接库在W10LTSC1809中还不存在,后来的W10/11才自带。于是去网上下载了一个补充到安装目录,成功运行。应该是新版GoldenDict-ng使用了新版本的Qt,新版本的Qt引入了ICU(International Components for Unicode)库,所以xiaoyifang只要用新版Qt编译,GoldenDict就会自动判断 分解形式的 ü(即 u + ̈)和预组合形式的 ü等价吧。而你用的其他辞典程序无此功能。
如果你是自己打字查词的话,那只需要编辑辞典文件,都搞成你键盘布局/输入法中有的那个组合形式就行。但是如果要翻译网络上的文本,那就应该选用有使用ICU库的辞典软件,毕竟网络上的文本,两种组合形式都有可能出现吧。
网页、PDF、邮件里的文本来源五花八门:
· 从 Windows/Linux 或现代标准网页复制的文本,通常是 NFC(预组合)。
· 从 macOS/iOS(如 Safari、邮件) 复制的文本,系统默认转换为 NFD(分解)。
这意味着你划到的同一个德语词,可能今天是 ü (NFC),明天就是 u + ̈ (NFD)。
如果不用ICU(比如深蓝/DictTango的旧机制):
划词翻译只是“机械地”把获取到的字节拿去索引里比对。当索引是分解(NFD)而划到的是预组合(NFC)时,字节对不上,就会毫无反应。你无法控制网络上文本的编码格式,所以这个问题无解。
为什么 GoldenDict-NG 能做到“治本”?
它不依赖系统输入法给出的格式,也不依赖网络文本的原始格式。它的 ICU 处理逻辑是在查询(Lookup)的最后一刻强制执行的:
这样一来,输入的格式随机性问题在比对前就被“抹平”了。
不知道你说的发音问题是否是umlaut?那个可以vibe coding出Python脚本修正。
我想这个应该是Auslautverhärtung的问题ʕ º ᴥ ºʔ