将作大匠
41
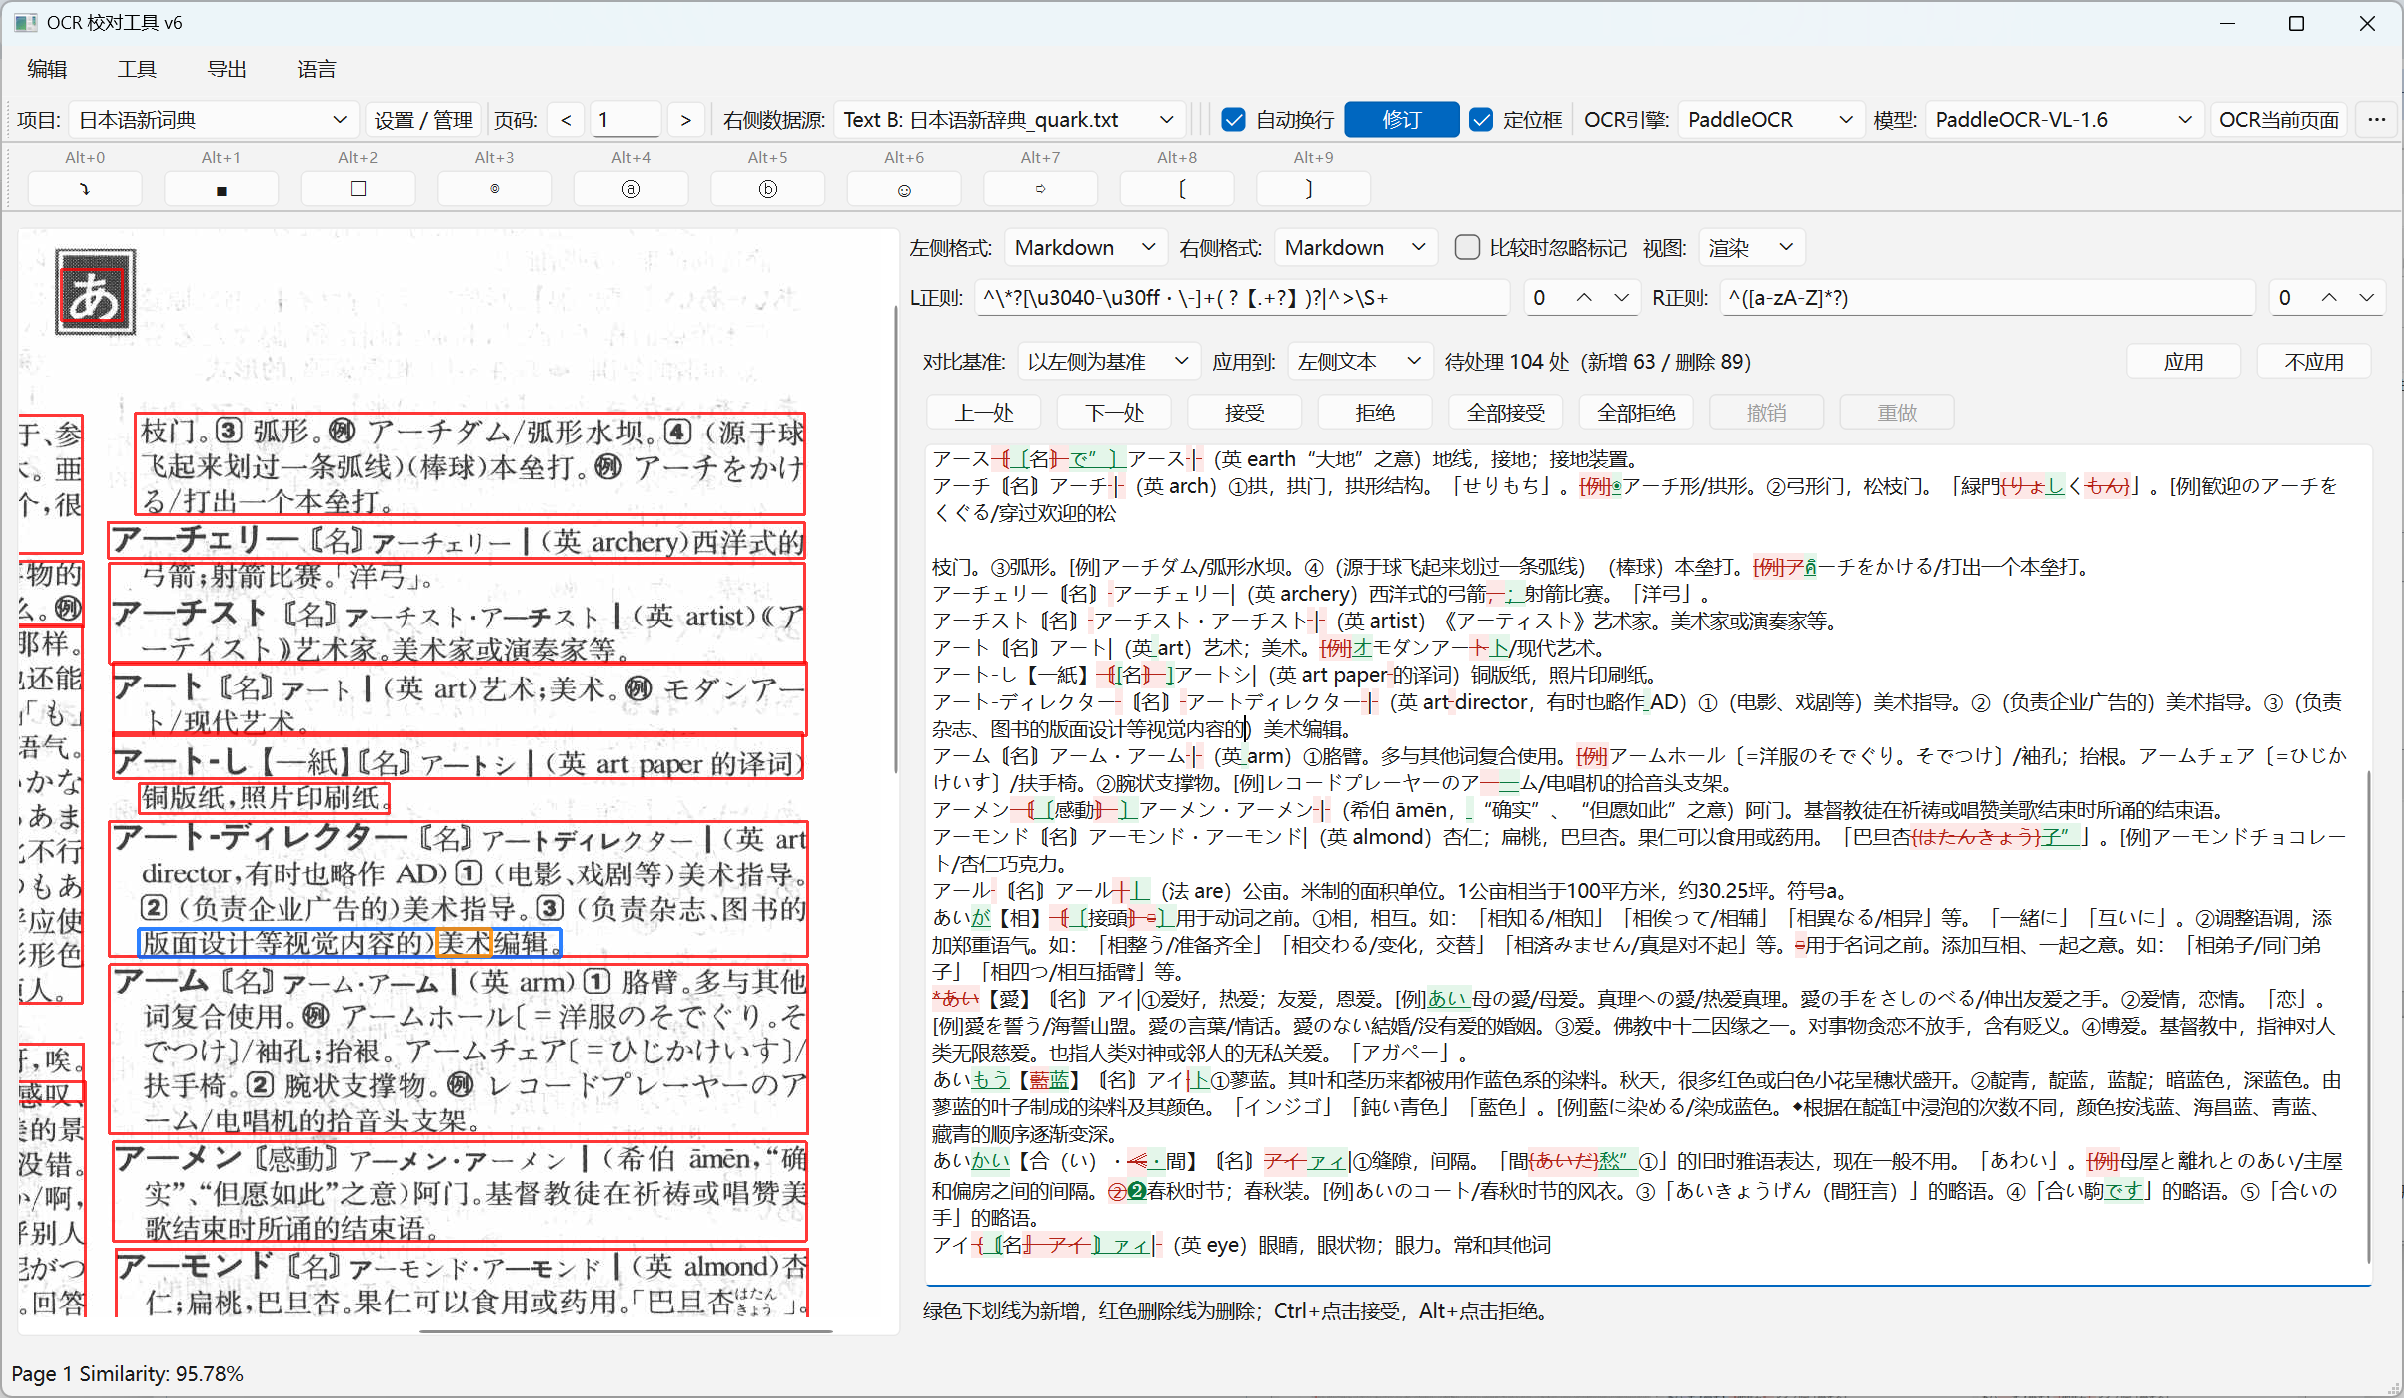
楼上没说全,abbyy还有一个长处,是你滑鼠光标停留在文本层中某一待修改字符前后处时,下方会有一个窗口迅速追踪定位到图片层对应字符所在行,勘误效率提高不少。同时,还可以借鉴WPS审校的异源文本的复叠校对,在同一个窗口通过删除线下划线不同字体颜色直观呈现不同ocr文本的字句差异,再辅以WPS所不具备的自动批量替换功能就更好了,比如A版ocr文本惯作“毒”字,B版ocr文本惯作“毐”字,可以进行预置性的批量订正(准替换,仍保留A/B版本的差异字符,只是通过不同字符底层色块体现字符订正),不仅当前校对页面点击差异字符组中的正确字符进行判定标记,随着校对推进,当跳转到其他同样差异差异字符组时,也已经预置性地对同差异字符组的正确字符进行判定标记。这时候可以根据上下文迅速判断是否准确,若正确的话不同再点击修正,减省鼠标点击操作。做到这几点,再完善本地存储功能,就差不多到商业级应用了
定位到图片层对应字符所在行这个要看ocr引擎能不能返回行级别的结果,paddleocr不支持,有些传统的ocr引擎支持。
重叠校对9楼的版本实验过,但这个模式是不支持直接编辑文本的,因为非常容易出bug,wps在这个模式支持编辑文本吗?目前没合并到主分支
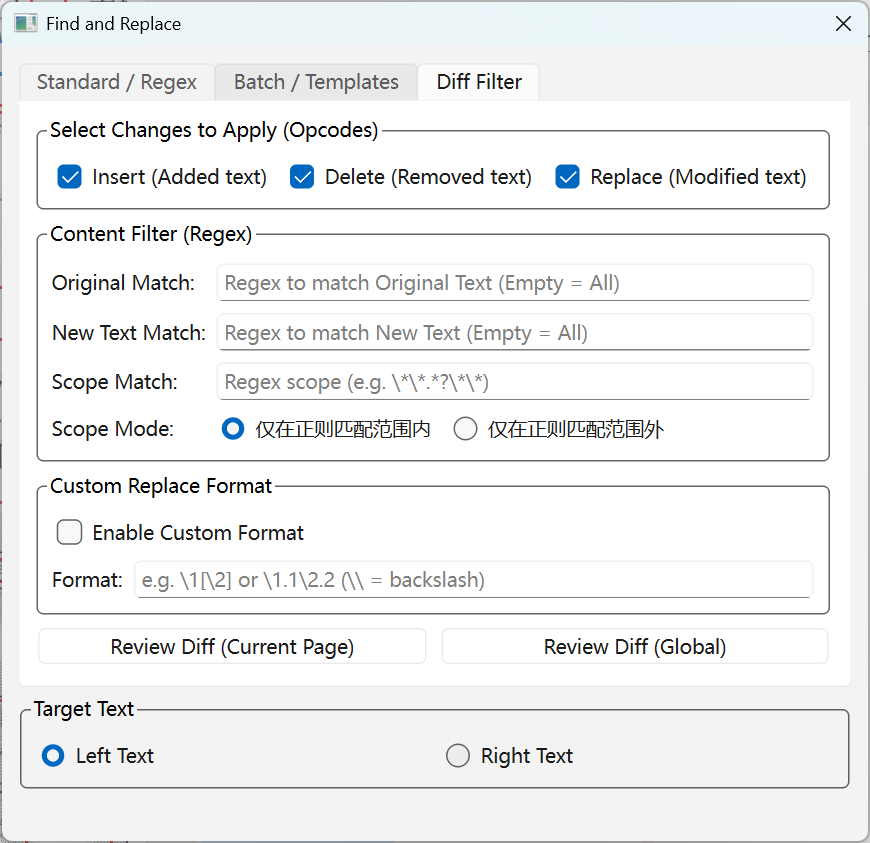
然后预替换这个不支持,但预览窗口是支持类似功能的,就是搜索差异功能,比如中日字体差异对対
选review diff后会弹出预览窗口,然后打勾的是要替换的,会显示上下文,然后双击其中一条可以定位到所在页的位置
将作大匠
45
嗯嗯,wps支持的。目前来看abbyy和wps都有一些功能难以取代啊 
jackki
46
等abbyy哪天发布17把ocr引擎换成AI吧,现在abbyyocr单一语言还勉强能凑合着用。
识别结果要看引擎啊,paddleocr识别率还不错,这个工具主要功能是对比校对,不是识别。
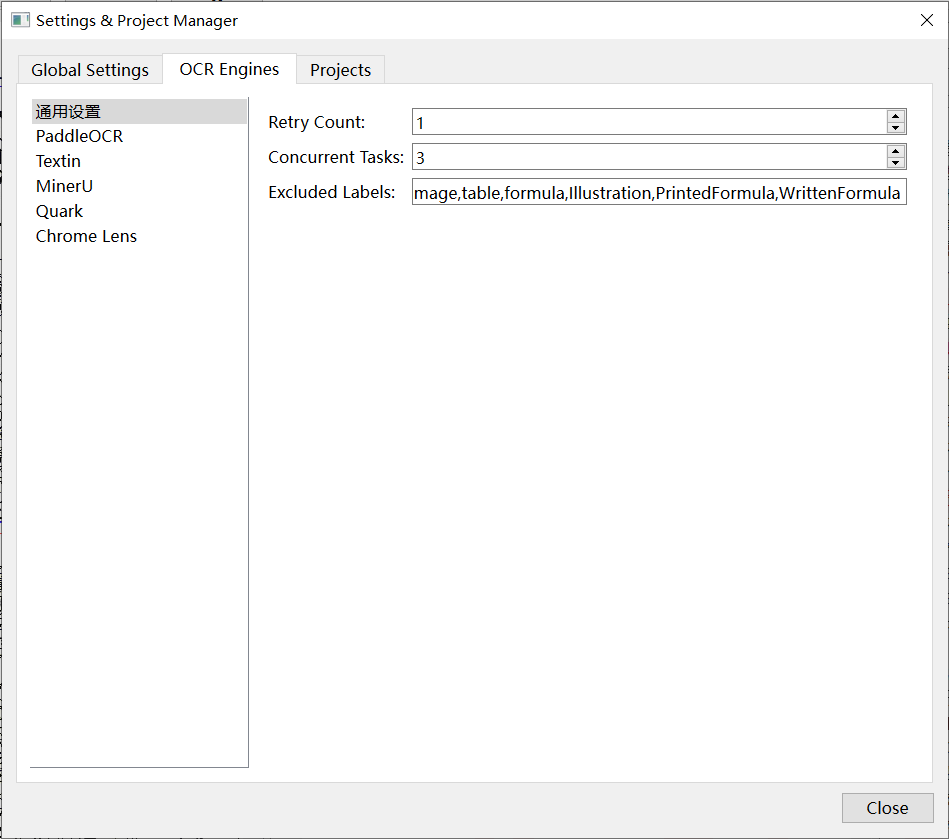
更新新版本 0.6.10,修改配置选项,现在paddleocr不需要填写url了,只需要填写token,自动支持v1.6 v1.5 ocr和ppstructure,采用新的异步api,可以选择重试次数和并行任务数。
furigana功能在安装jamdict的情况下可以自动分词,给每个字添加注音。
更新新版本 0.6.11,增加词头对比工具和页面相似度对比工具,用于检查ocr质量
txt有格式要求的,每页前面必须有<1> <2>这样的页码标志,否则程序不知道是第几页,而且页码要对应,比如你这个第71页才是实际第1页,设置的时候页码偏移就要填71-1=70
竖排繁体,WPS和AI本地工具效果都不太好。
要求高的可考虑收费的合合。
或者可以用 abbyy 试试看
重大更新版本0.7.0,现在支持多个OCR引擎,包括Chrome Lens(chrome浏览器内置引擎,免费),MinerU(免费),Textin(收费api),Quark(收费api)
如果ocr引擎支持字符级位置信息,会更准确的定位
效果演示(注意这里夸克对竖排文本完全不支持,合合能识别但阅读顺序全乱)
更新 0.7.1,现在可以选择OCR来源,导出OCR时可以支持选择从哪里导出文本。
设置可以配多个文本B的路径:
Vim
57
赞!专业!不明觉厉!使用场景需要挖掘挖掘,看看怎么发挥这个神器。
为了更好修订日本语新辞典,再加上最近gpt给了很多重置次数,终于完成了重大改进,版本号直接升到0.8:
演示效果
视频上传失败了,稍后再传
如果配置了输入来源是chromelens的话支持按行和字符分段定位,支持从图片的反向定位
重新实现了修订窗口,支持修订时编辑
增加了对markdown和html的支持
查找替换窗口在查找差异时的bug都修复了,而且可以选择查找不在范围内的差异
furigana支持选择格式,支持选择是否拆分,支持平假名或者片假名。
将作大匠
59
越来越有趣了,下次可以试试学术类书籍的扫校任务场景。我最近也在琢磨。这类书籍往往有标题、本文、脚注、尾注、图表等版面要素,尤其是页与页之间的脚注,扫描时常常是夹杂在本文与本文之间,怎么个校正定序也是个问题
我其实是按实际需求开发的,支持html后接下来就可以加入可以直接让原文件和已经做好的mdx校对,另外我还准备加词头校验功能和增强做图片词典的功能,现在图片词典不能手动调整自动切分错误的词条。脚注这些可以依靠ocr返回的类别确定,但怎么处理还是需要分情况的。