有些部分很确定,很好改。但有些部分,其实还是很有商榷的余地的,有越改越错的风险。特别是,当引入中文翻译的时候,比如使用一个冒号还是两个,需不需要按照法语标准在冒号、问号、感叹号等等符号前后都加空格。另外,我刚刚查了,法语有很严格的符号使用指南,也有前前后后的多次修订。不过,我学法语确实还不到程度,所以主要是试着理解,而不够纠错能力。真要改得很好,便是个高手的严肃学术活动了。也因此,图文对照版便更为重要了。
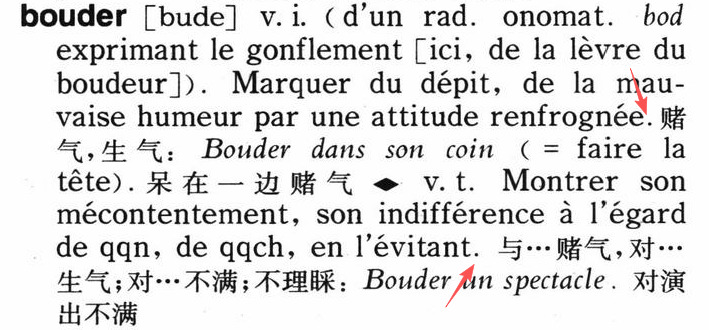
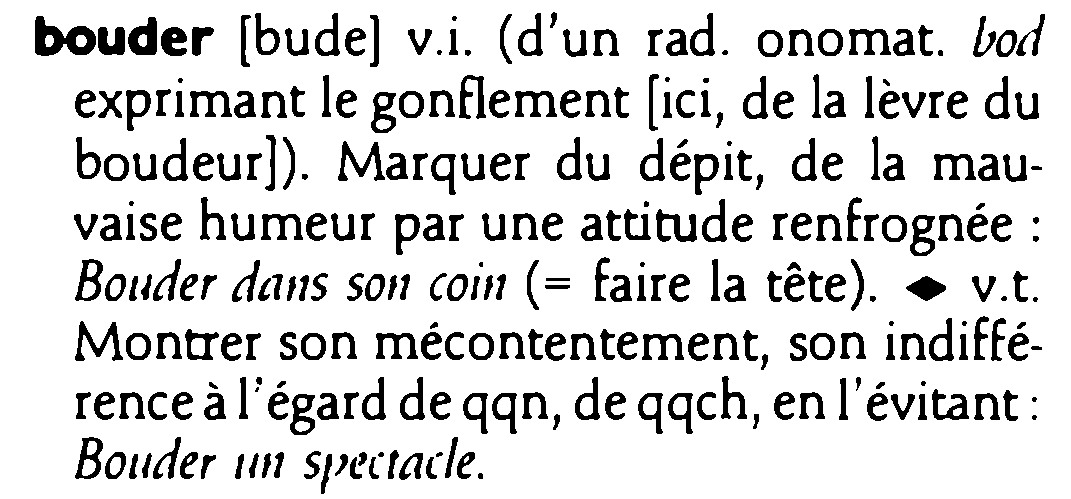
我不知道这有啥重要的,正在编辑的还是json文件,就不存在扩词头的问题,乱改了程序都没法用了,索引对不上。
真正动手在这里做词典的有谁无知到需要教这个吗?当前需要有人把几千个程序对比查出来的标点错误对照图像改好,然后在github上发一个pr,那可就省大力气了。你自己把这些需要扩充词头的单词总结整理清楚搞一个列表贴上来,也比发这些有用。
这个扩充问题要完全正确处理比较复杂,有加后缀的,有用ou或者et分开的,有在后面单独分一个黑体条目的,最后这种情况需要解析才能处理。
image_pos.zip (524.5 KB)
清晰版的图片切割数据,处理了大部分问题,目前还有6页存在问题(pdf页码,从1开始):
610,1127,1142,1328,1609,2093
辛苦了,有了这个新数据处理标点问题会方便很多,旧图像很多标点肉眼都看不清,就很难纠错了。
支持,期待成果中。。。
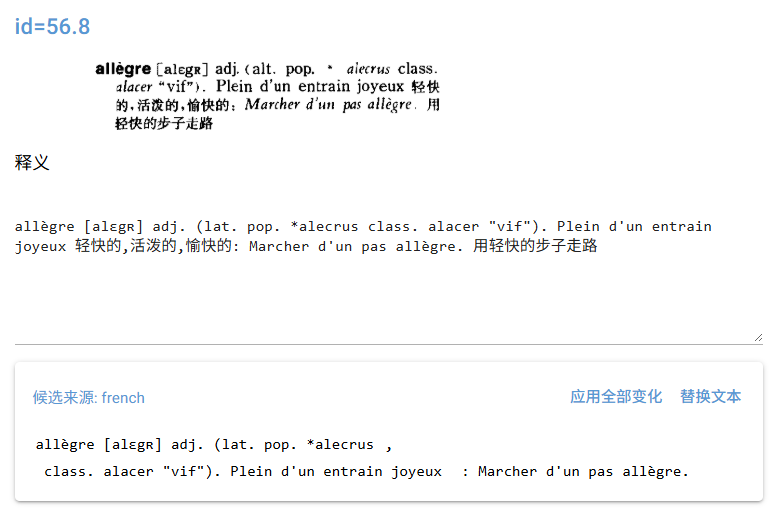
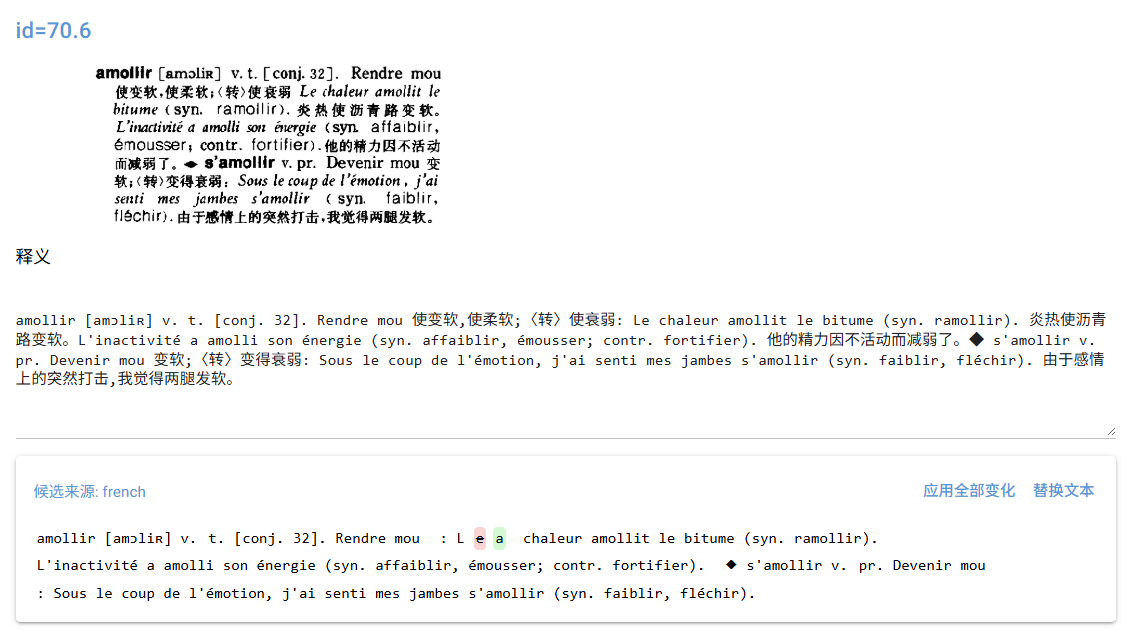
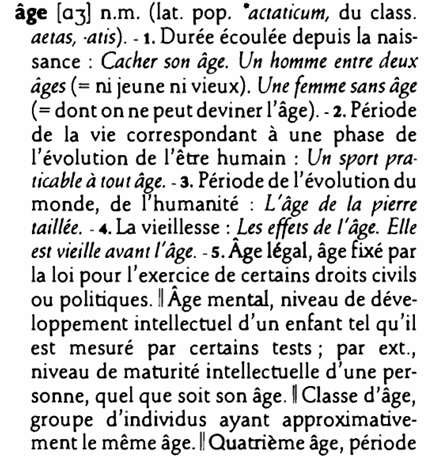
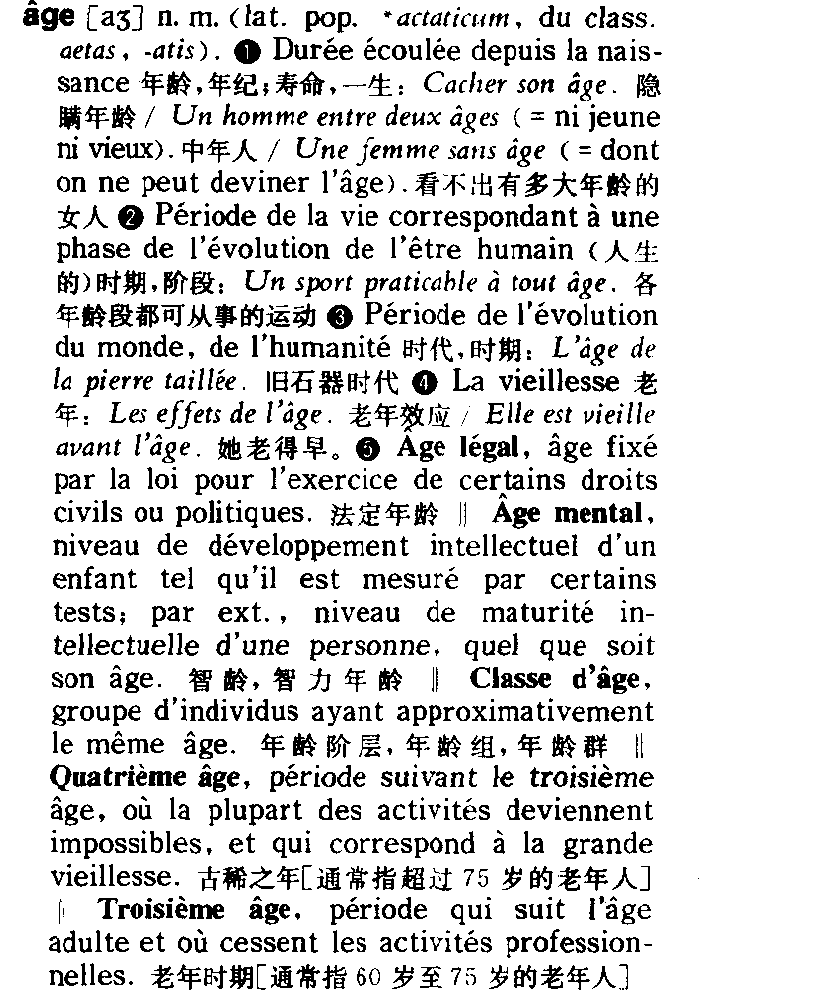
拉鲁斯双解版词典我估计至少有上千处错误,当时编书的时候应该没提供电子版之类,都是打字员手工录入,加上校对粗疏,错误难免了。不过我们的目标是此电子版词典从无到有,从有到基本可用,把一些明显的看不过眼的讹误改了就行了,用不着追究完美。以前我对错别字这些挺敏感,ai兴起之后,感到其实也无所谓,文本只是token而已,不值钱,ai可以几分钟输出几万,LLM对文字、语法错误等也根本不在乎,只要不是太离谱,超强纠错,完美理解。就是学法语、外语本身,也似乎变得多余和可疑了。

从 chatgpt 3.5 算起的 LLM ai 才发展了三年,说幻觉、错漏挥之不去为时尚早,大多数人的幻觉、错漏也挺多的,它可是进化了百万年,或者至少20-30万年的产物。chatgpt 刚开始连 3+8 是多少都算不对,而现在则拿到了奥数金牌。
再好再先进的ai是什么,我们还不知道。不过 LLM 有三个特性是人脑无法匹敌的:一,它的“神经元”(参数)理论容量是无限大,而人的大脑就限制在1000亿个神经元;二,它可以永生;三,它的边际复制、繁殖成本是零。可是人呢,活150岁也是死(至少目前),繁殖、再生产的成本很高。
人学外语,有不同目的。有的是实用,获取信息,跟人交流,在这方面 ai 基本可以替代了,没有真人可以流利使用100多种语言,但 LLM 能够做到。有的是消遣娱乐,对语言本身感兴趣,那 ai 的确没法替代你自己感受和爽快。
法文版、双解版的原书图像pdf等链接都在这个帖子里,自己都不去下载,谁来一对一专门对你服务?况且无论法文还是双解的原文nick都已经贴了,就是如图所示。

你都懒得下,怎么我又不是懒得”发一下原书的缩写“,而且我实际已经贴原书了,nick也贴了原文。
这些问题越问越奇怪了,主帖的TXT文件里开篇就有这些缩写。
多谢提醒,之前没有注意。
这个好像确实不太好处理,我先写个代码提取下普通的吧


