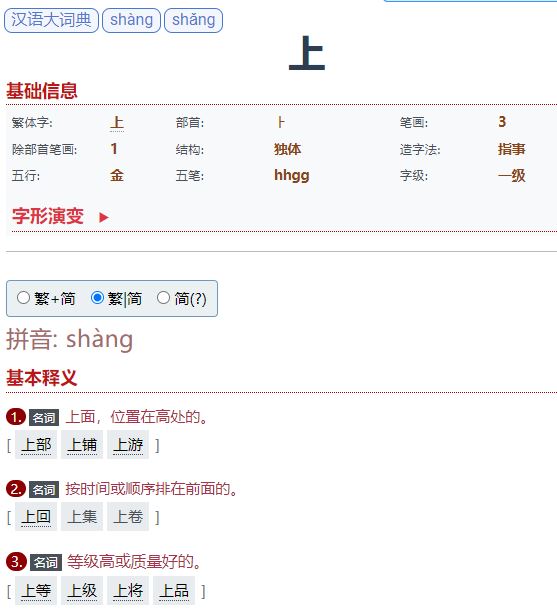
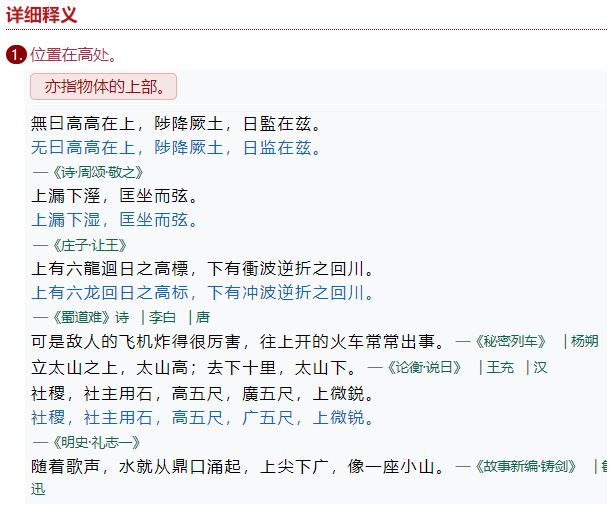
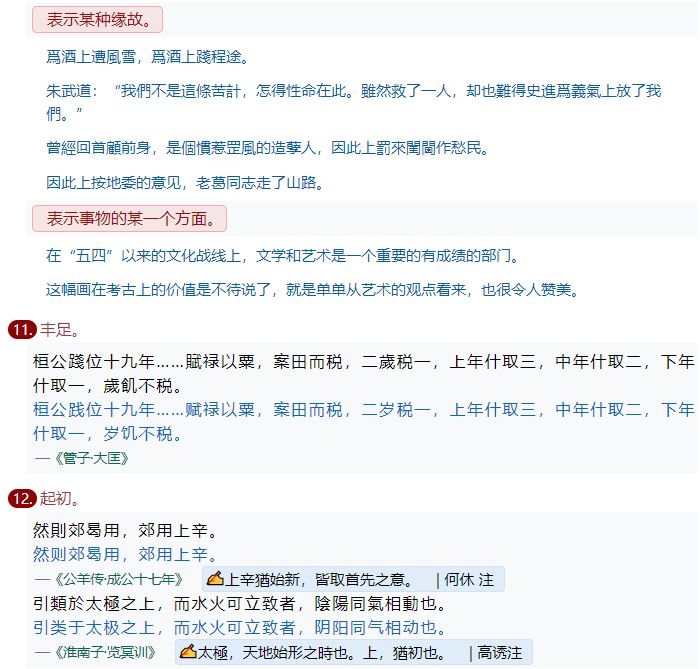
更新了,主要是按时间顺序排列了字体演变。
采用了@knetxp的微调css。
search “.highlight” in the css and comment it out.
kking
66
㐀2.txt (203.5 KB)
㐀.txt (5.5 KB)
一个古汉语,一个现代汉语,
哪个字典?
不要做任何整理,越原始越好。
HDC之前的数据被“处理”出来几百个malformed json,还得花时间修复,不是折腾么。
kking
69
专业的事还是得交给专业的人来处理,我就三脚猫的功夫,只会照葫芦画瓢
kking
70
我早就发现这个手型的问题了,我尝试自己处理,不成功,总是会跑偏,直接去掉结果版面都花了, 
slgns
72
这个条目的释文和例证位置错乱:
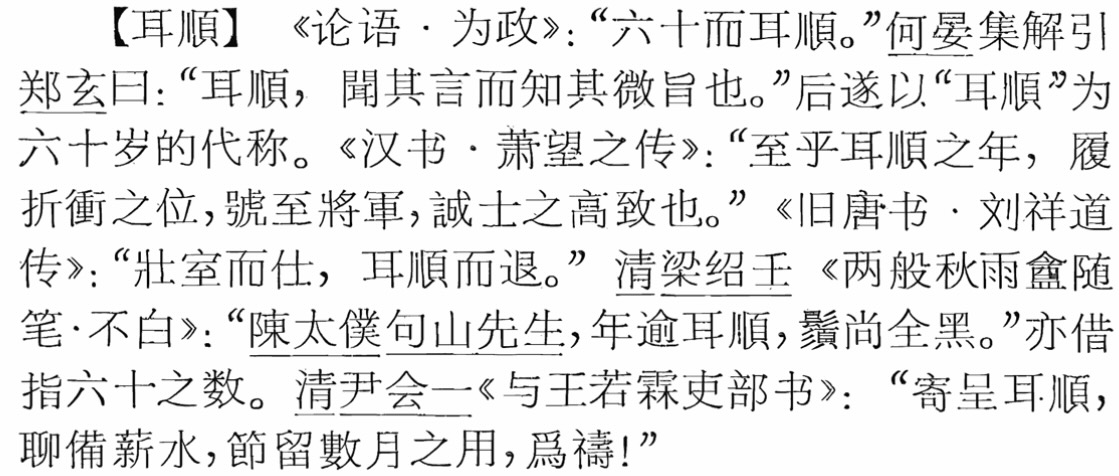
原书图像:
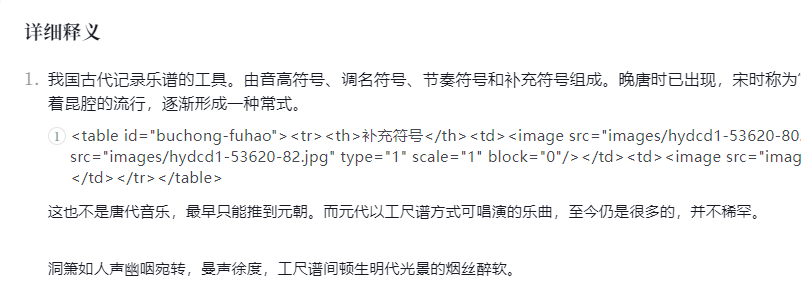
另外“工尺谱”条中似乎有个表格,目前我这边看是错乱的,不知有无可能修复?
kking
73
这些释义缺失,例证缺失,顺序问题,都是“源数据”的问题,电子版只能供参考,
knetxp
78
对css进行了一些调整,
顶部的按钮应该用不到,直接 去掉,
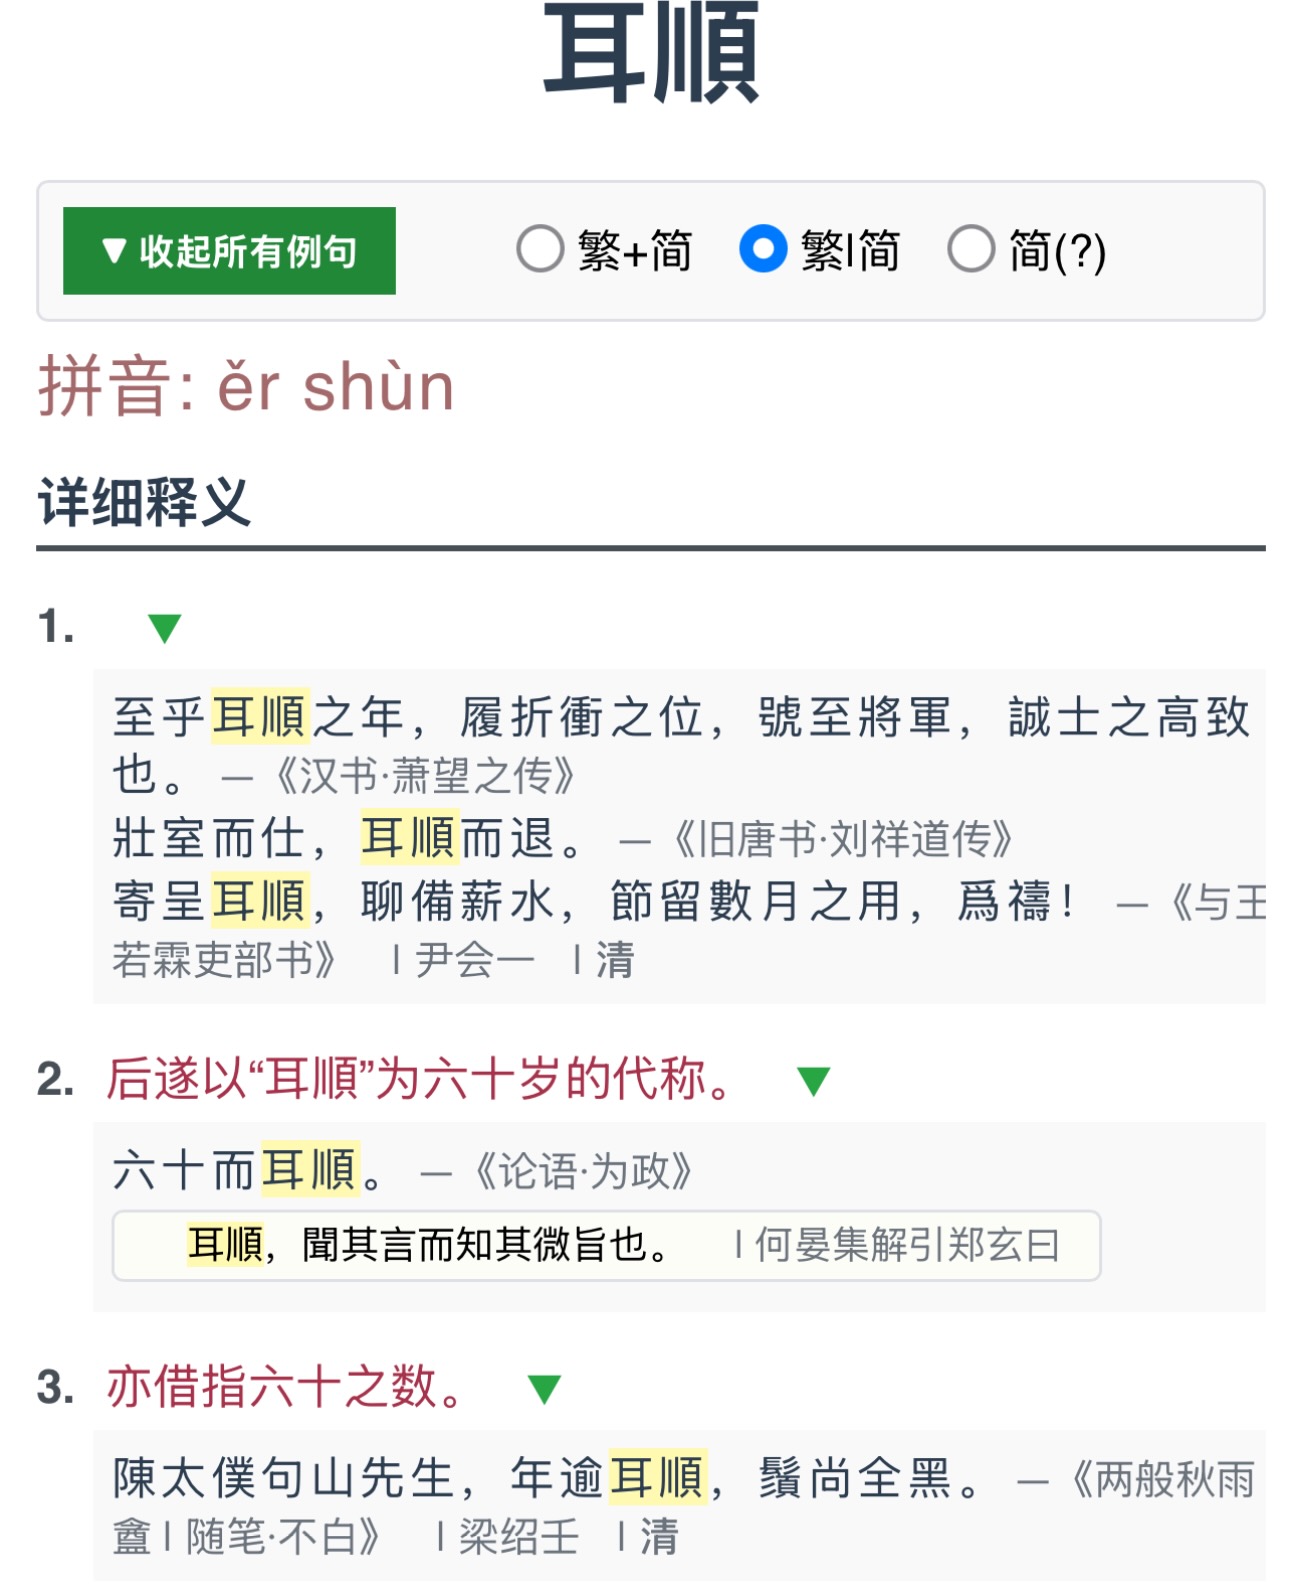
例句全部显示,默认中间的繁|简,(为何选择简体的时候例句不如繁体多?)
其他字体大小和颜色
另外,
rygg.rar (4.5 KB)
kking
79
补充符号\u003c/th\u003e\u003ctd\u003e\u003cimage src=\"images/hydcd1-53620-80.jpg\" type=\"1\"
源数据就是如此,不是私有字处理的问题
如果连json格式都不符合了,怎么可能不是处理数据的问题。原始数据不可能连最基本的格式都不对。
kking
81
我明白了,你说的是数据损坏是处理数据造成的,我说的是这个数据损坏责任方不在我们这边,也不在sxingbai那边,因为拿到的“源数据”就已经是这种了,